8.5 流水线与实战:从菜单到出餐的整条线
8.5 流水线与实战:从菜单到出餐的整条线
本节摘要:收官之战——把八章手艺串成一条流水线:抽、验、洗、切、熬、合、出七站各司其职,配幂等、校验闸、清洗台账三个设计模式,再用一份真实脏订单数据从头跑到尾。承接全书手法,这是"会做菜"到"开得成店"的最后一站。
一家零售公司的月末之夜
一家零售公司的数据组有个传统:每月最后一个工作日,全员守着脚本跑月报——因为那条"流水线"其实是几十段复制粘贴的代码,谁也说不准哪段会翻车。真正的流水线长什么样?工序固定、站站有验收、跑坏了知道坏在哪站、重跑不产生副作用。本节先给出这条线的骨架(抽取、验收、清洗、整形、聚合、合并、导出)与配套的设计模式,然后请出全书的毕业考题:一份真实脏订单数据,从原始文件到汇总报表,一步一步走完全程。往前接八章全部手法,往后,你带走的是一条可以照抄改写的出餐线。
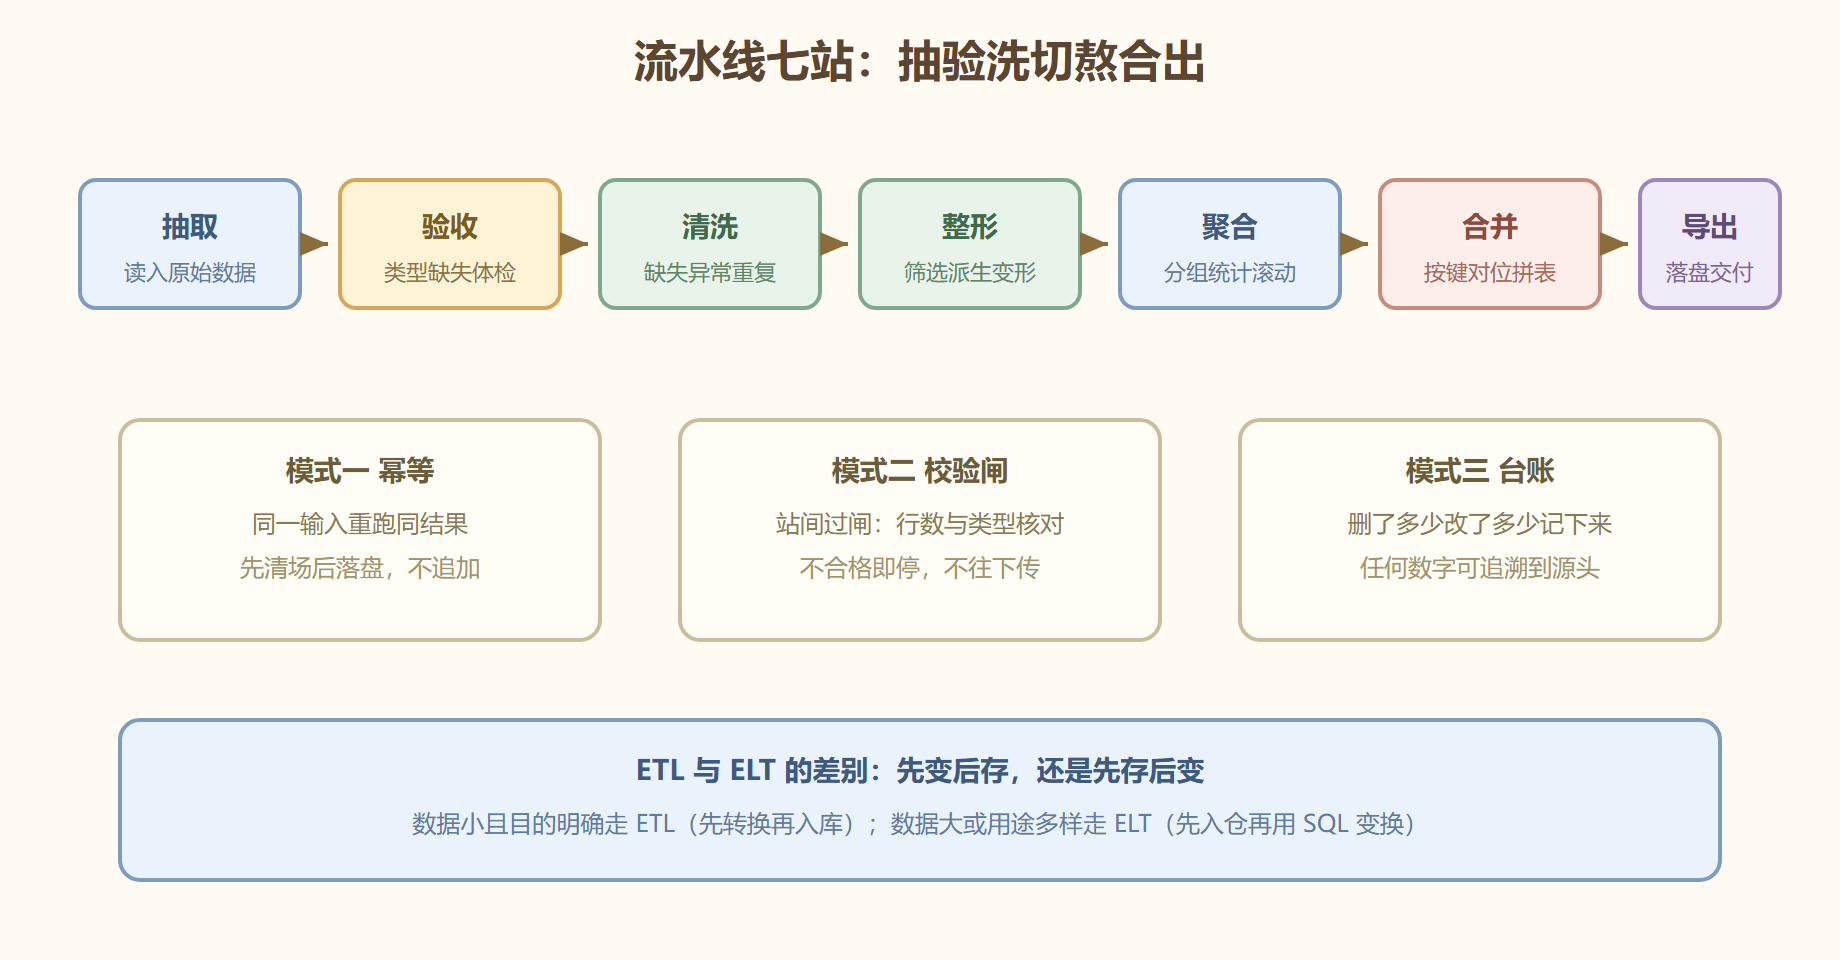
图 数据流水线全景:七站与三模式
参数拆解:七站的站间契约
流水线不是把代码连起来就完事,站与站之间要有"契约":每站的输入是什么形状、输出承诺什么结构、坏数据怎么处置。落到写法上就是三条——每站一个函数(入参出参明确,单站可测可重跑);站间过闸(行数、键唯一性、关键列非空,断言不过就停);全程台账(每站的行数变化与处置数量写进日志字典,最后落一份清洗报告)。至于转换发生在哪一端:数据小、用途单一,走 ETL,抽出来就转换,转完再入库;数据大、用途多样,走 ELT,先原样入仓,用什么转什么——次序选择本身就是架构决策。
实操示例:一份脏订单的全程实战
毕业考题:一份门店订单表,带千分位金额、重复单号、缺失渠道、离谱大单、文本日期,要求产出"渠道与月份的总额报表"。七站各出一次手,全是老朋友。
import pandas as pd import numpy as np # 第一站 抽取 raw = pd.DataFrame({ "订单号": ["A1", "A2", "A2", "A3", "A4", "A5"], "日期": ["2024-05-01", "2024-05-03", "2024-05-03", "2024-05-08", "2024-06-02", "2024-06-15"], "渠道": ["直营", "分销", "分销", "直播", None, "直营"], "金额": ["1,200.0", "88", "88", "待定", "99,900.0", "210.0"], }) # 第二站 验收(1.1 验收单) assert {"订单号", "日期", "渠道", "金额"} <= set(raw.columns) # 第三站 清洗(2.3 去重、2.4 类型、2.1 缺失、2.2 异常) df = raw.drop_duplicates(subset=["订单号"]) df["金额"] = pd.to_numeric(df["金额"].str.replace(",", "", regex=False), errors="coerce") df["渠道"] = df["渠道"].fillna("未知") bad = df["金额"] > df["金额"].quantile(0.99) * 5 # 离谱大单,台账记名 ledger = {"去重删行": len(raw) - len(df), "金额失败": int(df["金额"].isna().sum()), "可疑大单": int(bad.sum())} df = df[~bad] # 第四站 整形(3.4 时间) df["日期"] = pd.to_datetime(df["日期"], format="%Y-%m-%d") df["月份"] = df["日期"].dt.to_period("M").astype(str) # 第五六站 聚合与合并(4.1 加 5.2) report = (df.groupby(["月份", "渠道"])["金额"].sum() .unstack(fill_value=0)) # 第七站 导出(幂等:整表覆盖,不追加) print(ledger) print(report) # 台账与报表一并落盘,重跑结果相同
注意台账的产出:去重删了行、金额有几笔转不动、大单拦了几笔——报表里每个数字都能顺着台账追溯回原始数据,这就是流水线与脚本堆的区别。
流水线的两种生长方向
骨架跑通后,流水线通常朝两端生长。向上游生长是调度化:把主流程函数交给定时任务驱动,配 8.4 的失败台账与重试,人工跑变成机器跑——这一步不需要改任何处理逻辑,只需要一个入口函数与一份配置。向下游生长是交付化:报表落盘后接邮件或看板,阈值告警接 4.4 的条件计算,让流水线不仅出表还出信号。两端生长都不动"七站"本身——这正是把逻辑封进站函数的红利:站内怎么改,站间契约不变。
def run(config: dict) -> dict: """唯一入口:调度与人工共用。""" raw = extract(config) df = transform(raw, config) # 内含验洗切熬合五站 result = load(df, config) return {"台账": ledger, "行数": len(result)}
入口函数的返回值刻意只留台账与行数——调度系统只关心"成功没有、跑了多少",明细在落盘文件里。入口薄、站点厚,是流水线长期可维护的关键。
坑点与翻车
**翻车一:非幂等落盘。**导出用追加模式,重跑一次报表行数翻倍——出餐前先清场(覆盖写、先删临时产物),幂等是流水线的第一品性。**翻车二:站间无契约。**上游悄悄改了列名,下游在第三天才发现,排查要倒回全线——每站入口先过验收断言,契约破裂当场停线。**翻车三:参数硬编码。**路径、日期、阈值散落在代码各处,换个月份要全文搜索——收拢成配置字典或函数参数,改表不改线。**翻车四:中间结果不落盘。**一站出错从头重跑半小时——把耗时站落的中间结果存成 parquet,调试从断点续跑(存储格式的选择回看 7.4 的建议)。至于规模超出单机的未来,转换逻辑原样平移到 7.4 的大灶台即可——这正是"流程固定、函数流动"的回报。
收档清单
- 七站骨架:抽、验、洗、切、熬、合、出,每站一函数一站一闸;
- 三模式:幂等保重跑,校验闸保断点,台账保可溯;
- ETL 与 ELT:先变后存还是先存后变,按数据规模与用途定;
- 配置收拢:路径日期阈值进配置,改表不改线;
- 中间落盘:耗时站存 parquet,断点续跑省一半时间。
全书至此收官。回到导读那张地图:备料、择菜、切配、熬汤、摆盘、调味、中央厨房、后厨动线——八个站点你已全部走完,剩下的路是把手艺带进自己的数据后厨,按你自己的菜单,出你自己的菜。