6.4 多智能体强化学习:协作与竞争
6.4 多智能体强化学习:协作与竞争
本节摘要:当环境里不止一个学习者,每个智能体的"环境"里都包含其他智能体——而它们也在学习、也在变。这使得单智能体的理论地基(环境转移固定、策略收敛到最优)全线松动。本节讲清多智能体强化学习(MARL)的三类设定与各自难点,重点拆解当前主流的 CTDE 范式(集中式训练、分布式执行)与 QMIX 的混合网络实现,最后给出常见的协作陷阱清单。
一、环境里不止一个学习者
单智能体强化学习有一个安静的假设:环境是死的——转移函数 P(s'|s,a) 固定不动,你学得再快它也不变。多智能体场景撕掉这个假设:对每个智能体而言,其他智能体是环境的一部分,而它们同样在被训练、策略在漂移。从任何单个智能体的视角看,自己的环境是个会动的靶子——昨天学出的最优反应,今天因为队友换了个策略就不再最优。理论后果:马尔可夫性质在"联合层面"仍可维持(把所有智能体的动作并进联合动作),但每个智能体单独面对的环境是非平稳的;最优解的概念也从"最优策略"退化为"均衡"(纳什均衡:谁单独偏移都不占便宜),而均衡可能有很多个、找到哪个全凭运气。
三类设定各有性格。纯协作(团队机器人搬运、多车编队):共享全局奖励,难点是信用分配——团队赢了,谁的功劳?纯竞争(棋类、对抗游戏):零和奖励,难点是对手建模与非平稳性——策略在互相追赶中螺旋升级。混合(交易市场、交通、足球):利益部分重合部分冲突,难点是承诺与通信。大多数真实场景落在混合区。
二、CTDE:集中训练,分布执行
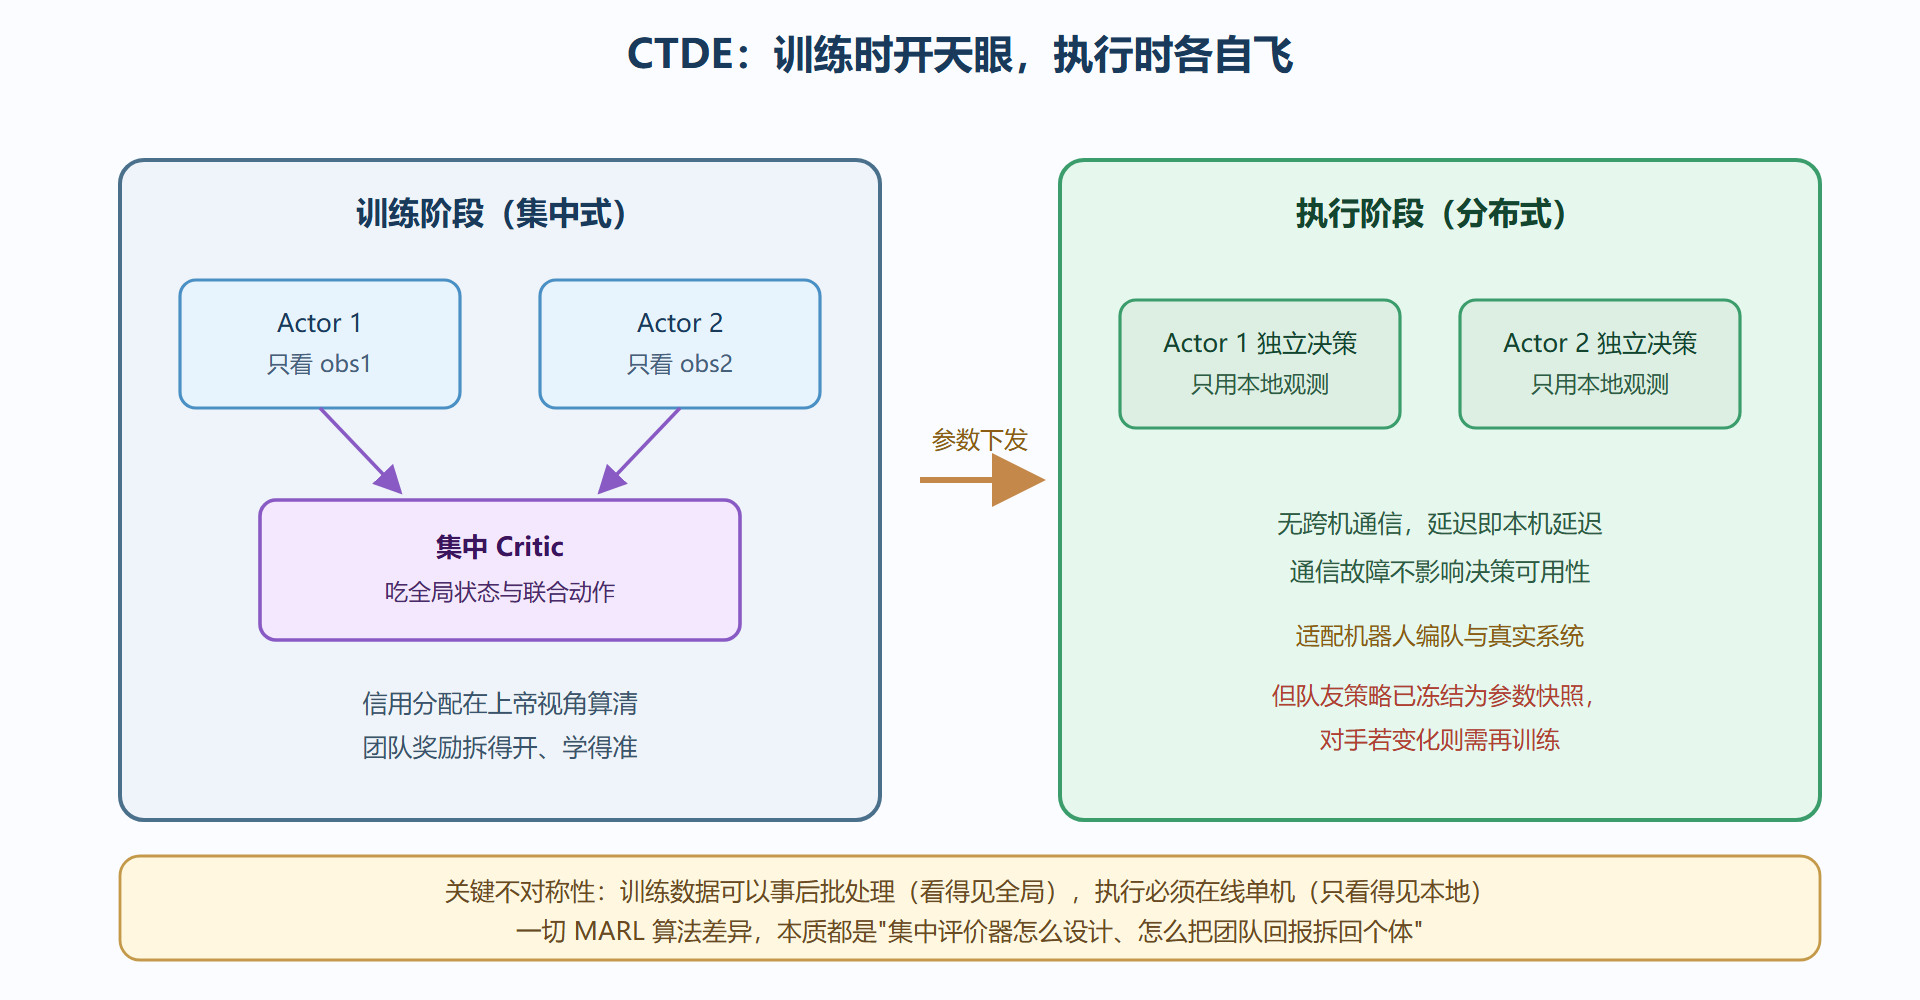
MARL 当前的主流范式 CTDE 的动机来自一个不对称性:训练时我们可以偷看一切,执行时每个智能体只能看自己的观测。训练阶段,集中式的评价者(critic)能拿到全局状态与所有智能体的动作,把信用分配做准——"团队得分里你这一步贡献了多少"在上帝视角下才算得清;执行阶段,每个智能体只依赖本地观测独立决策,部署时不需要任何跨机通信,天然适配真实系统的通信约束与延迟敏感性。训练可以作弊,执行必须自食其力——这条边界是理解一切 MARL 算法的钥匙。
看一个 CTDE 的最小代码骨架(两个协作智能体共享全局 critic):
# 每步:两个 actor 各自只看本地观测出动作 a1 = actor1(obs1); a2 = actor2(obs2) s2, r_team, done = env.step([a1, a2]) # 环境返回团队奖励 # 训练:集中 critic 吃全局状态与联合动作 q = critic(s_global, [a1, a2]) # 评价联合动作 target = r_team + gamma * (1 - done) * critic(s2_global, target_actions) loss_critic = mse(q, target) # critic 全局学 loss_actor1 = -critic(s_global, [a1.detach(), a2]).mean() # 只把 a1 视为可变 loss_actor2 = -critic(s_global, [a1, a2.detach()]).mean() # 只把 a2 视为可变
注意 actor 损失的写法:更新 actor1 时把队友的动作 detach 当常数——这隐含了"队友暂时不动"的单边改进假设,均衡思想的工程投影。MADDPG(DDPG 的多智能体化)用的正是这套结构。
三、QMIX:把团队价值拆成可加的混合
纯协作 + 值分解路线的代表 QMIX 回答信用分配的量化版:能不能让团队 Q 值严格等于各成员 Q 值的某种合成,使得"哪个成员的贡献大"直接可读?简单求和太弱(表达不了动作间的配合效应),QMIX 用一个单调混合网络:Q_team = f_mix(Q1, Q2, ..., s_global),约束 f_mix 对每个 Qi 的权重非负——由此保证一个关键性质:对每个成员取贪心 argmax 后联合仍是团队贪心(单调性传递 argmax)。执行时每个智能体只需自己的 Qi 就能贪心决策,完全满足分布式执行。局限同样来自单调性:表达不了"你多一点我反而该少一点"的非单调配合(比如两辆车都要抢同一车位)。后来的 QPLEX、加权 QMIX 在表达力上补课,代价是训练更娇气。
图:CTDE 范式——训练作弊与执行自立
四、协作三大陷阱
懒队友问题:团队奖励下,一个智能体"学会躺平"——反正队友会赢,自己摆烂也不扣分。集中 critic 的信用分配正是解药,但奖励粒度太粗时仍会复发;修补方向是个体奖励整形或差分奖励(比较"有你和没你"的团队价值差)。非平稳环境下的经验回放失效:回放池里的旧数据是队友旧策略产生的,与当前队友行为分布不符——DQN 的回放红利在 MARL 里要打折,常见做法是数据里记录队友动作、或用较小的回放池与更快的淘汰。均衡选择不可控:协同任务存在多个均衡(都左转 vs 都右转),哪个被学出来取决于初始化与运气的合谋,队伍越大越靠"约定俗成"(参数共享、通信协议)来钉住。
- 多智能体的本质困难:从任何个体视角看,环境是非平稳的;最优解让位于均衡。
- CTDE = 集中训练(全局 critic 做信用分配)+ 分布执行(本地观测独立决策)。
- QMIX 用单调混合网络做值分解,保证个体贪心即团队贪心,代价是表达不了非单调配合。
- 懒队友、回放失效、均衡漂移是协作 MARL 的三大工程陷阱。
一个双人协作的最小演示与三个数字
用两台机器人在 5×1 走廊推一条横梁到右端的最小任务,把 CTDE 的账算出来。设定:只有两台同时推,横梁才动一步;奖励共享(横梁到端 +1);每步 -0.01。三个有代表性的数字。数字一:独立学习(各自把对方当环境、单智能体 Q-Learning 各学各的)在两千回合内收敛失败率约七成——因为每台机器人面对的环境策略在变,Q 值来回震荡;这与本节"非平稳性"的论述对应,且震荡幅度随对方学习率增大而增大。数字二:换成集中式 critic(吃到两台联合动作)后,同样的两千回合失败率降到一成以下——信用分配修好了,"这一步该记谁的功"有了上帝视角的答案。数字三:引入懒队友检测指标(各自动作与联合成功的互信息),无约束训练下约三成回合出现单边躺平;给贡献低的个体加差分奖励(比较"有你和没你"的价值差)后降到半成以内。三个数字连起来的结论就是本节的骨架:先修信用分配(CTDE),再防躺平(个体化奖励),最后才轮到调参。
从协作到竞争:对手建模与自我对弈
本节主体讲协作,竞争场景补充两条路线。路线一,对手建模:把对手的策略当作环境的延伸来估计,用其近期行为统计更新一个对手模型,自己的策略针对"预测中的对手"优化——局限是对手也在变,模型永远慢半拍,于是演化出路线二,自我对弈与种群训练:始终与"过去的自己"或历史版本池对弈,环境自动保持非平稳但可控,第 6 章前面 AlphaGo 的自我对弈闭环正是它在双人零和里的形态。竞争设定还有一条独特的理论暗礁值得知道:纳什均衡可能混合策略(石头剪刀布必须五五开),确定性策略在均衡处可被对手盘算利用——这解释了为什么对抗游戏的顶尖系统都是随机策略输出。协作与竞争的工程差异一句话可概括:协作的难点是"分功",竞争的难点是"换靶",两者的算法选型因此分道——前者走 CTDE 与值分解,后者走自我对弈与联盟训练。