- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
强化学习与智能体训练:从 Q-Learning 到深度强化学习
最初,让机器学会"做决策"这件事,在学界并不算一门显学。控制论学者用微分方程描述系统,运筹学家用规划方法搜索最优解,两条路都要求先把世界的运行规律写成精确的数学模型。可真实世界偏偏不配合:规律未知、反馈延迟、噪声不断。于是有一支研究者换了个问法——能不能不写模型,让程序像幼兽一样,靠一次次试错、一次次奖惩反馈,自己撞出一条好路来?这条路走了半个多世纪,从一张手算的 Q 表出发,途经时序差分、深度 Q 网络、策略梯度,一路走到如今的 PPO 与 AlphaGo 级别的系统。这本教程要讲的,就是这条路上每一块基石长什么样、为什么非它不可。
这本教程的立意:概念筑基,而非算法罗列
强化学习的资料有个通病:上来就贴公式,贝尔曼方程、策略梯度定理、clip 目标函数一锅端出,读者背下了一堆符号,却答不出一个最朴素的问题——智能体到底在学什么?本教程反其道而行。我们把每一章都钉在一条主线上:先建立概念,再引出算法。从"智能体-环境-奖励"这个最小闭环出发,每引入一个新算法,都是因为前一个概念在某个地方断裂了:
- Q 表解决不了状态爆炸,于是有了函数逼近与 DQN;
- 价值方法对连续动作束手无策,于是有了策略梯度;
- 蒙特卡洛策略梯度方差太大,于是有了基线、优势函数与 Actor-Critic;
- 策略更新一步迈太大会崩,于是有了信任域与 PPO 的裁剪目标。
理解了这条"断裂—修补"的因果链,每个算法在你眼里就不再是孤立的公式,而是一次对症下药。这也是全书主调:概念筑基。地基打牢了,上层建筑自己会长出来。
全书知识地图与阅读路线
全书六章,构成一条从具体到抽象、再回到工程的单向街道。第 1、2 章是地基(闭环、回报、MDP、贝尔曼方程);第 3 章讲完价值学习的全流程(动态规划、蒙特卡洛、时序差分、Q-Learning);第 4 章把它推到深度(DQN 及其变体);第 5 章转向策略路线(策略梯度、Actor-Critic、PPO、DDPG);第 6 章展开前沿视野与工程实践。章节之间的依赖关系是硬性的:跳过第 2 章直接读 DQN,你会在"目标网络为什么能稳定训练"处卡死;跳过第 5 章前半直接读 PPO,clip 范围的那些数字对你就是天书。
图:强化学习算法演化树——从 Q 表到 PPO
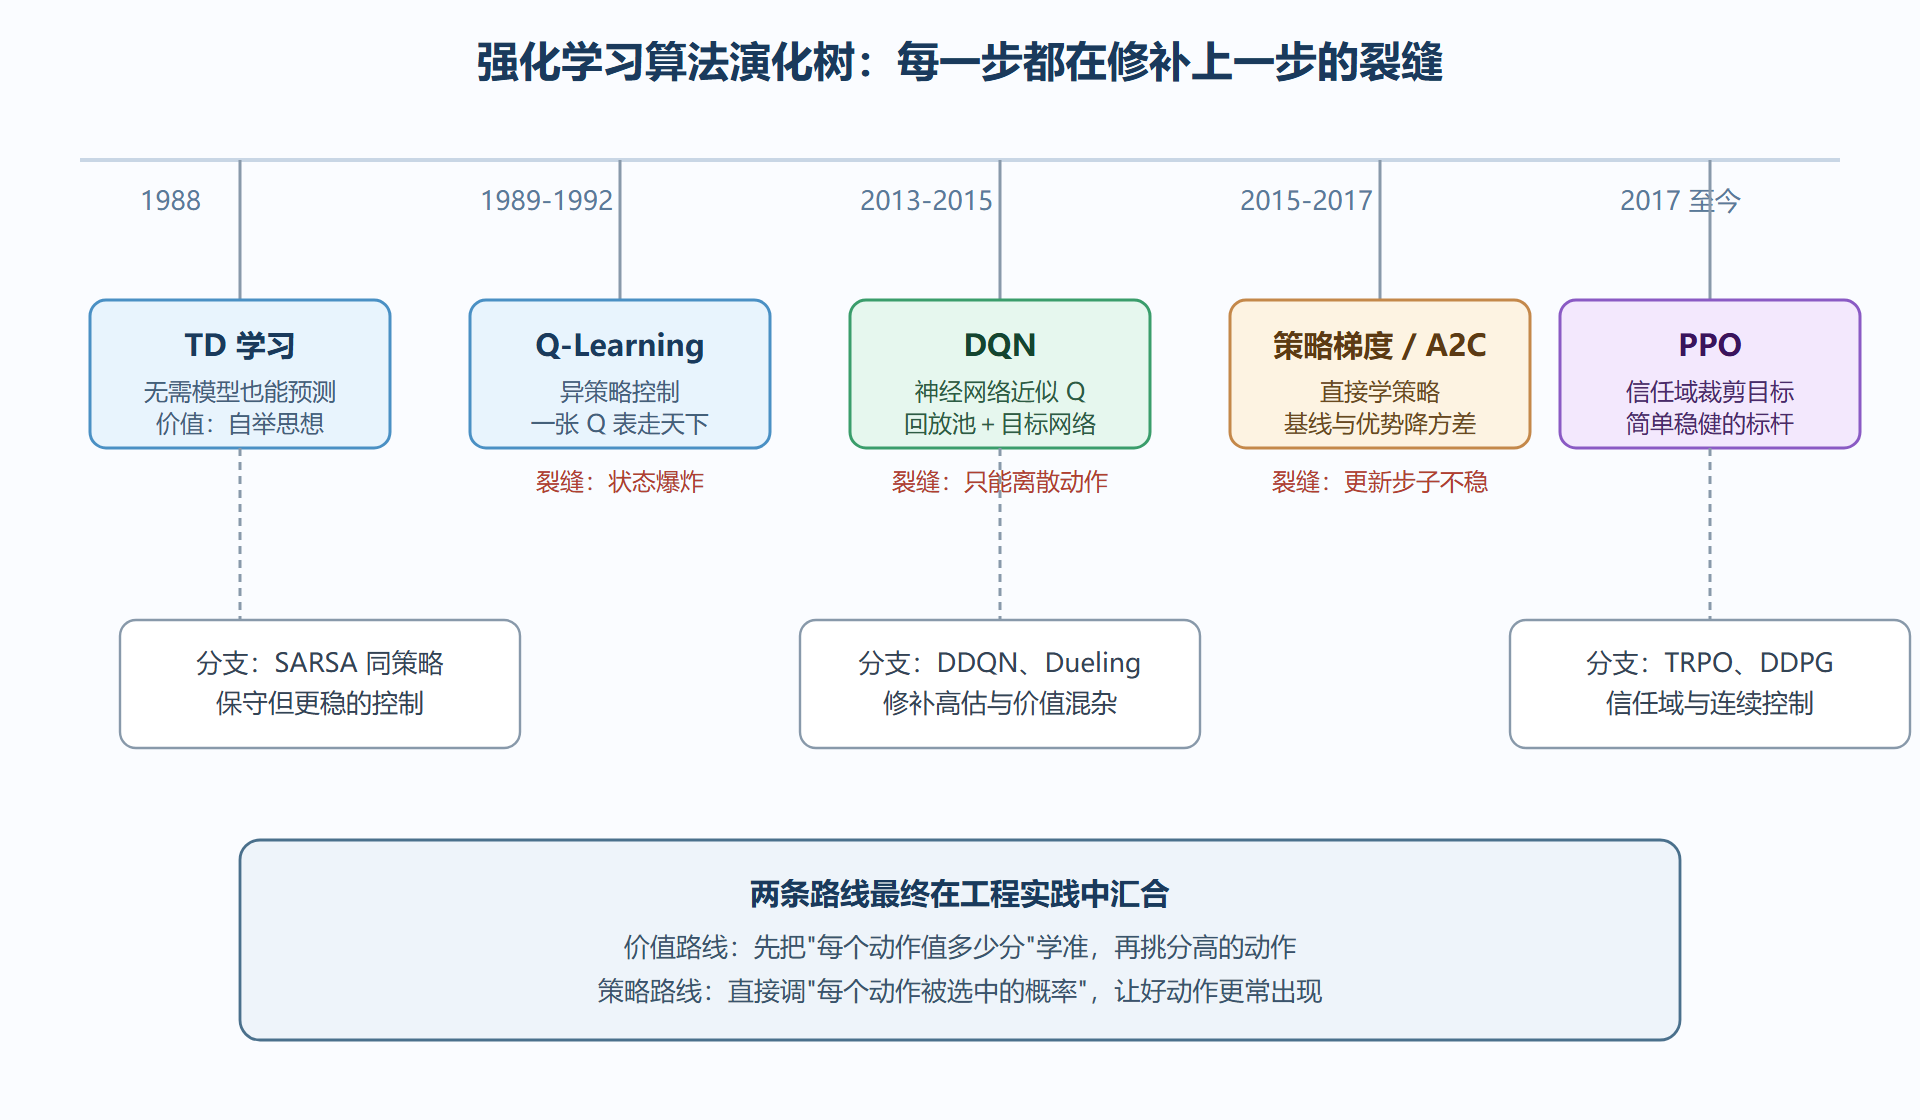
这张演化树同时是全书的目录:第 3 章讲左上角,第 4 章讲中央,第 5 章讲右侧。虚线分支对应第 4、5 章的进阶小节。
各章速览
第 1 章 智能体与环境。把"智能体-环境-奖励"闭环逐个零件拆开:状态、动作、策略、价值函数各自扮演什么角色;回报为什么要打折(折扣因子);回合式任务与连续式任务的区别,以及探索与利用这对贯穿全书的矛盾。
第 2 章 MDP 与贝尔曼方程。把上一章的闭环翻译成数学:马尔可夫性质、五元组、回报的递归结构。贝尔曼方程是全书的枢纽——价值 = 即时奖励 + 折扣后的未来价值,这一个式子支撑起后面所有算法。配格子世界手算演练。
第 3 章 从动态规划到 Q-Learning。价值学习的完整故事分四步:模型已知就用动态规划反复扫表(策略迭代、价值迭代);模型未知就采样整条轨迹取平均(蒙特卡洛);时序差分把两者杂交,走一步就更新;最后是 SARSA 与 Q-Learning 的同策略异策略之分,以及小网格世界 Q 表逐步更新的完整数字演练。
第 4 章 从 Q 表到深度 Q 网络。状态一多表格就失效,函数逼近接棒;神经网络近似 Q 函数后训练会发散,经验回放与目标网络两台稳定器救场;Double、Dueling 等变体各有针对性修补。含超参数实录与变体对比矩阵。
第 5 章 策略梯度、Actor-Critic 与 PPO。换一条思路:不学价值,直接调策略参数,让高回报的动作出现得更频繁。REINFORCE 简单但方差大,基线与优势函数是降方差的利器;策略更新"步子一大就崩"是老毛病,PPO 用一个 clip 谓词达到信任域效果且实现极简;DDPG 展示确定性策略如何玩转连续动作。含 ratio 与 clip 的逐数字演练。
第 6 章 前沿视野与工程实践。探索策略进阶(UCB、Boltzmann、好奇心)、蒙特卡洛树搜索与 AlphaGo、离线强化学习、多智能体、模仿学习与逆强化学习、迁移与元学习、安全强化学习;接着是 Gymnasium 与 Stable-Baselines3 工具链、奖励设计与收敛诊断、应用领域盘点。这一章把前五章的知识接到真实的训练日志上。
你将获得的能力
读完并动手复现书中的演练,你应当能够:写出 Q-Learning 的更新式并解释每一项的含义;在网格世界上手工推演价值迭代与 Q 表更新的前几步;说出经验回放与目标网络分别解决什么问题;用基线把策略梯度的方差压下来;解释 PPO 的 clip 谓词如何限制策略更新幅度;面对一个新任务,能判断该选价值路线还是策略路线,并给出初始超参数。
学习方式建议
每章先读概念段落,再合上书推一遍公式,最后跑代码。书中所有演练都用小规模问题(网格世界、悬崖行走、一维控制器),一台普通笔记本就能复现,无需 GPU。代码示例刻意保持简短——强化学习的难点从来不在代码量,而在"这个数字为什么是这个值"。看到任何超参数都追问一句:改成两倍会怎样?这个追问习惯,比多背十个算法更有用。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...