7.2 风洞与试飞:仿真、测试与调试
7.2 风洞与试飞:仿真、测试与调试
本节摘要:在风洞发明之前,飞行试验靠勇者拿命换数据。本节给智能体建风洞:仿真环境的构成与仿真-真实差距的管理,测试金字塔从单元到系统的层层收口,故障注入与蒙特卡洛推演把前六章的预案变成肌肉记忆,回放调试把黑匣子变成时间机器——让每一次失败都沉淀为资产。
在风洞成为实验室标配之前,空气动力学的每一步都靠试飞员把生命押在未知上。风洞改变了游戏规则:同一工况可以重复吹上千次,参数可以逐个扫,极端工况可以放心地逼近——昂贵而危险的真实试验,被便宜而安全的受控实验替代。智能体工程的风洞就是仿真环境,本节的任务是把它建起来、把测试金字塔码上去、把调试做成时间旅行。
仿真环境:可控空域的构造
一套够用的仿真环境由三层构成:物理层(运动学与动力学——飞行器怎么动、碰撞怎么发生)、传感层(探头的理想读数加可调噪声、延迟与失效——按第 2 章的失效模式注入雨雾与盲区)、空域层(静态布局、动态他机、事件剧本——按第 1 章的空域属性配置可观测性与动态性)。三层的参数全部来自前六章的真实契约:噪声模型取自 2.3 节的一致性检验,失效剧本取自 4.3 节的故障注入库,空域配置取自 1.1 节的属性判断。
仿真管理的核心难点是仿真-真实差距(sim-to-real gap):仿真里完美收敛的策略,实机上可能一触即溃。工程对策是承认差距、管理差距:定期用真实数据校准仿真参数(回放对分,2.3 节的联调法反向使用);关键决策不在仿真里"一次定终身",实机灰度小步上量;差距本身作为指标跟踪——同一组剧本在仿真与实机的成绩差,就是差距的度量。
测试金字塔:层层收口
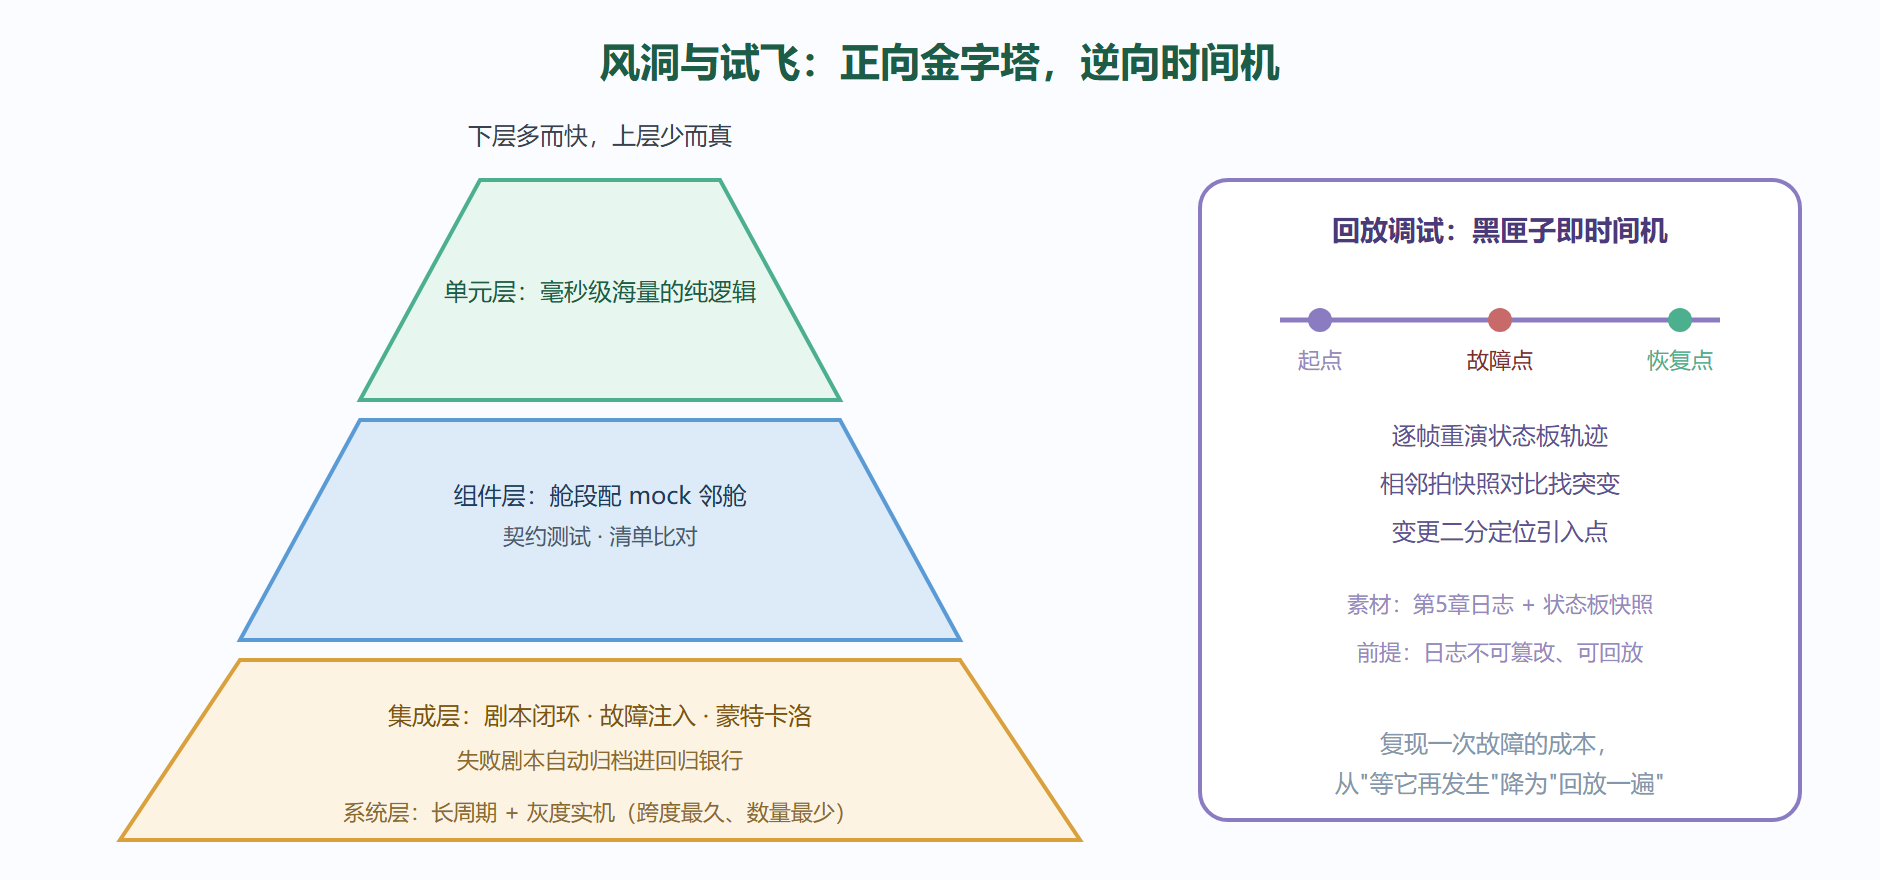
测试按成本与数量排成金字塔,下层多而快、上层少而真:
- 单元层:滤波器、搜索、谓词、状态机的纯逻辑测试,毫秒级跑完,改动即跑;
- 组件层:单舱段配 mock 邻舱——感知舱吃录制数据、规划舱吃伪造信念,舱段契约测试(6.1 的清单比对)在此执行;
- 集成层:真实舱段接线,剧本化场景跑闭环——4.2 节的剧情注入、4.3 节的故障注入、3.4 节的蒙特卡洛推演全部落位;
- 系统层:长周期仿真加灰度实机,考察资源泄漏、日志膨胀、性能衰减这类"跑得越久越显形"的病。
金字塔的纪律是测试随故障生长:每一次真实故障(测试环境或线上)都沉淀为一个可重复的失败剧本,进入对应层的回归集——回归集的长速,就是工程团队的记忆力。
def scenario_runner(sim, agent, scenario, checks): """剧本执行器:仿真联调的通用骨架。 scenario: 布局 + 动态事件 + 注入故障的时间表 checks: 断言列表(状态板时序、指标、安全约束) """ board_trace = TraceRecorder() # 状态板逐拍快照 agent.board.attach(board_trace) for spec in scenario.inject_faults: # 按剧本注入故障 sim.schedule(spec.at, spec.fault) sim.reset(scenario.layout) while not sim.finished(): agent.board.write("sim_time", sim.clock(), writer="sim") agent.run_tick(sim.world()) for chk in checks: chk.at_tick(agent.board, sim) # 逐拍断言 verdict = {"scenario": scenario.name, "failed": []} for chk in checks: if not chk.final(agent.board, board_trace): verdict["failed"].append(chk.name) if verdict["failed"]: # 失败剧本自动归档进回归集 regression_bank.save(scenario, board_trace, verdict) return verdict
执行器的设计要点在失败归档:失败的剧本连同状态板轨迹一起存进回归银行,修复后重跑同一剧本验证——这就是"失败变资产"的机械实现。回归银行同时是 7.3 节指标统计的数据源,测试与评估共用一条数据管道。
图:测试金字塔与两条时间线——正向验证与逆向回放
回放调试:时间机器
回放调试是仿真与日志的合流:现场故障发生后,从第 5 章的黑匣子取出状态板轨迹与输入流,在仿真环境里逐帧重演,故障在实验室里安全复现。三段法定位:逐帧重演看故障时刻前后的状态板轨迹;相邻拍对比找突变——哪个字段在哪一拍跳变了;变更二分把引入突变的提交从版本史里二分出来。回放的前提在第 5 章已经打好——日志不可篡改、可回放、状态机轨迹完整;缺了这些,时间机器只能空转。
联调与故障排查
本节的联调科目是覆盖审计:把计划运行的空域按第 1 章属性拆成场景矩阵(可观测性、动态性、失效模式的组合),统计测试剧本对矩阵的覆盖格数——空白格就是"演示成功、上线翻车"的候选出处:
def coverage_audit(scenario_bank, airspace): """场景矩阵覆盖审计:空白格就是上线风险。""" matrix = {} # (可观测性, 动态性, 失效模式) -> 已覆盖剧本数 for sc in scenario_bank.all(): key = sc.airspace_signature() # 剧本标注的空域属性 matrix[key] = matrix.get(key, 0) + 1 gaps = [key for key in airspace.required_cells() if matrix.get(key, 0) == 0] return {"covered": len(matrix), "gaps": gaps, "verdict": "PASS" if not gaps else "补剧本"}
回放调试的尾段是变更二分,与逐帧重演、相邻拍对比构成三段法:
def bisect_breaking_change(candidates, replay): """变更二分:回放让'引入故障的提交'无处藏身。""" # candidates: 按时间排序的提交列表(可复现构建) lo, hi = 0, len(candidates) - 1 while lo < hi: mid = (lo + hi) // 2 build = rebuild(candidates[mid]) # 精确复现历史构建 if replay.crashes(build): hi = mid # 故障在此或更早 else: lo = mid + 1 # 故障在其后 return candidates[lo]
按症状排查:仿真过、实机崩先查差距管理——参数多久没校准、剧本的噪声分布是否过理想;测试全绿线上仍出事查覆盖矩阵与真实事件的比对——出事的场景多半在空白格里;回归跑不完查金字塔配比——下层太薄把压力堆给了上层的慢测试。
⚠️ 常见坑:把仿真当装饰、把实机当试验田。实机首试一次的代价(时间、风险、信任),够仿真里跑几百次剧本——顺序颠倒的团队,调试时间会吃掉全部开发时间。
本节要点回顾
- 仿真三层:物理、传感(含失效注入)、空域(按属性配置),参数全部来自前六章的真实契约。
- 差距要管理:真实数据定期校准仿真,仿真与实机的成绩差本身是跟踪指标。
- 金字塔纪律:下层多而快、上层少而真;失败剧本自动归档,回归集的长速是团队记忆力。
- 回放三段法:逐帧重演、相邻拍对比、变更二分——黑匣子的工程回报在这里兑现。
- 覆盖审计:场景矩阵的空白格,就是上线翻车的候选出处。
测试证明了一件事在测过的场景里没坏,但"要用的场景里可靠"需要数字。下一节开验收会:指标体系怎么定、评估怎么做、数字怎么不被自己骗。