7.3 验收指标:性能评估体系
7.3 验收指标:性能评估体系
本节摘要:"做得不错"不是验收结论,数字才是。本节建立四层指标体系——任务层、资源层、可靠层、安全层,每项指标给出定义、测量与门槛三要素;讲北极星指标与护栏指标的配平艺术,评估的三条渠道(基准、灰度、长周期观测),以及指标作弊的常见姿势与识别——均值会撒谎,门槛会诱导,数字必须被审。
一台智能体"做得不错"到底是什么意思?这句话在验收会上等于什么都没说。能写进交付文档的只有数字:任务成功率多少、平均完成时长多少、故障后多久恢复、人工介入频率几何——而且每个数字都要经得起追问:怎么定义的、怎么测的、门槛为什么定在这。上一节的测试给了场景覆盖,本节给判定标尺;测试与评估共用一条数据管道(回归银行与日志),但回答的是不同的问题——测试回答"坏没坏",评估回答"好不好、好多少、值不值"。
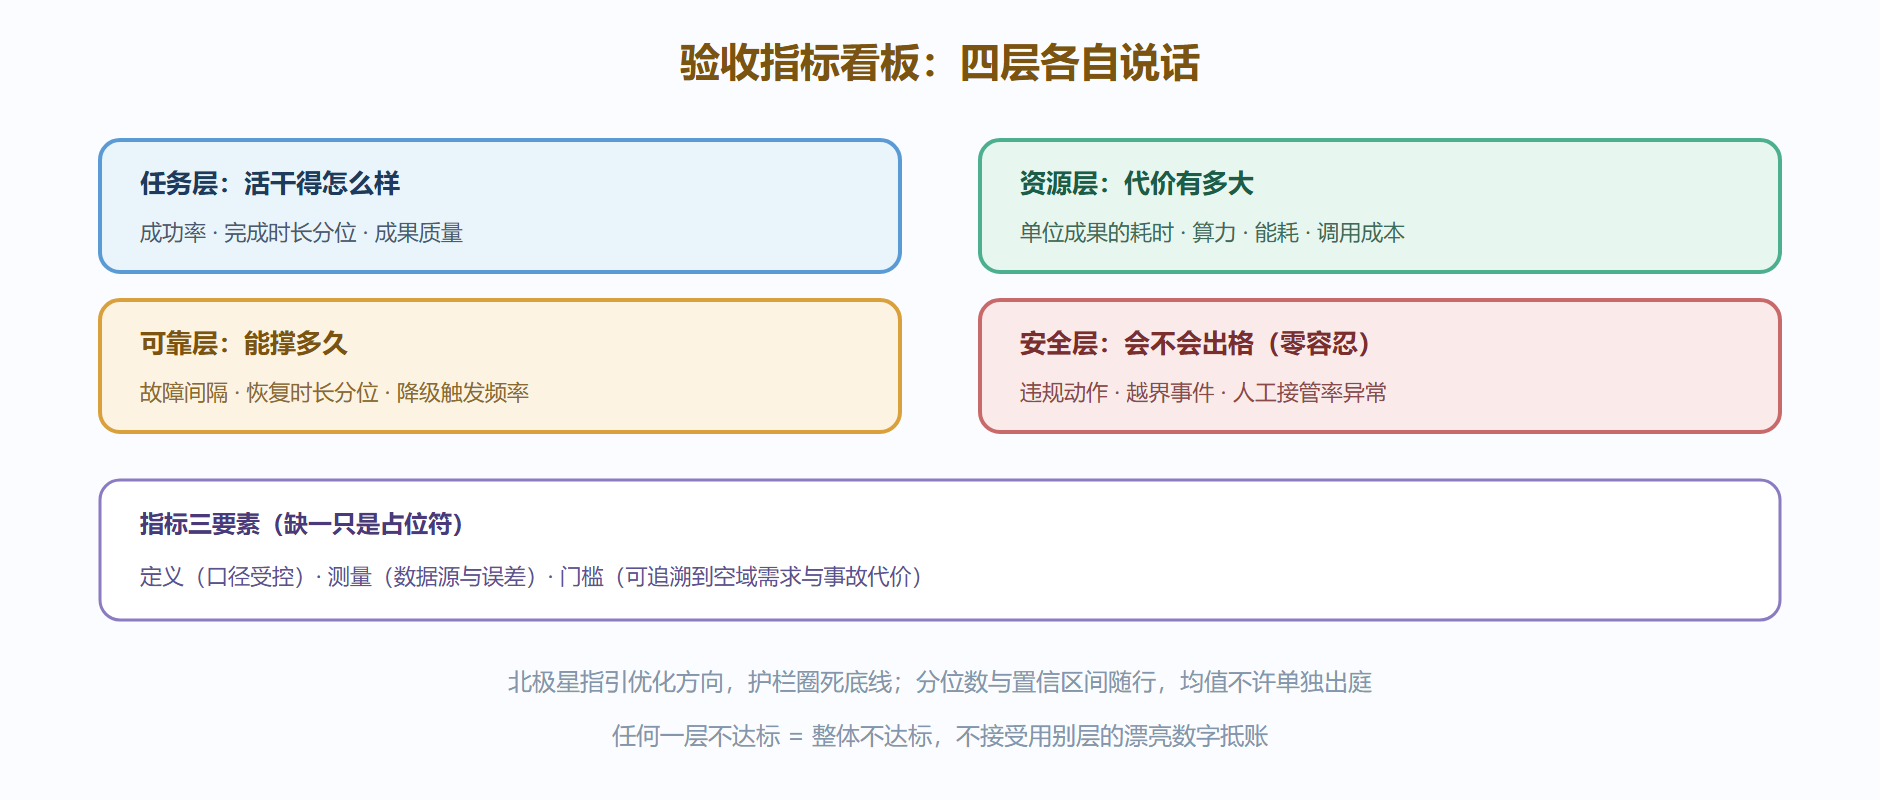
四层指标体系
指标按提问层次分四层,每层回答一个方向的问题:
| 层 | 回答什么 | 代表指标 | 常见门槛形态 |
|---|---|---|---|
| 任务层 | 活干得怎么样 | 成功率、完成时长、成果质量 | 成功率不低于既定线,时长分位数封顶 |
| 资源层 | 代价有多大 | 单任务耗时、算力开销、能耗、外部调用成本 | 单位成果的代价上限 |
| 可靠层 | 能撑多久 | 故障间隔、恢复时长、降级触发频率 | 间隔下限、恢复上限 |
| 安全层 | 会不会出格 | 违规动作次数、越界事件、人工接管率 | 零容忍项必须为零 |
分层的关键在不混层:用任务成功率遮掩安全违规,或用资源代价豁免可靠欠账,都是验收会上的经典魔术。四层各设门槛、独立判定,任何一层不达标即整体不达标——指标体系的价值不在漂亮的总分,在不可协商的分项。
指标的三要素缺一不可:定义(成功率分母是什么?失败怎么计?部分完成算几成?)、测量(数据从哪来——回归银行、日志、还是人工标注;测量误差多大)、门槛(为什么是这条线——线定在哪要能追溯到空域需求与事故代价,而不是"领导拍的")。三要素不全的指标,在验收文档里只算占位符。
北极星与护栏:配平的艺术
单一指标优化必然牺牲其他——只压完成时长,质量与安全迟早被献祭。工程上的配平方案是北极星加护栏:北极星是本阶段最重要的一项(部署初期常是任务成功率,成熟期常是单位成本),优化围绕它展开;护栏是绝不容破的底线(安全违规零容忍、恢复时长上限),护栏之内的优化才是合法优化。配比随生命周期挪动:演示阶段北极星是"能完成任务",产线阶段北极星往往是"稳定地便宜地完成任务"。
算法实现:评估流水线
class MetricsPipeline: """评估流水线:从回归银行与日志算出可审的指标。""" def __init__(self, regression_bank, log, audit): self.bank = regression_bank self.log = log self.audit = audit def task_success_rate(self, window, definition): """成功率:定义显式传入,杜绝口径漂移。""" runs = self.bank.runs(since=window.start, until=window.end) judged = [definition.judge(r) for r in runs] rate = sum(1 for j in judged if j is True) / len(judged) return {"value": rate, "n": len(judged), "ci": wilson_interval(judged)} # 置信区间随行 def recovery_time(self, window): """恢复时长:从故障标记到验收谓词转真的分布。""" pairs = self.log.pair_up("failure", "recovered", within=window) times = [p.duration() for p in pairs] return {"p50": percentile(times, 50), "p95": percentile(times, 95), # 尾部比均值诚实 "n": len(times)} def acceptance_report(self, gates): """验收判定书:逐门槛独立判定,任何一层不破即整体过。""" rows = [] for gate in gates: m = gate.metric_fn(self) rows.append({"name": gate.name, "value": m, "gate": gate.threshold, "pass": gate.judge(m)}) breached = [r["name"] for r in rows if not r["pass"]] return {"rows": rows, "verdict": "PASS" if not breached else "FAIL", "breached": breached}
流水线里的两个细节是防自欺的关键。置信区间随行:成功率零点九基于十次与基于千次,是两种完全不同的把握,验收文档必须带样本量与区间;分位数代替均值:平均恢复时长五分钟、最坏一次两小时——均值把尾部藏起来了,而事故恰恰住在尾部,可靠层指标一律看分位数。
图:四层指标看板——独立判定,任何一层不破即不签
统计件的两个诚实件——分位数与置信区间——实现极简却常被省略:
def percentile(xs, q): """分位数:可靠层指标一律看分布,不看均值。""" ys = sorted(xs) idx = min(len(ys) - 1, int(len(ys) * q / 100)) return ys[idx] def wilson_interval(judged, z=1.96): """威尔逊区间:小样本成功率给出诚实的把握范围。""" n = len(judged) p = sum(1 for j in judged if j is True) / n denom = 1 + z * z / n center = (p + z * z / (2 * n)) / denom spread = z * (p * (1 - p) / n + z * z / (4 * n * n)) ** 0.5 return (max(0.0, center - spread), min(1.0, center + spread))
评估的三条渠道与作弊识别
三条渠道互补:基准测试(固定的任务集与场景,版本间可比,防回归)、灰度观测(真实流量的小比例放量,看真实空域里的成绩)、长周期观测(运行数周的衰减曲线,抓资源泄漏与慢漂移)。渠道间数据打架往往是最有价值的信号——基准全绿而灰度难看,说明场景覆盖有缺口(回 7.2 节的覆盖矩阵)。
指标作弊的常见姿势与识别:挑样本(只报顺利时段)——看样本量与时段覆盖;改定义(悄悄放宽"成功"的口径)——定义要随版本受控,口径变更走评审;刷门槛(针对门槛线过拟合,门槛附近的场景突然全绿)——用保留集(不进训练与调参的场景)复测;均值魔术——强制分位数与分布图上会。
💡 关键直觉:指标是行为的培养皿——你测什么,团队就长成什么形状。门槛定得草率,比没有门槛更糟:它给了不合理行为一个合法的靶子。
本节要点回顾
- 四层独立判定:任务、资源、可靠、安全各设门槛,不混层、不可协商,任何一层不达标即整体不达标。
- 三要素齐全才算指标:定义、测量、门槛,缺一只是占位符;门槛要能追溯到空域需求与事故代价。
- 北极星加护栏:单指标优化必牺牲他项,护栏之内的优化才合法;配比随生命周期挪动。
- 分位数与置信区间:均值会藏尾部,样本量给把握——验收数字必须带区间与样本。
- 三渠道互补:基准可比、灰度真实、长周期抓衰减;渠道打架是覆盖缺口的信号。
指标全绿,最后一道关不是技术:这台机器将感知谁、记录谁、出了事谁负责。下一节过机务守则。