7.1 算法选型:拿到新问题的第一小时
7.1 算法选型:拿到新问题的第一小时
本节摘要:选型题的正确姿势不是报算法清单,而是演示一套开工流程:把业务目标翻译成可度量指标、给数据做快速体检、用最土的模型立基线,然后才有资格谈「上什么算法」。本节给出第一小时的完整动作序列与选型决策树。
「给你一个新问题,你怎么做」是开放题里的固定开场,它考的不是知识量而是工作流的成熟度。绝大多数低分回答的症状是「直接跳到模型」——上来就说「我会试试 XGBoost 和神经网络」,面试官立刻知道你没从零启动过项目。本节把第一小时拆成有顺序、有产出物的动作。
主问题:第一小时做什么
主问题:「拿到一个从来没做过的预测类需求,你的第一个小时怎么过?」
标准答案
三件事按序完成。第一,目标转译:和需求方对齐「预测什么、给谁用、错了的代价是什么」,把口头目标钉死成一个可度量的指标与验收口径——这一步不完成,后面全部白干。第二,数据体检:看样本量、特征数、目标分布、缺失率、时间跨度这五个数字,十五分钟的检查能决定后续一周的路线。第三,基线先行:先用最土的模型(多数类、均值、逻辑回归或浅树)在诚实验证口径上立一个基线,所有后续复杂度都要向这个基线索要增量证明。第一小时结束时,你手里有一句钉死的指标、五个数据体检数字和一个基线分数——这才叫开了工。
「基线先行」是这个答案的灵魂:没有基线,复杂模型的复杂度就没有对照组;面试里说出「先用逻辑回归占住基线再谈别的」,是从执行者视角说话的直接证据。
追问一层:算法怎么选
追问:「基线立完之后,算法怎么选?有章法吗?」
参考答法是给决策树配理由,而不是背清单。选型的三个输入是数据形态、标注规模、部署约束:
图:算法选型决策树
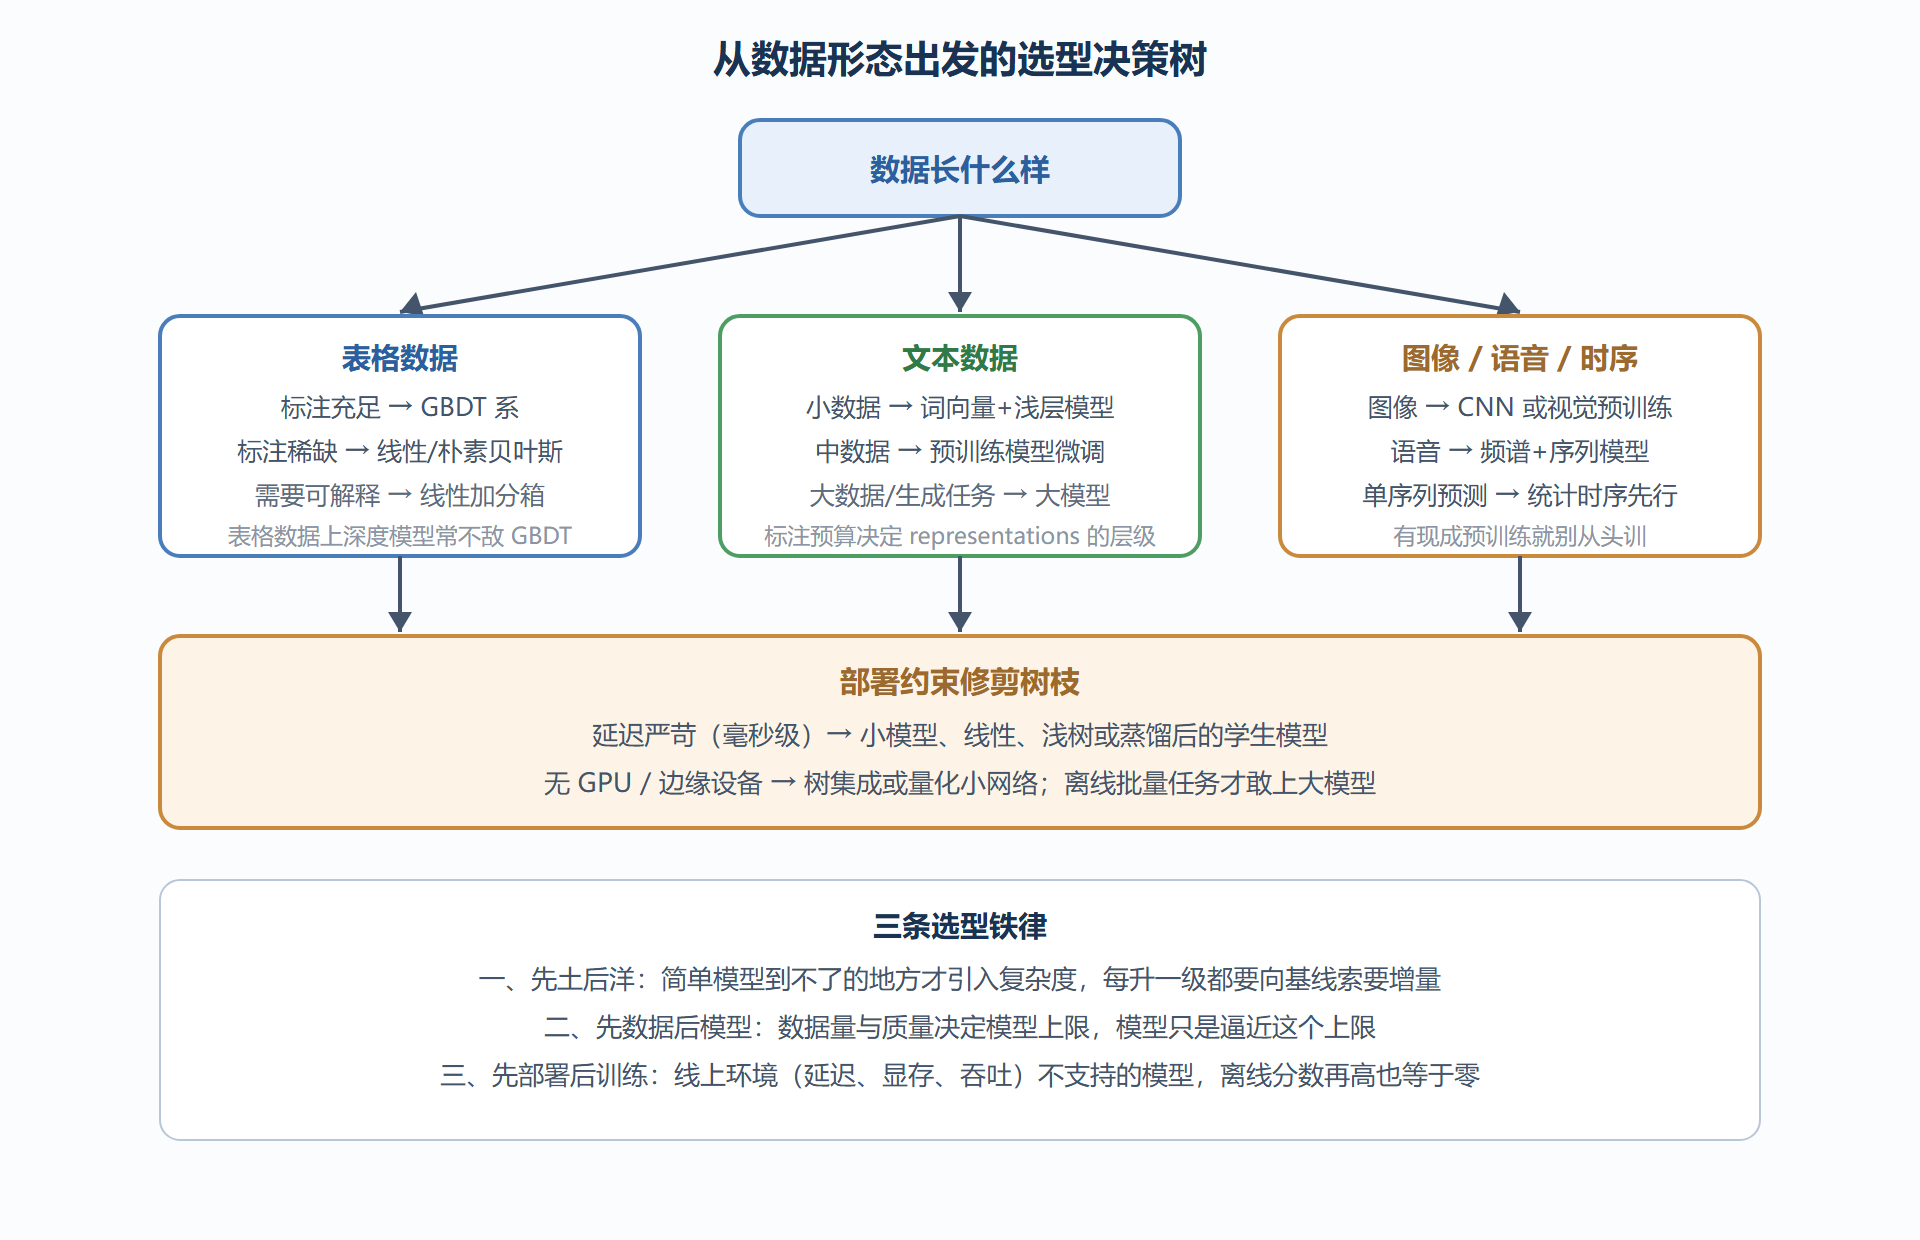
追问的回答词:表格数据优先 GBDT 系(参照第 2 章的理由),标注稀缺时退到线性加强特征;文本与图像先找预训练表示,微调优于从头训练;时序预测先用统计基线(季节均值、指数平滑)再上模型。每一条都以「先土后洋」收口。
追问二层:基线怎么立才立得住
追问:「你说基线先行,一个合格的基线要满足什么?」
参考答法给三条标准:其一,口径一致——基线与后续所有模型用同一验证切分、同一指标,否则对比无效(6.1 的纪律);其二,成本合理——基线的训练与部署成本必须是「业务可接受的最低配」,否则失去了「是否值得上复杂模型」的参照意义;其三,诚实命名——基线报告要写清「这是多数类基线」还是「这是带特征工程的逻辑回归」,两个量级的基线混着说会误导决策。面试补一个反例更显老练:见过用未调参的深度模型当「基线」去证明树模型不行的汇报,那是反向作弊——基线的诚实性是双向的。
易错点
- 目标转译跳过「错了的代价」:FN 与 FP 代价不对称却用对称指标训练(1.4 节的教训在选型时刻就已生效)。
- 数据体检只看均值不看分布与时间跨度:倾斜目标、时间断层、实体重复都在体检五数字里现形,漏检的代价是整周返工。
- 把「算法越新越好」当选型逻辑:生产系统里维护成本、推理延迟、团队熟悉度都是一等公民。
- 第一小时无产出物:目标转译和数据体检没有留下文字结论,第二天就忘——「有产出物」是流程成熟度的标志。
评分要点
及格:给出「明确指标、看数据、上模型」三步;良好:第一小时三动作完整,选型理由带条件(数据形态、标注量、部署约束);优秀:基线三标准与「先土后洋」的升级逻辑讲透,全程以产出物视角描述流程。这题的高分本质是把面试官当成需求方——你在演示的不是一个答案,而是一种让人放心的开工方式。
下一节是全章最「救火」的一节:线上效果劣化的排查链,工程追问的重灾区。
高频追问速答
问:业务指标和技术指标对不上怎么办?
这是目标转译的核心难题。解法是分层对齐:找到业务指标(转化率、坏账率)与技术指标(AUC、召回)之间的因果桥,用历史数据验证桥的强度;技术上优化代理指标,业务上定期校验代理指标与真指标的相关性——代理漂移了就换。「优化代理、校准桥」是标准姿势。
问:数据体检发现目标分布极端倾斜,第一小时还立基线吗?
立,而且更要立——但基线的形态要换:不用逻辑回归,用「全预测多数类」或简单规则引擎当基线,配合 PR 口径的验证。基线的意义是占住「最便宜的合理方案」这个参照点,与模型复杂度无关。
问:需求方只给一句「提升转化率」,怎么把目标谈细?
四连问:对谁(人群与场景界定)、多久(评估周期与最小样本量)、多少(提升多少算成功,含统计显著性)、代价(误伤与体验损耗的容忍度)。这四个问题问完,一个含糊的需求就变成了一份可验收的任务书。
表达纪律:选型题的每一步都带「产出物」——指标定义一句话、体检五个数、基线一个分数。有产出物的流程才是可信的流程。
深水区:三个延伸追问
问:第一小时里如果发现数据完全不能用怎么办?
立刻反馈而不是硬着头皮建模:说清缺什么(标注量、关键字段、时间跨度)、能救什么(补采、改问题定义、降级目标)、需要多久。项目前期暴露数据问题的成本最低,「带着坏数据硬跑两周再报告失败」是职业生涯里最贵的错误之一。
问:怎么在开工前估计这个项目值不值得做?
粗算上限:目标指标的理论改善空间乘业务价值,减去数据、人力、推理的持续成本,再打一个成功率折扣。机器学习项目的死法大多是「技术上可行但商业上不值」,成本收益的粗账是资深工程师和初级的手艺分界。
问:基线选型时最容易犯什么错?
用不可部署的基线(离线大模型当基线,线上跑不动)或不可复现的基线(没固定种子与口径)。基线的全部意义在于「可信的比较原点」,两点有一点不成立,后续所有增量声明都是空中楼阁。
追加两问
问:第一小时要考虑团队因素吗?
要。选型不只选算法,还选维护成本:团队熟悉的模型栈、现成的特征管线、公司已有的推理基建,都是选型的真实约束。「在团的约束内选最优」与「在论文里选最优」常常是两个答案,工程面试要的是前者。
问:需求模糊到无法转译怎么办?
用最小可行实验倒逼定义:挑一个最可能的指标口径,跑一个最粗的模型,把中间产物拿给需求方看——「是这个意思吗」。抽象需求在具体产物面前才暴露分歧;等待完美需求定义的项目,多数死在等待里。
问:怎么判断该不该直接建议不建模?
当规则引擎或人工流程能在可接受成本内达标时,建模的边际收益可能覆盖不了边际风险(偏差、维护、故障面)。说得出「这个问题可以先不建模」的候选人,面试官会默认他的建议都经过了成本核算。