- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
机器学习算法面试题精选与解析 · 教程导读
某场算法面试进行到白板环节,面试官合上你的简历,开口就问:这个模型为什么用逻辑回归而不用XGBoost?背熟的名词解释忽然不够用了——真正拉开差距的,是随后那串环环相扣的追问:类别不平衡你怎么处理?正则化为什么能抑制过拟合?L1 的系数为什么恰好被压成零?绝大多数候选人不是倒在第一问,而是倒在追问的第二层、第三层。
本书定位:这是一本以追问链组织的机器学习面试指南。全书把每个高频考点拆解成「主问题与标准答案 → 追问两层 → 易错点 → 评分要点」的固定节奏,覆盖经典机器学习、深度学习、工程与实践、项目与开放题四大板块。读完你得到的不是一份名词解释合集,而是一套能在白板前展开的答题骨架。
为什么要按追问链复习
把面试题当名词解释背,是性价比最低的复习方式。原因在于面试官的提问结构:第一问几乎都是开放且基础的,真正用来分层的是追问。比如问「讲讲 ROC 曲线」,你答出 TPR 与 FPR 只算及格线;追问「PR 曲线和它什么关系,什么时候该看 PR」,考的是你对指标适用边界的理解;再追问「正负样本比一到一万分之一时,两个曲线分别长什么样」,考的是你有没有真的跑过不平衡数据。
追问链复习法就是把这个过程倒过来练:先自己当面试官,把一个知识点能延伸出的追问写全,再逐层准备答案。每道题的深度不再是「背到哪算哪」,而是有明确的防御纵深——第一层答定义,第二层答机理,第三层答边界条件与工程取舍。
本书每一节都按这个节奏展开。标准答案给出三十秒内可以说完的核心结论,先给结论再给理由,这是面试表达的关键纪律;追问两层模拟面试官最常见的深入方向,每层都标注了「面试官在考什么」;易错点收集真实面试中高频翻车的回答方式;评分要点则站在打分者视角,告诉你这道题的得分档位是怎么划分的。
图:全册知识地图(四大板块与学习路径)
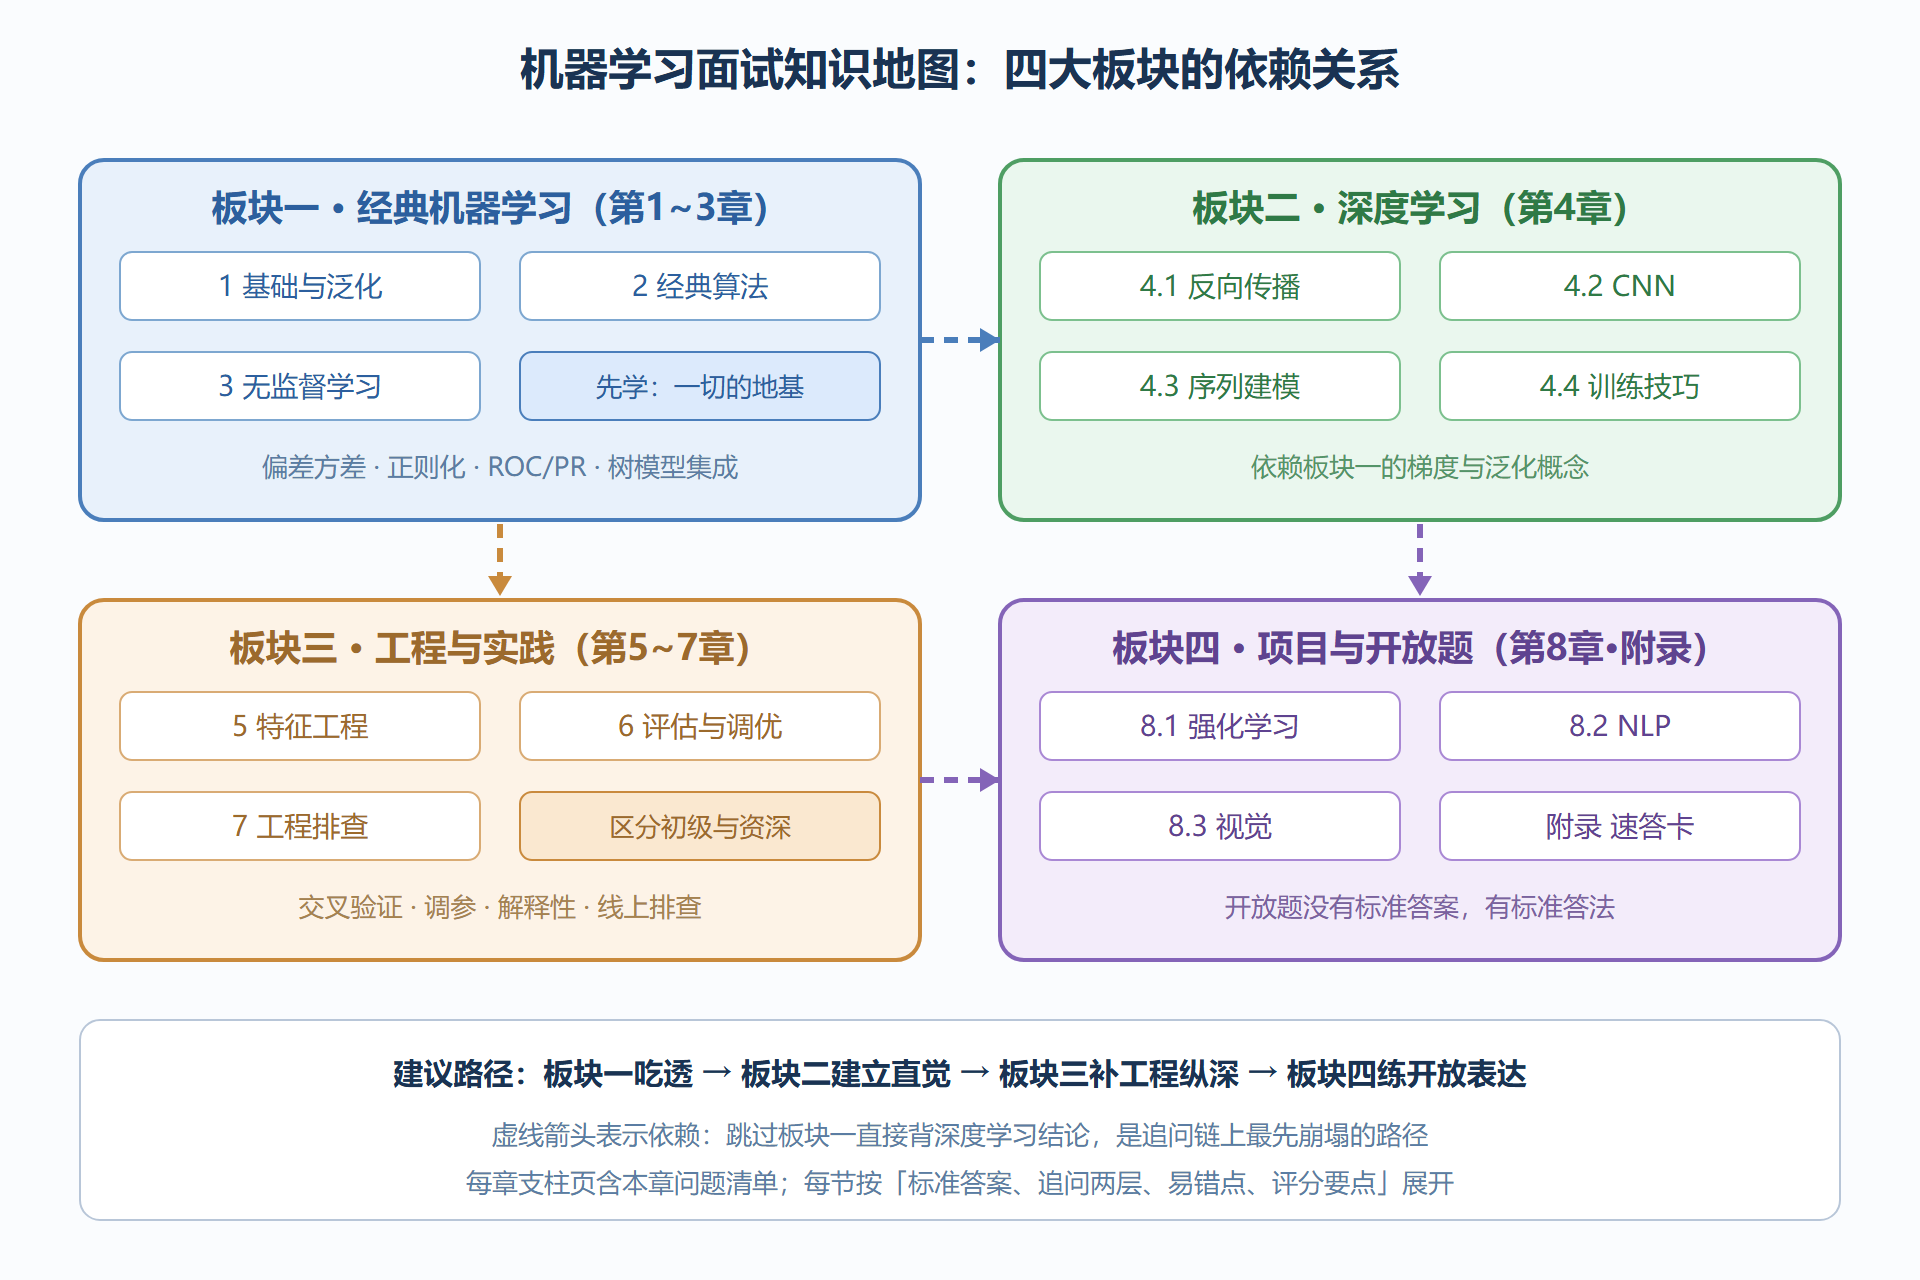
四大板块的分工与依赖
**板块一·经典机器学习(第1~3章)**是全书地基。第1章解决「模型好不好怎么判断」——偏差方差分解、评估指标、类别不平衡,几乎所有面试的第一轮追问都从这里发起;第2章逐个过经典算法的追问链,线性模型、树模型与集成、SVM、KNN、朴素贝叶斯,每一节都带着「为什么它还活着」的视角;第3章处理无监督学习,聚类与降维的追问往往比监督学习更概念化,更需要把推导讲干净。
**板块二·深度学习(第4章)**依赖板块一的梯度与泛化语言。反向传播是必考的白板推导题;CNN 与序列建模的追问集中在感受野、参数量、梯度流动这些可验证的细节上;训练技巧一章把优化器、归一化、初始化串成「训练不动怎么办」的排查叙事,这与第7章的线上排查遥相呼应。
**板块三·工程与实践(第5~7章)**是区分「背过」和「做过」的分水岭。特征工程三章按数据流入模型的顺序推进:清洗、变换、选择、构建;评估与调优一章把交叉验证的变体和陷阱讲透——这是数据泄漏类追问的大本营;工程排查一章直接模拟线上效果劣化的复盘现场。
**板块四·项目与开放题(第8章、附录)**处理没有唯一答案的问题。强化学习、NLP、视觉、可解释AI、联邦学习与AutoML,考的是知识面与判断力;附录的速答卡把全书高频题压缩成分钟级答案模板,供面试前最后过一遍。
这本书怎么用
**第一遍按顺序读,重点不是记住答案,而是记住每道题的追问路径。**读每节时先盖住答案,只看主问题,自己说一遍,再对照标准答案找差距。第二遍按追问深度练:任意翻开一节,从追问一层开始自问自答,说不出的层级就是你的防御空洞。第三遍只用附录的速答卡做考前回放,每道题控制在一分钟以内。
面试表达的纪律值得单独强调:先结论,后展开;说机理时带上一句适用条件;被问到不会的问题,把「我目前的理解是……如果不对请您指正」用起来,比硬编强得多。评分要点部分会反复回到这些表达习惯——同样的知识点,表达顺序不同,档位就可能不同。
祝你在白板前,把每道题都答成一棵展开的追问树,而不是一行孤零零的名词解释。
阅读本册的两种路线
赶时间的求职季路线:导读加附录速答卡先行,再按目标岗位挑板块精读——算法岗重点在板块一与二,工程与策略岗把板块三读透。修炼路线:按章节顺序通读,每节先自测再对答案,追问链的两层防御自己先答一遍再看参考。两条路线共享同一条原则:理解优先于背诵,输出优先于输入。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...