第8章 前沿与开放题:知识面与判断力
第 8 章 · 前沿与开放题:知识面与判断力
本章要回答的三个问题:强化学习的基本框架怎么讲才清晰,它和监督学习的本质差异在哪?NLP 与视觉两大应用域的高频概念题怎么答?可解释AI、联邦学习、AutoML 这些「听起来很新」的话题,面试里考的到底是什么?
为什么会有这一章
前沿题与开放题的目的不是筛选「会做题」的人,而是测量知识面与判断力的上限。面试官抛出「你怎么看大模型取代传统 NLP 管线」这类问题时,期待的不是一个标准答案,而是一次结构化的思考演示:能不能把新事物放进旧框架里定位、能不能同时说出收益与代价、能不能对不确定的东西保持诚实。这一章训练的就是这种「对陌生话题的答法」。
五节内容按「一个框架、两个应用域、两个方法论话题」铺开:强化学习给出与监督学习对照的完整框架;NLP 与视觉两节处理应用域的高频概念;可解释AI 与联邦学习、AutoML 两节则是「概念炒作甄别」的练习场。附录的速答卡随后把全书的追问链压缩成考前可过的一沓卡片。
读完能解决什么
- 能用「状态、动作、奖励、策略」四要素讲清强化学习框架,并回答「它和监督学习差在哪」;
- 能应对 NLP 域的词向量、注意力、预训练微调范式之问,与视觉域的卷积演进、检测分割之问;
- 能把可解释AI 的方法版图讲成「事前可解释与事后解释」两族,并落到与 6.3 节的衔接;
- 能对联邦学习说清「数据不动模型动」的机制与代价,对 AutoML 说清它自动化了什么、没自动化什么。
图:本书话题的技术演进时间线
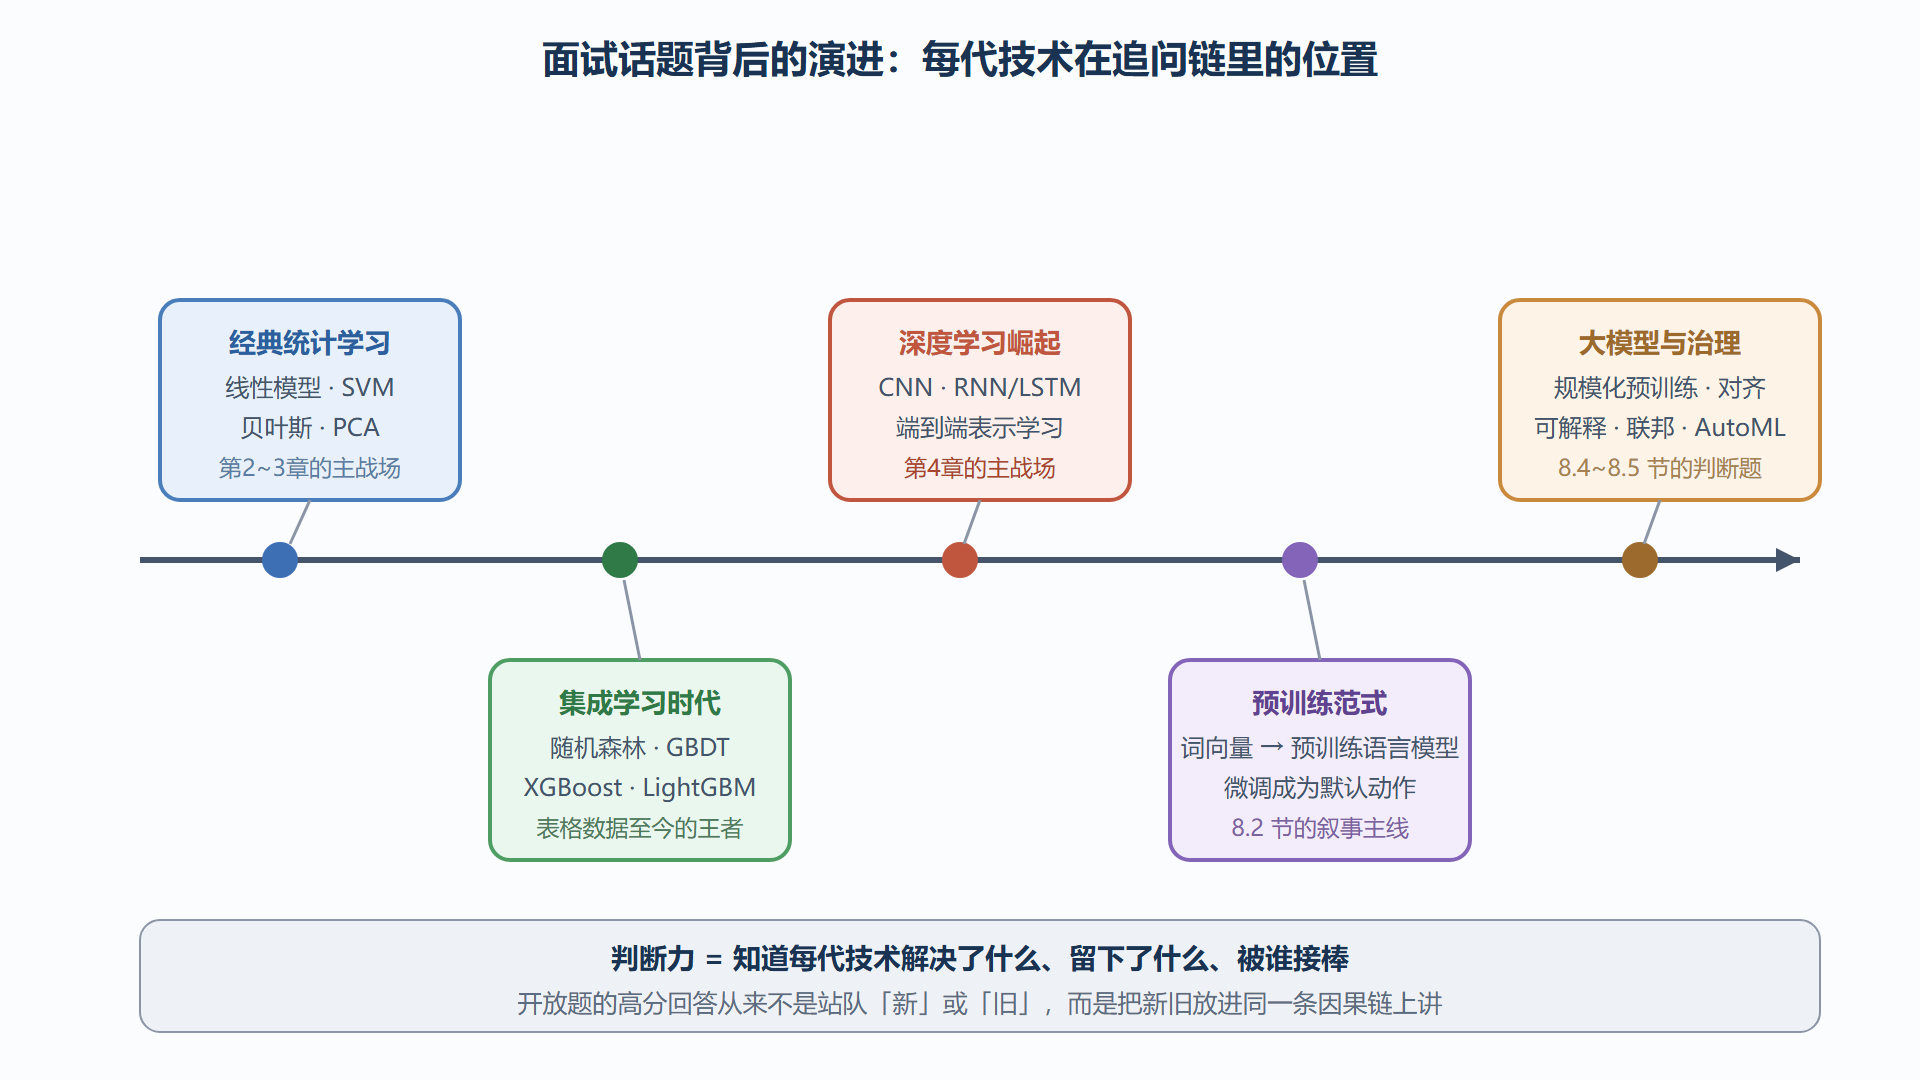
各节怎么分工
| 节 | 话题 | 追问的靶心 |
|---|---|---|
| 8.1 强化学习 | 框架四要素与学习范式 | 与监督学习的差异;探索利用权衡 |
| 8.2 NLP | 表示学习的演进 | 词向量到预训练范式;微调与提示的取舍 |
| 8.3 视觉 | 卷积架构与任务族 | 检测分割的任务定义;数据增广的价值 |
| 8.4 可解释AI | 解释方法版图 | 事前与事后两族;与 6.3 的衔接 |
| 8.5 联邦与AutoML | 隐私与自动化的真实边界 | 各自解决了什么、没解决什么 |
先决条件
需要第 2 章的算法词汇、第 4 章的深度学习机制与第 6.3 节的解释性基础。本章不要求任何前沿方向的实操经验——恰好相反,它教的是「没做过也能答得体面」的方法:定位框架、讲清取舍、承认边界。
往下走到哪
读完本章,全书的闭环完成:从基础概念到前沿判断,从公式推导到项目复盘。附录的速答卡是全书的压缩包——面试前一天,把那张速查矩阵过一遍,让每个高频题的「第一句答案」都在肌肉里。
图:开放题骨架链
通关自测
- 强化学习的四要素与三条本质差异能否对照监督学习讲清?
- 词向量到预训练范式的演进,能否用「表示从静态到动态」的因果链串起?
- 检测与分割的输出空间与评估指标能否分别说准?
- 可解释AI 的两族划分与「证词对证据」的信任等级是否成对出现?
- 联邦学习与 AutoML 的「机制、代价、边界」三段式能否现场演练?
开放题章的自测标准不是记住结论,而是演练骨架:拿到任何陌生话题,先定位、再机制、后代价与边界。这副骨架是全书交给你的最后一件武器。
开放题的三条禁忌
一忌站队式表态(「大模型将取代一切」或「都是炒作」)——两个极端都关闭了讨论;二忌无代价的技术赞美——任何技术只讲收益不讲成本,都会被追问一层击穿;三忌不懂装懂——前沿题的追问深度不可预测,被拆穿一次,前面所有回答的可信度都会被连坐。三条禁忌的反面就是那副骨架:定位、机制、代价、边界、判断。
补充一个答题时长的心法:开放题的首轮回答控制在六十到九十秒——足够铺完「定位、机制、代价、边界」的骨架,又给追问留足空间。首轮讲满五分钟是开放题最常见的失误:把追问的弹药一次性打光,后续只能重复。骨架先行、细节按需展开,是整个板块四的表达纪律。