1.1 生成式AI基础与图像数字化
1.1 生成式AI基础与图像数字化
生成式AI的本质是"学习数据分布、再从分布中采样出新样本"的模型,与只做识别分类的判别式模型有本质区别。本节从分布采样直觉讲起,厘清图像如何数字化、潜在空间是什么,为后续扩散模型构建第一块地基。
这一节是整套教程的第一块砖,位置很靠前,但千万别假设它简单就能跳过去。第二章讲"加噪、去噪"时,背后一句话是"噪声本身就是在随机分布上采样",第四章讲"文本控制"时,又依赖"把文字和图像放进同一片分布空间"。这些细节全都要以本节的两个概念——数据分布、潜在空间——为起点。你可以把它当成一张城市地图的图例:看不懂图例,后面就不是读图,是猜谜。
从"识别"到"生成",差在一个分布
传统AI最熟悉的任务是判别:给一张图,是猫还是狗?AI 学到的是一条边界,把特征空间切成两半。它只回答"这属于哪边",从不自己造一张新图。生成式AI换了个问法:我不告诉你这是什么,我反过来问你——这堆像素到底长什么样的人才配叫"猫的像素"?为了回答这个问法,模型必须学会描述数据的整体分布,而不是只在意边界。
打个比方。判别式像一位阅卷老师,只看你的卷子是及格还是优秀,从不写卷子;生成式更像一位代课老师,上完一学期课,不但能判卷,还能当场另出一套"风格一眼就是他"的新考题。阅卷不需要建立整套知识体系,出题却必须。
数学上,把一张图像看成高维空间里的一个点。比如 256 乘 256 的三通道图,就是约二十万维的一个点。真实世界的图不会均匀撒满这个空间,而是聚集在某片"低维流形"附近——人脸的图挤在人脸流形上,风景的图挤在风景流形上。生成式模型的目标,就是学出这个概率密度,然后在此密度上采样,采出来的点自然"像真图"。下面这段伪代码把"学分布再采样"落到很朴素的形状:
def train(generator_model, real_images): # 目标:让 generator 输出点在 real_images 分布附近 for batch in real_images: loss = measure_distance(generator_model.random_sample(), batch) generator_model.update(loss) # 训练后:model.random_sample() 即是新图像 def sample(generator_model, noise_vector): return generator_model(noise_vector) # 一个随机的"画稿起点"
这里的噪声向量就和扩散关系极深——很多生成模型都以随机向量起步,扩散里,这个向量就是一张"纯噪声"图像。你可以提前记住一句话:生成式AI的起点常常是一把随机的种子,终点才是清晰的图。
图像数字化与潜在空间
电脑里没有"图",只有数字。一张彩色位图,本质是宽乘高乘通道数的一个张量,每个分量是某像素某通道的亮度。为了让"分布"这类偏移的东西有处安放,我们通常再往下压一层:用编码器把高维像素映射到低得多的"潜在向量",这就是潜在空间(latent space)。
潜在空间的设计极有意义。人脸流形在高维里又宽又笨,难以直接采样;一旦压到几十维的潜在空间,你会发现维度低到能逐一解释——某一维可能对应"是否微笑",另一维对应"脸的朝向"。在潜在空间里做算术甚至可行:'微笑的人脸' 减 '面无表情的人脸' 加 '中性人脸的噪声起点',结果常落在"更开心的人脸"附近。这套"在低维空间做语义算术"的直觉,正是第四章图像到图像、第六章条件控制得以成立的理论底牌。扩散模型和VAE都把大量计算搬进潜在空间,目的只有一个:让"分布"短小精悍,模型才学得动、跑得快。
完整链路数据流向也值得看一眼:
从像素到画稿:一份"数字画布"的刻度
把这张"数字画布"再往下抠一层,你会看到它其实有明确的刻度。以一张 512 乘 512 的 RGB 图为例:图像在内存里是 512×512×3 的形状,每一处像素点都装着红、绿、蓝三个 0 到 255 之间的整数;若按 8 位量化来算,单像素有约一千六百万种颜色可选。于是"一张图"在计算机眼里,就是一条接近 78 万维的长向量。分辨率每翻一倍,维度就翻四倍,这也是为什么直接在高维像素上做生成那么吃力——你不是在画一幅画,而是在超高维空间里撒一整片点。
下面这张图把"原始像素 → 编码 → 潜在画稿 → 解码回图"的过程画成一条可读的流水线,噪声清退发生在潜在画稿这一层:
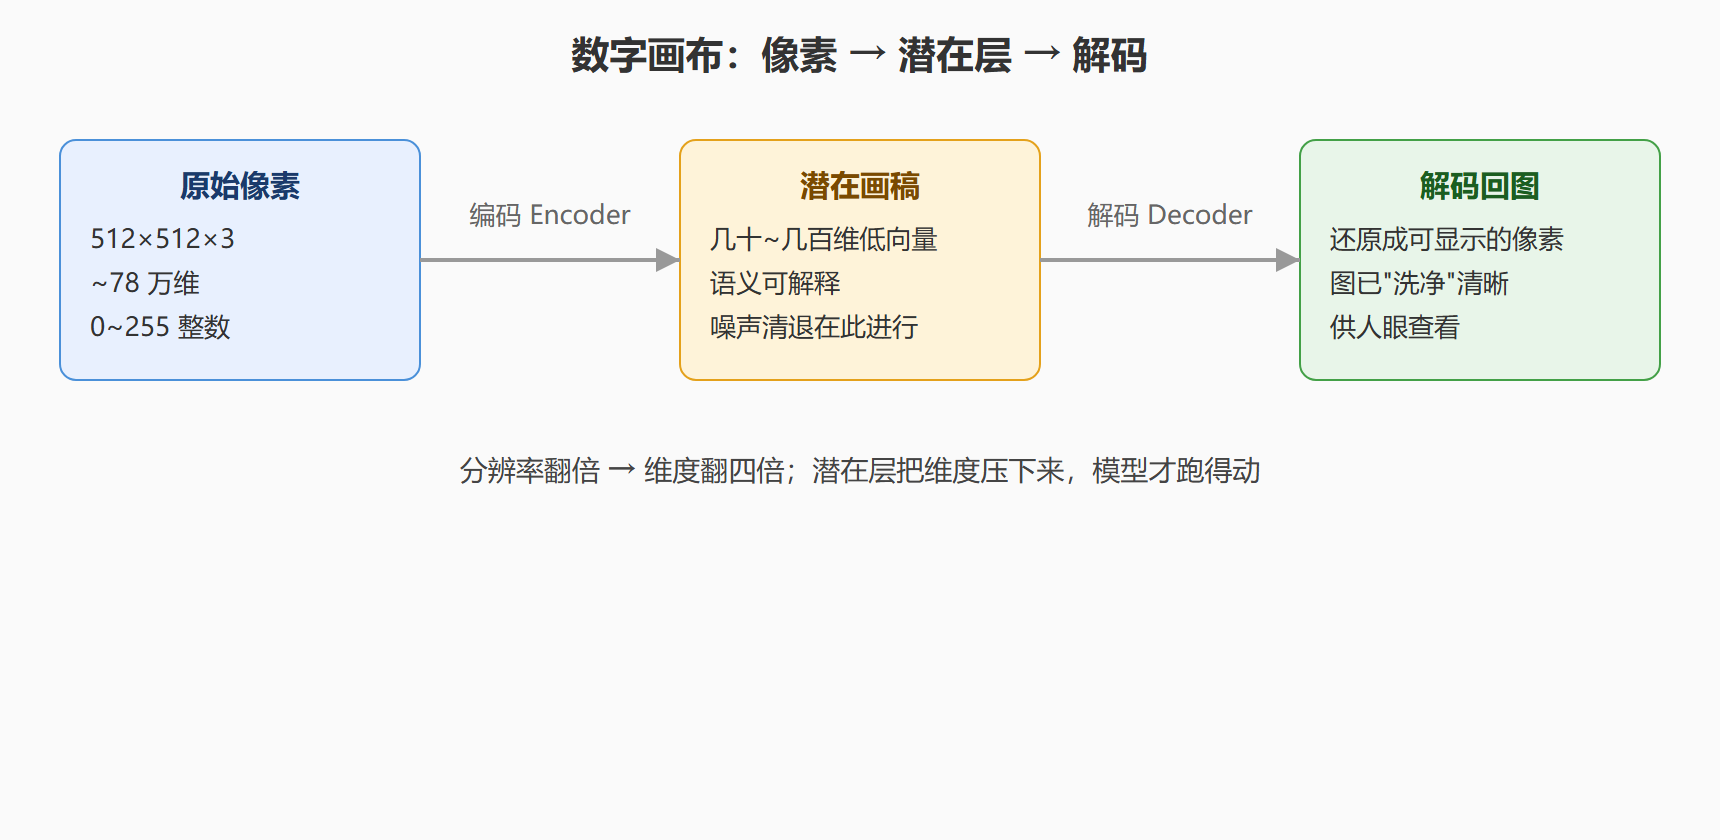
图 1-1:从像素到潜在画稿的数字化管线
这张图想传达一件事:生成模型其实不直接在"78 万维的原始像素"上跳舞,而是先把画面压进一叠薄薄的低维潜在画稿,清洗(去噪)的动作发生在潜在层,洗净后再交给解码器铺回像素层供人眼查看。尺度差越大,越应该走潜在层,这也是第三章"潜在扩散"一整节的伏笔。
量级直觉:从几万维到几维
用一张小对照表绷紧直觉。同样一张猫脸:
| 表示形式 | 大致维度 | 语义可解释性 | 在哪里做生成 |
|---|---|---|---|
| 原始像素 | 数十万~数百万 | 低,都是零散亮度 | 极少直接做 |
| 中间特征层 | 数万 | 中,边缘纹理混合 | 部分早期 CNN |
| 潜在空间 | 几十~数百 | 高,可做加减语义 | 主流生成模型 |
把这一列数字放到一起,你其实已经复习了一半第三章的动机:维度越低,生成、编辑、语义算术越省力;但压得太低又会丢掉细节。找那个"够低又不糊"的平衡点,正是潜在扩散和 VAE 一直在调的事。
工程直觉:分布不是完美的球
工程里最常见的坑,是把生成模型的分布想象成"标准高斯球",于是认为采样越随机越自然。真相反直觉:真实图像的分布常常带毛边、有空洞、在多峰之间断裂。采样落在空洞里,就会生成"看起来有理、细看很怪"的图——这正是第四章会反复提到的伪影与断裂的来源。所以成熟的流水线都配调度、配温度、配指导强度,本质都是"别在分布边缘乱跑"。
⚠️ 常见坑:判别式与生成式混为一谈。前者做的是压缩成概率标签,后者做的是展开成数据样本。第三节解释扩散时若把这两类混着听,会越听越糊涂。
💡 关键直觉:把生成理解成"从分布里抽一个点",几乎所有采样器、调度、温度参数的行为都能用"这步采样采得大胆还是保守"来统一解释。
本节要点回顾
- 生成式 vs 判别式:判别学边界、答案是标签;生成学分布、答案是新样本。
- 一条通用配方:训练目标是让模型输出点聚集在真实分布附近,采样即生成。
- 图像即张量:位图是宽乘高乘通道的数值数组,分布存在于其高维空间。
- 潜在空间压缩:编码器把高维像素压到可解释的低维向量,计算与语义算术都搬到这里。
- 与扩散的接缝:扩散的起点噪声向量、第四章的算术、第六章的条件控制,都挂在这两个概念上。
下一节我们会稳住这张坐标:把 GAN、VAE、扩散三套范式放到同一张对比桌上,看到各自的取舍。