1.2 核心生成模型范式对比
1.2 核心生成模型范式对比
生成图像的三条主线——VAE 靠重构学潜在空间、GAN 靠生成器与判别器互搏、扩散靠逐步去噪逼近分布。本节给出三者对比矩阵,说明为何扩散在质量与可控性上后来居上,并指出 VAE 与 GAN 各自仍在发光的地方。
上一节把"学分布再采样"立成了公理,但那只是给了你一个终点灯塔,没给路。真正的岔路口在范式层面:用什么样的机制去逼近那个分布?Way 有三条,历史上走了很不一样的三条路——VAE 路径最短却太"平滑",GAN 路径最狂野却容易走岔,扩散路径最笨拙却稳稳抵达。本节就是这条岔路口的导航图。看懂它,你才能理解为什么第二章要把全部心力投给扩散,也才能理解为什么第三章还要讲"潜在扩散"这类融合变体——那是把 VAE 的省力接进扩散的稳。
以下三条路线的对比,先看结构再谈取舍。
三条路线各自怎么走
VAE:把分布压成可控的球。 变分自编码器的思路是用编码器把样本压进低维潜在空间,让潜在变量服从一个规整的先验(通常是标准高斯),再用解码器从潜在变量还原出图像。训练的损失一半是"还原得像不像"(重构损失),一半是"潜在分布像不像先验"(KL 散度)。它稳定、生成快,代价是还原出的图像偏模糊——因为它在用球状分布去拟合真实图像那团带毛边的分布,糊是必然的。它的遗产不在于直接生成,而在于"潜在空间"这套工程,第三章的潜在扩散(LDM)直接继承了这个骨架。
GAN:让两伙人互相逼着进步。 生成器造图,判别器分辨真伪,二者轮流训练:判别器越强,生成器被逼得越真;生成器越真,判别器必须越精。最终平衡点是生成器能骗过判别器。GAN 的图可以非常锐利、非常像真,尤其擅长大分辨率人脸。但它的博弈式训练不稳定,常常陷入模式崩溃——反复生成同一批相似样本而不探索全分布,那条"如何防止训练翻车"的权衡,至今仍要靠大量调参支撑。
Diffusion:把一步生成拆成一千步去噪。 扩散干脆不追求一步到位,而是定义一个前向过程,把清晰图像逐步加噪直至变成纯噪声,再训练网络把加噪过程逆向学回来。生成时从纯噪声出发,一步步问"这一步该去掉多少噪声"地复原出图像。它训练稳定、质量高、可控性强(条件信息容易嵌入),劣势是采样要走过很多步,慢。
这张图把三者的特征浓缩在一张对比透视里:
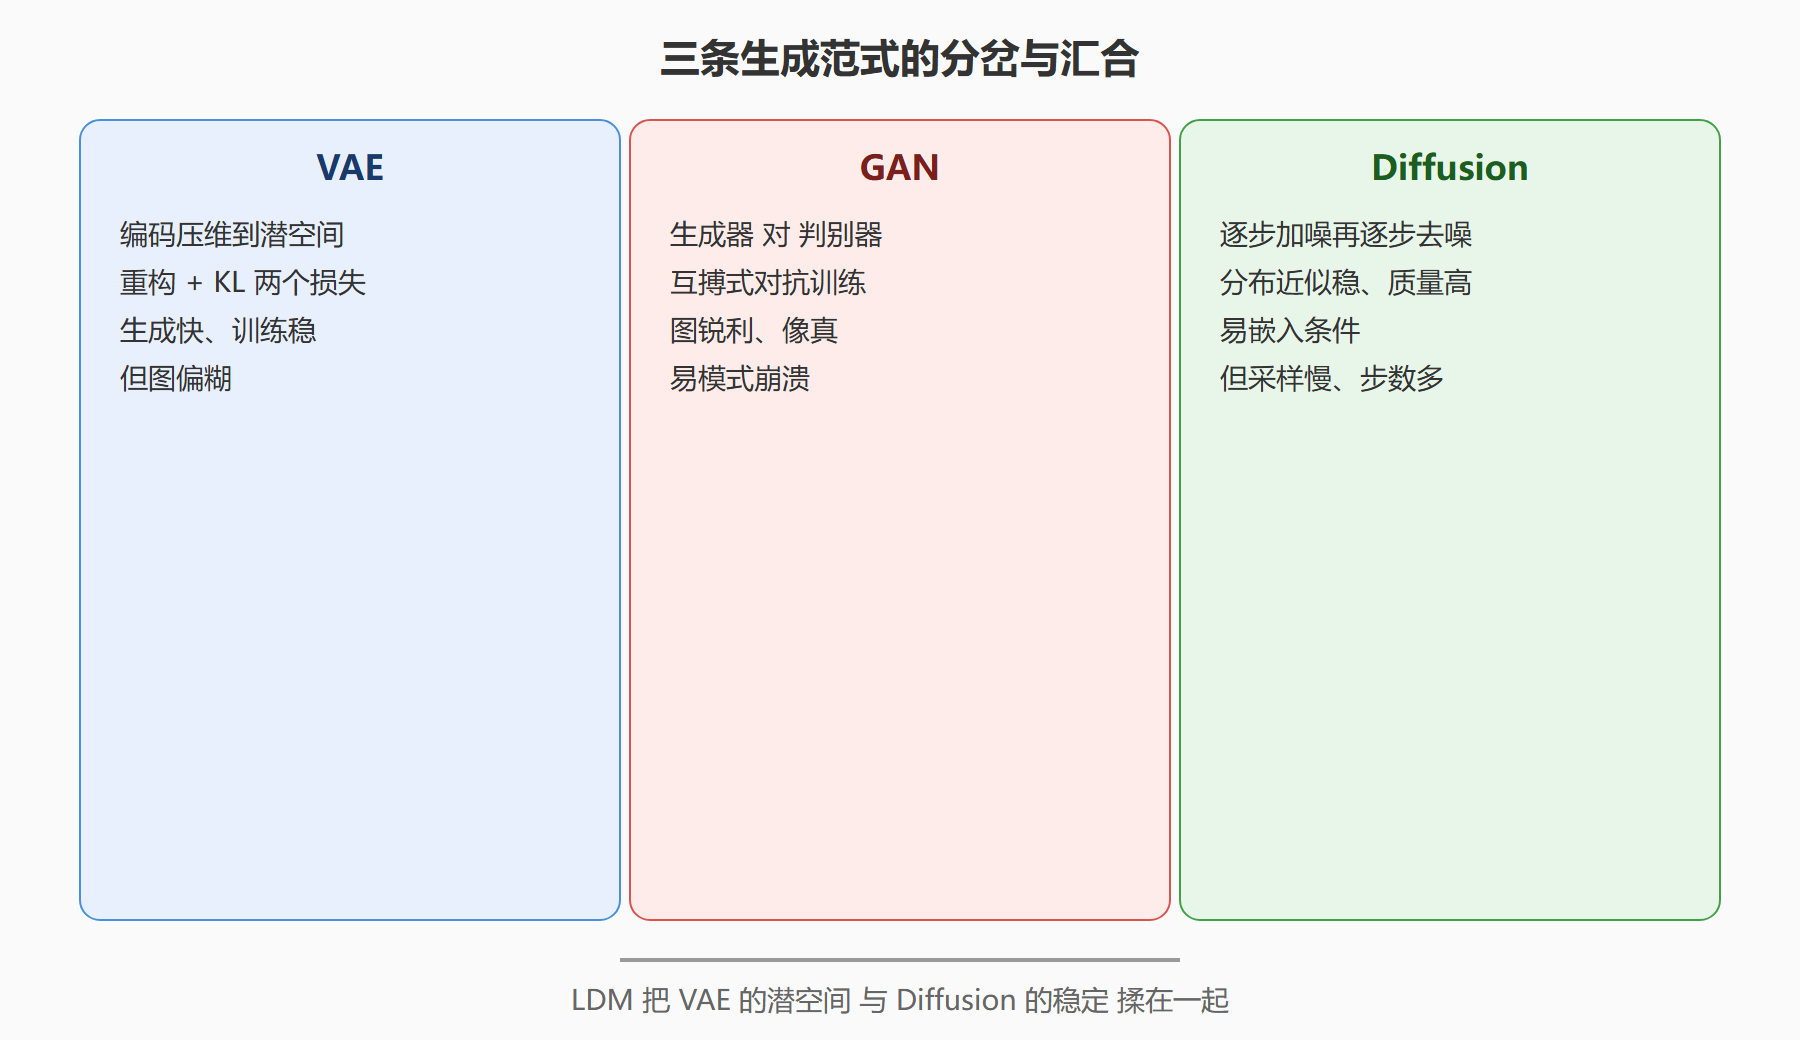
图标题:三种生成范式对比透视
上面这张图把它三者并排:左翼 VAE 胜在省力、中间 GAN 胜在锐利、右翼扩散胜在稳定与可控。下方的横线指向第三章的融合——这些范式不是孤岛。
叠加一张量化直觉
光看文字还不够,用一张手算的例子建立直觉。假设同样生成一张 256 分辨率的猫脸:
| 维度 | VAE | GAN | Diffusion |
|---|---|---|---|
| 训练信号来源 | 重构像素误差 | 判别器反馈 | 预测噪声误差 |
| 采样成本 | 单次前向,极低 | 单次前向,低 | 数百~上千次迭代,高 |
| 细粒度可控条件 | 弱 | 中等 | 强(可插在每步) |
| 端到端稳定性 | 高 | 低,易崩 | 高 |
| 代表去向 | 作为 LDM 的前置 | 用于超分/人像 | 文本到图像主力 |
结论也很清楚:如果你要的是又快又稳的可控生成,扩散是当前最省心的选择;如果你能忍受博弈式调参而追求极致锐利,GAN 在高分辨率人像上仍然能打;VAE 几乎不再单独直接生成,却以潜空间的形式活在扩散和主流模型的血管里。这就是"从 GAN 到 Diffusion"那句流行总结的真实含义——不是 A 杀死 B,而是更稳、更可控的配方接过了主力位置。
一条发展的主线:范式不是零和
把三个阶段连起来看,会发现它不是简单替代,而是一层一层往上叠。早期 VAE 教模型"用一个规整的潜在球去近似真实分布",解决了"怎么让分布可学习";GAN 教模型"用对抗的反馈逼出更锐利的细节",解决了"为什么生成的东西总糊";扩散则把问题整个反过来,教模型"从一团噪声逆向一步步擦回清晰图",从而同时拿下了稳定与可控。每套范式都留下了前一版做不到、后一版舍不得丢的遗产,最终的主流模型往往是混血:用 VAE 的潜在层省计算、用扩散的去噪保证质量、必要时再用 GAN 风格的后处理把边缘磨利。
这张演进关系也可以直接读成一句工程判断:新范式接管的是"训练与生成的支配权",而不是把旧范式的所有工具一锅倒掉。理解这一点,你会少走很多弯路——当有人举着某套老范式说"它现在还活着"时,他说的多半是它作为插件活在更大系统的某段管线里。
训练稳定性:最容易翻车的不是精度
站在一线视角,大多数团队翻车都翻在训练稳定性上,而这三套范式对稳定的要求完全不同。VAE 的反传路径最短、损失最直白,最稳定;GAN 需要同时维护生成器与判别器两套参数,任何一方的节奏失衡都会让损失来回震荡,收敛全靠经验和手调;扩散则因为目标简单(预测加入的那部分噪声)而异常稳定,只是要喂更多步数、更多轮次。这也是企业选型时常听的"扩散最省心"的底层原因——它不是最快的,却是最不容易半途爆掉的。
工程取舍与易错点
真正的行家不迷信范式,而是按任务挑。你会发现高分辨率超分场景仍常回落到 GAN 风格的后处理,因为人类观察上"锐利"往往优先于"多样";而任何需要"按你给的边、深度、姿态去改"的任务,扩散因其条件注入的天然优势几乎必然当选。工程上最容易踩的坑是三件事:一是用 VAE 去硬刚需要无条件锐图的场景,结果到处是糊斑;二是理解不了 GAN 的 mode collapse(生成器偷懒只画一种,判别器居然也被骗)就盲目加轮数,只能越来越锁死;三是对扩散的"慢"没有心理准备,随手把采样步数调到个位数,图刷得飞快但噪声压根没清干净,满屏花噪。
⚠️ 常见坑:贪快把扩散采样步数压得太低,原理上还没有足够轮次让噪声退场。
💡 关键直觉:范式无绝对优劣,只有"在什么任务上当前最像话"——选型的第一步永远是看清自己要的是锐还是稳还是可控。
本节要点回顾
- VAE:重构式、快而稳、图偏糊,靠潜空间活在融合模型里。
- GAN:对抗式、图锐利、训练易崩、怕模式崩溃。
- Diffusion:逐步去噪、稳、质量高、可控强、慢。
- 融合趋势:LDM 用 VAE 省力 + 扩散稳定的双赢组合,成为主流底座。
- 选型口诀:锐利找 GAN、省力找 VAE、可控又稳找扩散。
下一节起我们正式钻进第二章:把扩散那套逐步去噪写成马尔可夫链,配上前向加噪的调度公式。