2.3 训练目标与损失函数
2.3 训练目标与损失函数
扩散模型的训练目标是最大化对数似然的下界,即证据下界 ELBO。它被重写成逐时间步的期望,再在噪声域里化简为"均方预测噪声误差"。本节展示 ELBO 如何一步步变成培训常用的那行代码。
到了本节,训练那只网络时的"成绩单"就该看得见了。前两节我们把前向说成破坏、把逆向说成擦净,但真正让网络学会"擦得多准"的,是每一个 batch 里被反复最小化的那个实数。这一节就回答:那个实数到底长什么样?读者普遍在这里第一次被劝退,因为看到"证据下界 ELBO"这个名词就头大。我先把包袱抖掉:你不需要完整推 ELBO,你需要的是知道它为什么会一步步化简成最朴素的那行"预测噪声差了多少"的均方误差,然后学会怎么在供暖仪表盘上读它、怎么调它的陪跑参数。其余的是加分项。
从"让输出最像数据分布"说起
扩散模型的训练可以挂在一条古老的信念上:我们需要一个参数化分布,让它尽量贴近真实数据分布。最经典的做法是最大化对数似然期望。但这个目标在扩散这种高维连续场景里无法直接算出——你根本算不出每个样本上的归一化常数。于是我们把"直接最大化"降级成"最大化它的一个下界",这个下界就是 ELBO(evidence lower bound)。名字唬人,性质实在:它是真对数似然的忠实垫脚石,下界抬高,真实目标通常也抬高。
ELBO 第一版长这样:由"数据从噪声反向恢复"的期望项,减去"前向加噪链与被逆向近似链之间的一致性"项。它读起来仍抽象,但按扩散的分步结构展开,会逐项分解成每个时间步都会贡献的一项——这一步的分解是扩散训练"逐批可算"的根基。
一步步拆成能训练的形状
把 ELBO 按 T 个时间步展开,会得到三类项:一个只含初始态、一个收尾的最末端噪声项,以及主旋律——那些"在第 t 步,网络预测的噪声分布 vs 真实加噪分布"的差异期望。每一类都可以算,因为前向是已知的、噪声是标准高斯,且定时可采。于是训练目标被精细到"每个时间步都有一笔账要付",为下一步的简化铺路。
真正关键的化简出现在噪声域。原始 ELBO 里那一堆分布距离,对照 DDPM 的选型后,可以约成对"每一步预测噪声"的比较——把网络喂给当前状态和时间步,让它输出一个噪声预测,然后与真实注入的噪声做均方误差。注意路径虽长,终点极简:
import torch def diffusion_loss(model, x0, beta_schedule, t): # 前向闭式采样:直接算 x_t = sqrt(alpha_bar_t)*x0 + sqrt(1-alpha_bar_t)*eps alpha_bar = torch.cumprod(1 - beta_schedule, dim=0) eps = torch.randn_like(x0) x_t = torch.sqrt(alpha_bar[t])*x0 + torch.sqrt(1-alpha_bar[t])*eps # 让网络预测这一步注入的噪声 eps_pred = model(x_t, t) return torch.mean((eps - eps_pred)**2) # 均方预测噪声误差
就这样:一个 batch 里随机抽时间步 t,闭式算出 x_t,喂给网络预测噪声,和真实 eps 对一版均方误差,反向传播收敛。你数一遍会发现,前向的一半、逆向的一半都不直接出现在损失里——它们正交地隐藏在调度与采样构造里。这就是为什么第二章一再强调模型输出是"噪声",而不是"干净图"。
把"ELBO 怎么一路约到均方噪声误差"这条变形链画出来,会更直观看到每一步丢掉了什么、保留了谁:
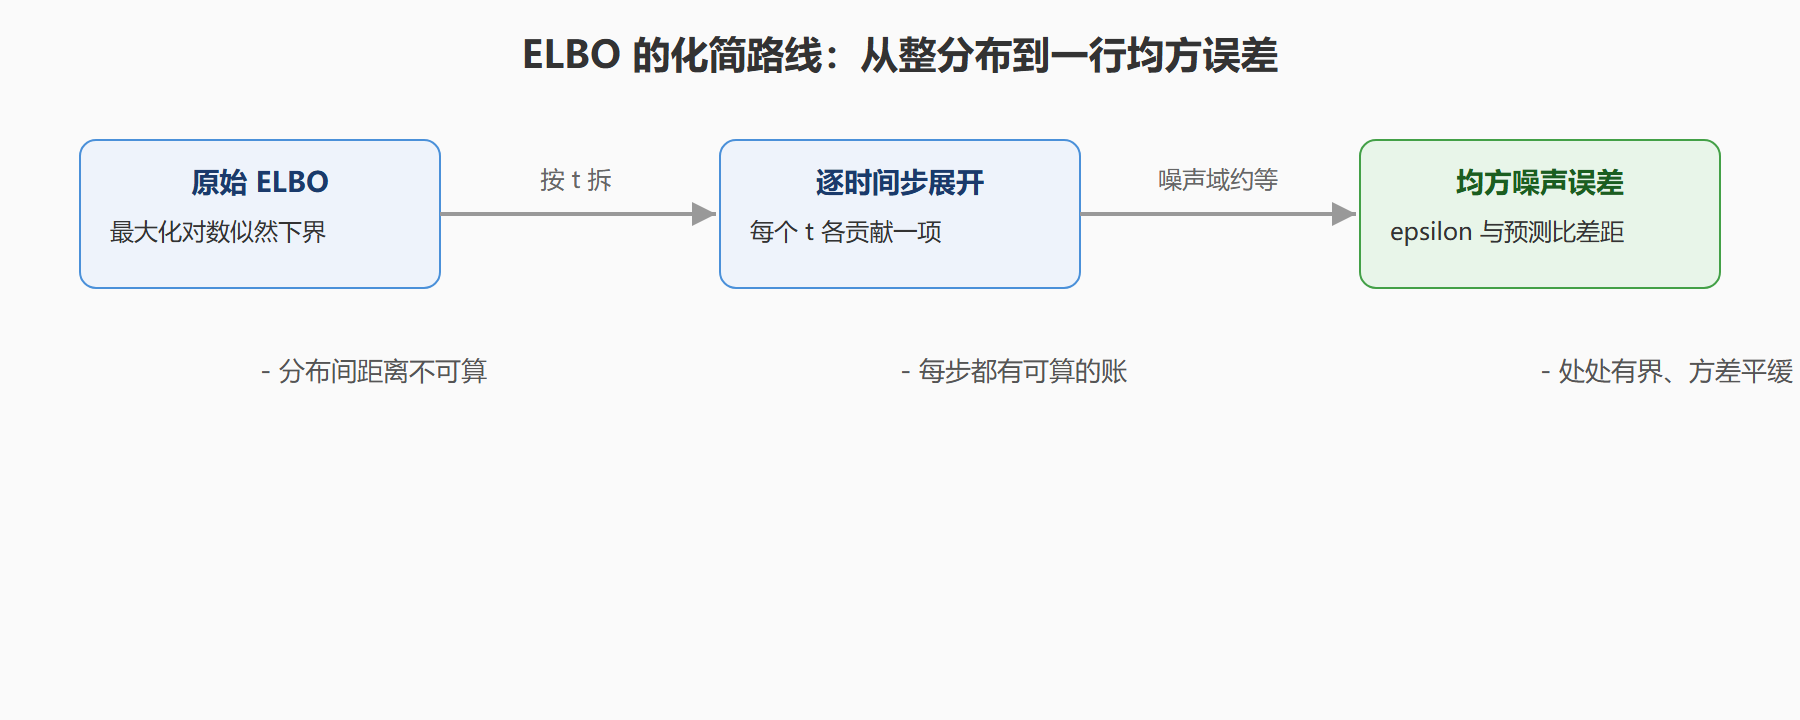
图 2-1:ELBO 化简路线
读这条链会发现,每次约简都在"把不可算的整分布距离,换成逐时间步、再换成噪声域里一处有界的标量差"。每换一次,损失就更好实现一点、梯度更平稳一点,而"逼近对数似然"的成分始终被保住。
为什么"预测噪声"比"预测原图"更稳
这值得单独讲。如果改让模型直接输出原图 x0,损失同样能写,但经验上更不稳、更难收敛。原因在于:越临近纯噪声那几步,原图已经几乎不可观测、可解信息极少,直接回归原图会让损失被这几步的巨大方差支配,训练摇晃得厉害。而预测噪声在噪声域里处处有界、方差平缓,各个时间步的难度相对均匀,模型更容易稳定收敛到"全都擦得准"。这个设计选择在 DDPM 原文里是决定性的,此后几乎所有变体(包括第三章的一致性模型)都继承了"预测噪声或与其等价的形式"这一做法。
配套的尺度还会做一次按时间步的权重均衡(有些步难、有些步易),让难步不被简单步淹没。这是许多实现里"对某个系数按 alpha 归一化"的由来,看懂这一条,你在调权重系数时就不至于瞎试。
一个 batch 的训练节奏
把训练再沿工程视角过一遍,你会得到一个特别简洁的循环。每次取一个 batch 的干净图,随机给每张图抽一个时间步 t,前向闭式给它们灌进不同程度噪声得到 x_t,喂给网络拿预测噪声,和真实 eps 算均方误差回传。整个过程没有"逐帧仿真一整条链",也没有"存下所有中间态",只有一图一步一次前向。这也是为什么扩散对显存并不苛刻、对小团队也友好。
| 环节 | 在损失里出现吗 | 备注 |
|---|---|---|
| 前向闭式采样 | 只提供输入 x_t | 可不逐帧仿真 |
| 预测噪声网络 | 是,唯一可训练部分 | 输出噪声而非原图 |
| 调度与采样器 | 仅在步长/权重里 | 参与定义但不直接回传 |
| 真实注入 eps | 是,作回归目标 | 训练时随机采样一次 |
读这张表你会发现,真正被优化的只有"预测噪声网络"这一环,其余都是配合者。理解分工,你调试时就知道该往哪个环节下手:训练不收敛多半在幅度配置,出图花噪往往要回头看调度。
⚠️ 常见坑:见到 ELBO 就以为要真等。实践中我们从"预测噪声的均方误差"起步实现,ELBO 只是证明这行代码"在合法地逼近对数似然"的通行证。
💡 关键直觉:损失祈祷的是"每一步都擦准一点点",而不是"一口气擦出完全体";分步的目标天然更适合深度网络稳定训练。
本节要点回顾
- 训练落在 ELBO 上:最大化对数似然不可行,改为优化其下界 ELBO。
- 逐时间步展开:ELBO 每个 t 贡献一项,训练才逐批可算。
- 末端化简为均方噪声误差:网络预测噪声,与真实注入噪声比差距。
- 预测噪声更稳:噪声域有界平缓,免被高方差难步拖垮。
- 权重均衡:按时间步分配难度权重,防止简单步淹没难步。
采样这一步的成本总算有了交代,下一节就来讲怎么少走几步——把 DDPM 换成 DDIM、DPM-Solver 这类加速选手。