2.4 采样策略与加速技术
2.4 采样策略与加速技术
DDPM 采样动辄上千步,DDIM 通过去随机化把步数压到几十步左右且可做轨迹编辑,DPM-Solver 则用高阶快速解法进一步压缩。本节对比 DDPM、DDIM、DPM-Solver 三类采样器,给出手选步数与质量的权衡直觉。
看完 2.3,你手握一个"训练过的去噪网络",但一个残酷的问题随之而来:按原配方从 t=T 一步步走到 t=0,要跑一千步。你在一台消费级显卡上生成一张 1024 的图,可能要等几十秒甚至更久。艺术创作是允许等的,但你在刷图、改提示词、调参的时候,一分钟一张简直像放幻灯片。这一节的主角不是网络本体,而是"采样器"——一套决定"怎么走、走几步能到"的膳食方案。搞懂采样器,你才会明白为什么同一个模型在有的软件里几秒出图、在另一些配置里慢吞吞。
DDPM:谁都能走,但腿脚笨
DDPM 的采样是我们 2.2 看到的那套"纯噪声起步,按调度系数一步步迭代"。它每一步都包含一次高斯重采样注入微小噪声,这让生成轨迹带很强的随机性,也正是多样性所在,但代价是步数必须够多(通常 1000 步)才不会糊。随便把步数压到几十步,DDPM 会当场还给一张花噪图。它像一位老实但每一步都在原地抖一下的画家,画一万笔才肯交卷。
DDIM:去掉多余的摇摆
DDIM(Denoising Diffusion Implicit Models)的思路,是把采样过程中那步"随机重采样"关掉,做成确定性的确定性迭代。因为去掉了随机抖动,同样步数下它能跑得快得多,几十步就能出质量可接受的图;更重要的是,确定性意味着同一噪声起点永远得到同一结果,这条性质带来一个副产品——你可以把生成过程当成一张可以在中途"换向"的路径,用于图像编辑(在潜在投影里改写)。所以 DDIM 常被形容为"既能快,又能编辑"。
一点代价要说清楚:确定性牺牲了一部分多样性。两个不同的起点在大步数下可能收敛到更接近的结果。对多数用途(跑图、改图)这是划算的交换。
DPM-Solver:用高阶数学在少步数里跳远
DPM-Solver 换个发力点:它不再逼着模型走原始 ODE 的每一步,而是利用扩散逆向对应的一阶常微分方程的结构,用高阶近似直接预测"大跨步"后的状态。它的效果是,十步以内常常就能达到 DDIM 几十步的质量,堪称"一步顶好几步"。它特别适合在意延迟的交互场景与移动端。代价是数值实现更敏感,个别噪声下可能出现轻微伪影,需要挑版本。
这三条路线放在一张对比表里看得更清楚:
| 采样器 | 需要的步数量级 | 随机性 | 典型用途 | 小坑 |
|---|---|---|---|---|
| DDPM | 上千 | 高 | 保质量、高多样性 | 太慢 |
| DDIM | 几十 | 低 | 快速出图 + 可编辑轨迹 | 稍微锁多样性 |
| DPM-Solver | 个位到十几 | 中 | 低延迟、移动端 | 数值敏感 |
关键参数:步数、调度重采样与 CFG 的协同
实战里你几乎不给采样器一个大参数就让它跑,而是配合两个旋钮一起拧。第一是"步数",一般从二十到五十之间调:步数太少,DDIM 类噪声没擦净;步数太多,边际收益越来越小但时间线性上升。第二是"调度曲线"与环境里默认的选择,它会细化每一步步长,跟采样器类型轻微联动。还有一节独立变量——分类器自由引导 CFG 的强度,它会放大"往提示词方向走"的权重,往往和采样器一起牵动最终效果。这一层在第六章讲条件控制时要再展开,这里先记住:它们不是孤立的三个按钮,而是一起决定最终画质的三驾马车。
一段能帮你在脑子里锚定的采样骨架(把 2.2 的 scheduler 换成具体实现):
def generate(model, scheduler, noise, steps, cfg=7.5): # scheduler 按所选采样器(DDPM/DDIM/DPM-Solver)初始化 for t in range(steps, 0, -1): # 在关键实现里,正向提示与空提示各算一次去噪,加权得到引导 eps_uncond = model(noise, t, cond_text="") eps_cond = model(noise, t, cond_text="一只戴小帽的橘猫") eps = eps_uncond + cfg * (eps_cond - eps_uncond) noise = scheduler.step(t, eps) return noise
图标题:采样器中步数压缩示意
上面的折线示意图表达"从纯噪声到清晰图,采样器按大步长跳着走"——你不用真跑满整面时间轴,只用给出构建在大跳跃点的逐次去噪。
步数与质量的收益曲线
"步数加一倍,质量是不是也涨一倍?"答案是否定的。大多数采样器的质量收益呈饱和曲线:开头寥寥几步就能把主体轮廓刷出来,随后质量爬升越来越缓,到某个步数后几乎拉平。若把 DDIM 和 DPM-Solver 两条曲线画在一起,会发现后者曲线的饱和点明显更靠左:
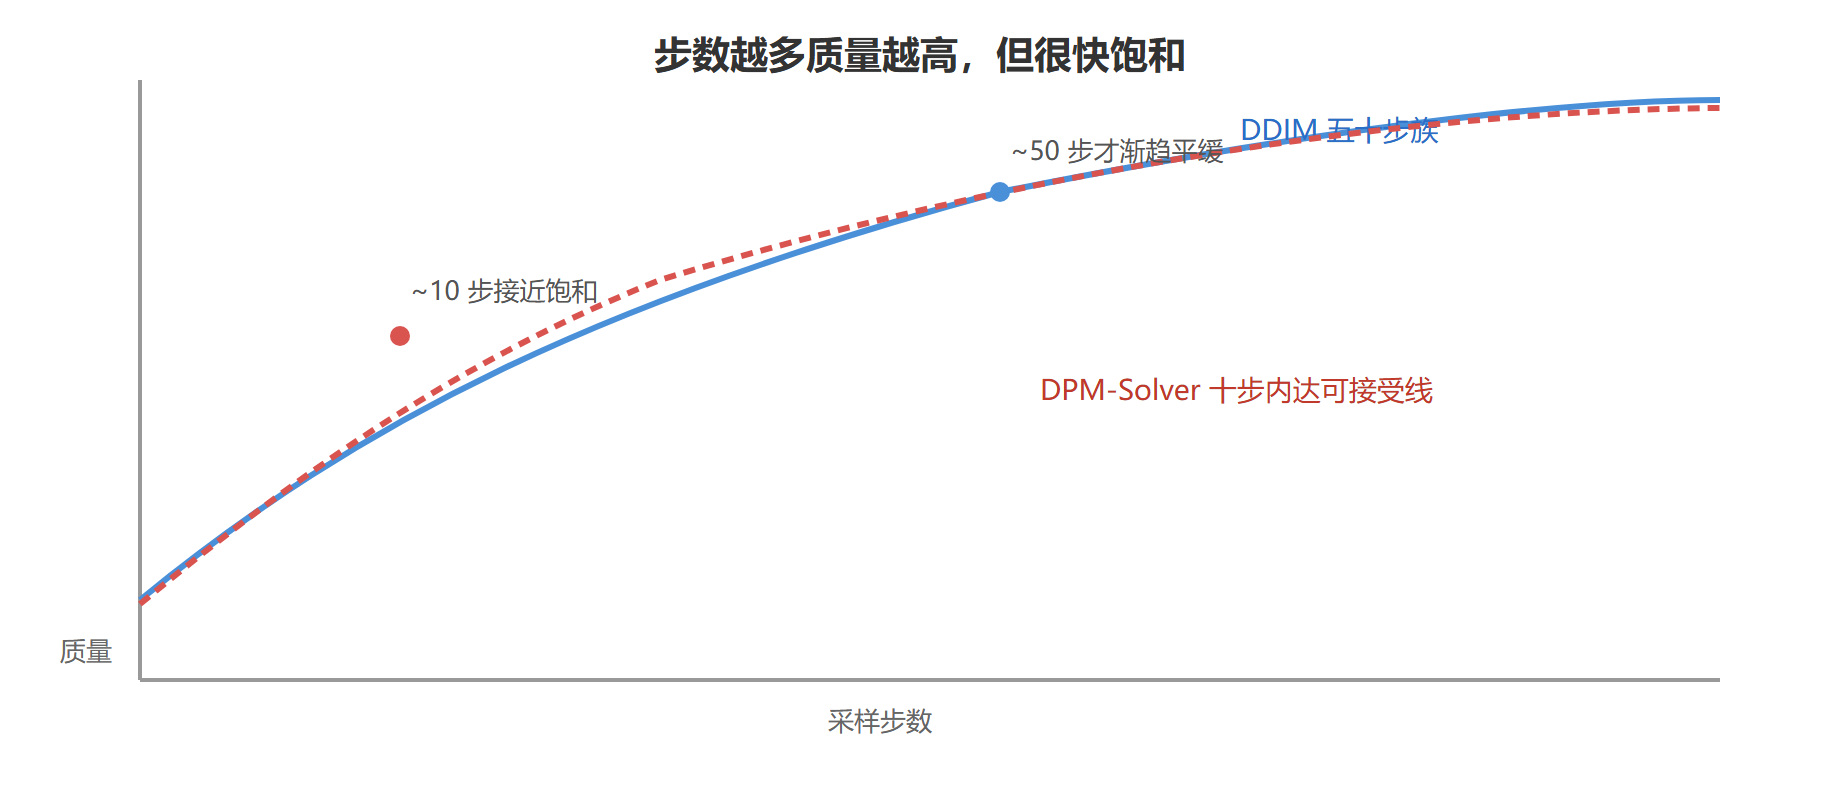
图 2-2:步数-质量收益曲线
读这条曲线得到的实操结论很简单:超过某个步数后再加步,视觉上的差别往往比你想象的小得多,白烧时间。挑步数的合理姿势是先取一个中等值看效果,再按需微调,而不是一上来就拉满.
工程取舍
如果让我给一个默认起点:生产环境下先用 DDIM 五十步配 CFG 约 7.5 建立基线;需要更低延迟时换 DPM-Solver 并压到二十步以内,然后看质量是否还在可接受线。纯探索或需要最大多样性时,才回到接近 DDPM 的高步数配置。核心原则只有一条——步数是你对"速度 vs 质量"的明码标价,采样器则是怎么把这个预算花得更值的策略。
⚠️ 常见坑:数字上乱开步数又迷信花时间必出好图。提前告诉读者,很多默认模型在超过某步数后质量曲线就拉平,盲目加步只是在烧时间。
💡 关键直觉:DDIM 去随机化换编辑性,DPM-Solver 用高阶换算步数,你的预算就该按用途分配:编辑走 DDIM、低延迟走 DPM-Solver。
本节要点回顾
- DDPM 起点:高步数、带随机抖动,保多样性但慢。
- DDIM:去随机化、确定性,几十步可用并可编辑轨迹。
- DPM-Solver:高阶近似,十步内接近更高步数质量。
- 三驾马车:步数、调度、CFG 强度协同决定最终画质。
- 默认起点:先建基线再按延迟压步数,按用途选采样器。
下一节回答"怎么指挥模型往指定方向画"——类别标签、文本嵌入、图像条件是怎么塞进去噪网络的。