3.2 一致性模型与高效变体
3.2 一致性模型与高效变体
一致性模型避开"一步步去噪",训练一个映射,让同一轨迹上任意时间步的图像都直接指向最终干净图,从而做到一步或几步出图;蒸馏类方法与量化压缩进一步为延迟优化加码。本节对比这些高效变体的思路与代价。
第三章的前一站,LDM 帮我们把"算力"砍了下来,但"采样要跑很多步"这个慢的根源还在。这一节要正面刚快的问题。答案是几条更激进的路:一致性模型(Consistency Models)试图训练一张"直达票",让网络从任意一个带噪状态直接跳到最终干净图,省掉一轮轮迭代;蒸馏与量化则在模型的"体型"和"步数"上做减法。你只要记住一个总纲——它们都在用"一点点质量,换明显更快的速度",怎么平衡这笔交易是本节的中心。
一致性模型:把"阶梯"画成"直达梯"
常规扩散生成像爬楼梯:从噪声一步步下到干净图。一致性模型的聪明之处,是定义一条"一致性"约束:处在同一条去噪轨迹上的所有状态,经过网络映射后应该收敛到同一个终点(即该轨迹对应的最终图)。也就是说,它训练网络把所有沿轨迹的时间步状态"拉平"到结论,让它自己成为一把电梯而不是一段梯子。推理时从任意噪声起步,常常一步或几步就出结果,速度轻松比传统 DDPM 快一到两个数量级。
代价同样明显:投射到"直接终点"的归纳偏置,会让一些需要中间过程细腻推敲的细节(复杂物件、脸部、文字排版)在低步数下不那么稳;而且训练一致性模型需要更仔细的一致性损失设计,否则在分布边缘会出现跑偏。它的价值在于把扩散降到极低延迟,天然适合实时交互、批处理量巨大的落地场景。
同一桩交易的其他做法
除了换训练目标的一致性模型,生态里还有两条常见的求快路径:
蒸馏(Distillation):用一个老师(多步扩散)已经很稳的模型,训练一个学生模型去"一步学出老师花几十步才得出的结论"。步子当然能更少;但学生不容易完全保住老师在高频细节上的手艺,且每个要压缩的场景往往需要重新蒸馏一轮。
量化(Quantization)与剪枝:把权重从高精度压到低精度,或把冗余参数剪掉,让每一步本身的计算变便宜。路线不对推理步数这根弦,而是把每步成本压薄。低精度在边缘设备上尤其划算,但压得过头会引入数值误差、伪影加重。
三条路径其实回答了同一个问题的不同切口:
| 求快方案 | 动的是哪根弦 | 典型步数 | 主要代价 |
|---|---|---|---|
| 一致性模型 | 训练出直达映射 | 1~几 | 高细节稳定性下降 |
| 蒸馏 | 把老师结论压进学生 | 几步~几十 | 每新场景要重训 |
| 量化 | 压薄每步权重精度 | 不变步数 | 数值误差、伪影 |
一步、还是多步,怎么选
落到工程上,你先问自己三个问题:这个场景有多不能等?输出的细节精细度有多不能妥协?手头的设备算力是什么水平?然后是三条默认规:实时预览、大量过滤素材用一致性模型或蒸馏后的一步模型;高质量成图、打样给客户看,保留多步采样并配高步数;在手机、嵌入式上跑,必用量化降精度,缺一步模型再补蒸馏。
另外一个容易踩的坑是:很多人以为"步数少"必然等于"质量差"。要纠正:一致性模型和蒸馏的目标就是让低步数也能接近多彩结果,问题只在细节区。用默认步数跑一遍,对比它在人脸、文字、器物边缘的表现,再决定要不要加步。你手边最好是同时备着一套"快档"和一套"稳档",按任务切换,而不是在同一档位上硬刚到底。
一致性修炼:同一轨迹被拉到同一终点
所谓"直接一步出图",在训练上其实是一件很反直觉的事:它不是凭空让网络学会画画,而是逼着它遵守一条"一致性"约束。落在同一条去噪轨迹上的各个中间态,本该一路演化到最后那幅图;一致性模型的要求是——无论我从轨迹上的哪一点出发,网络输出都得指向同一个终点。下面这条并列的演化路线示意了"多点归一"的意思:
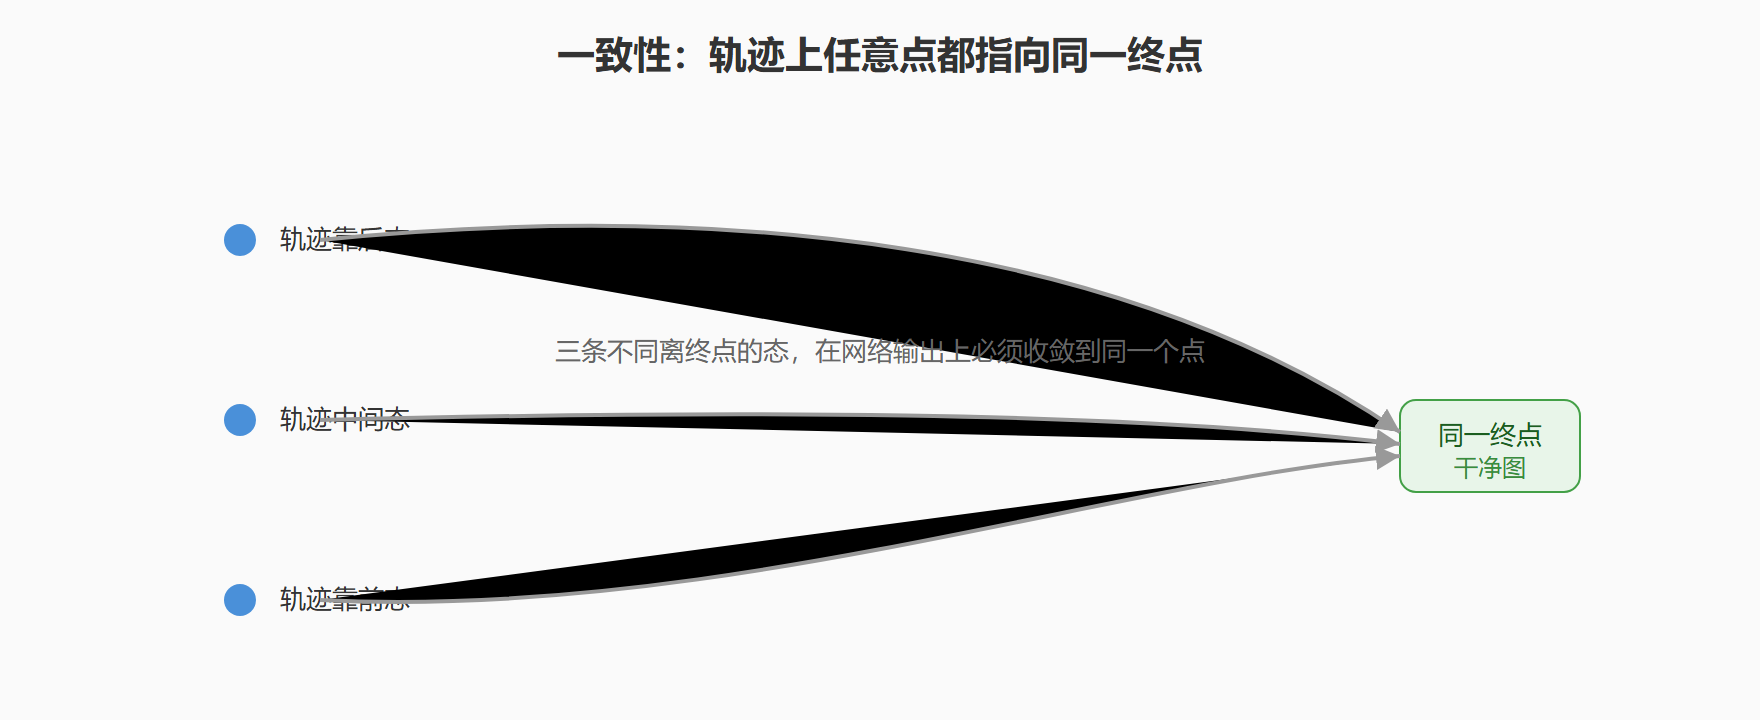
图 3-1:一致性模型的轨迹坍缩
正是因为网络被训练成"处处殊途同归",推理时才不必一格一格往下走——随便从哪个带噪点出发,一把推到终点即可。代价是中间过程被压缩,那些只有逐帧推敲才能拿稳的细节总要付出一点稳定性。
# 快档 vs 稳档,同一批中性偏好对比示例 def render(model, noise, steps, tag): if tag == "fast": # 一致性/蒸馏路径,步数设到很低 out = model.direct_from(noise) # 一步直达 else: out = sample_multistep(model, noise, steps) # 稳档逐轮去噪 return out
图标题:一致性模型、蒸馏与传统扩散的路径对比
上面三条支线从同一噪声起点出发:一致性模型一步直达、蒸馏学生少步到达、传统扩散多步慢攀,最终都汇聚到一张最终图。三角形越偏向"一步直达",留给中间过程的细节推敲就越少。
快档与稳档在生产里怎么共存
把一个真实的产品拆开看,你几乎总能在它内部同时看到快慢两套档位,而不是只留一种。拿常见的一站式出图产品举例:用户在输入框里改字、来回试风格时,后台跑的是低步数的一致性模型或蒸馏学生,因为这一阶段只追求"差不多能看出方向"的秒级反馈;一旦用户点下最终导出,后台就切到高步数稳档采样,把细节、人脸、文字排版都打磨到位。这么分工的好处是直觉又经济:探索阶段犯错成本低,用快档反复试;交付阶段容错低,用稳档一次到位。理解了这个"双档位"设计,你在做自己的工具时就不会陷入"到底快还是稳"的二选一困境——答案是两个都要,只是各分配在流程的不同位置。
本节要点回顾
- 一致性约束:同一轨迹各状态映射到同一终点,训练出直达映射。
- 速度收益:一步或几步出图,比 DDPM 快一到两个数量级。
- 蒸馏与量化:分别从"条数"与"每步成本"上压缩延迟。
- 交易双方的账:拿高细节稳定性换速度是共同代价线。
- 默认配档:快档给交互预览、稳档给打样,按场景切换别硬刚。
一致性模型"一步直达"的思路很妙,但它的理论血缘要从更古典的数学学起。下一节就用"分数"这座桥,把扩散和更早的能量基模型连起来。