3.1 潜在扩散模型与级联扩散
3.1 潜在扩散模型与级联扩散
潜在扩散模型(LDM)先用自编码器把高分辨率图像压进低维潜在空间,再在潜在空间上跑扩散,从而大幅降低显存与算力;级联扩散把高分辨率生成拆成低清定结构、高清补细节多级。本节给出 LDM 流程透视与级联分工对比。
第二章的一切都发生在像素域:你对着一张 512 乘 512 的噪声图做逐像素去噪,一次前向就好几个 G 的显存。真到生产环境,这个数字让人肉疼。这一节讲的 LDM,正是主流模型(Stable Diffusion 的根基)绕开这条高负载路线的设计选择。它的核心主张朴素得反直觉:先别对着整幅高分辨率像素做扩散,而是先把图狠狠压扁,在又短又小的一片"浓缩画布"上完成主要博弈,最后再解压回全分辨率。算力大头因此被砍。
读这一节之前,你要把第一章埋的两颗种子提起来:一是"潜在空间"——编码器把高维像素压成可解释的低维向量;二是"去噪网络",其后的一切都在这片低维空间里进行。LDM 就是把这两个概念拼起来当地基盖的房子。
LDM:先在浓缩画布上博弈
LDM 的骨架分两段。前段是一个自编码器(常叫 VAE,与第一章讲的一致):编码器把一张 H 乘 W 的图压成一块小得多的潜在特征,解码器负责从这块小特征还原回原图。后段是扩散主体,跑在这块小潜在特征上而不是像素上。整条链路读起来是:真实图 → 编码进潜空间 → 在潜空间逐步加噪/去噪 → 解码回像素。
因为潜空间维度低,扩散每步的计算量跟像素域完全不是一个量级,显存与时间都节省一个数量级。更重要的是,潜空间通常更语义化——相似语义的东西在潜空间靠得更近,这给文本控制(把文本嵌入接到这一层)提供了更省力的熔炉。这就是为什么 SD 系列的文本条件大多挂在潜在空间上。
LDM 全过程可以画成一条带压缩的流水线:
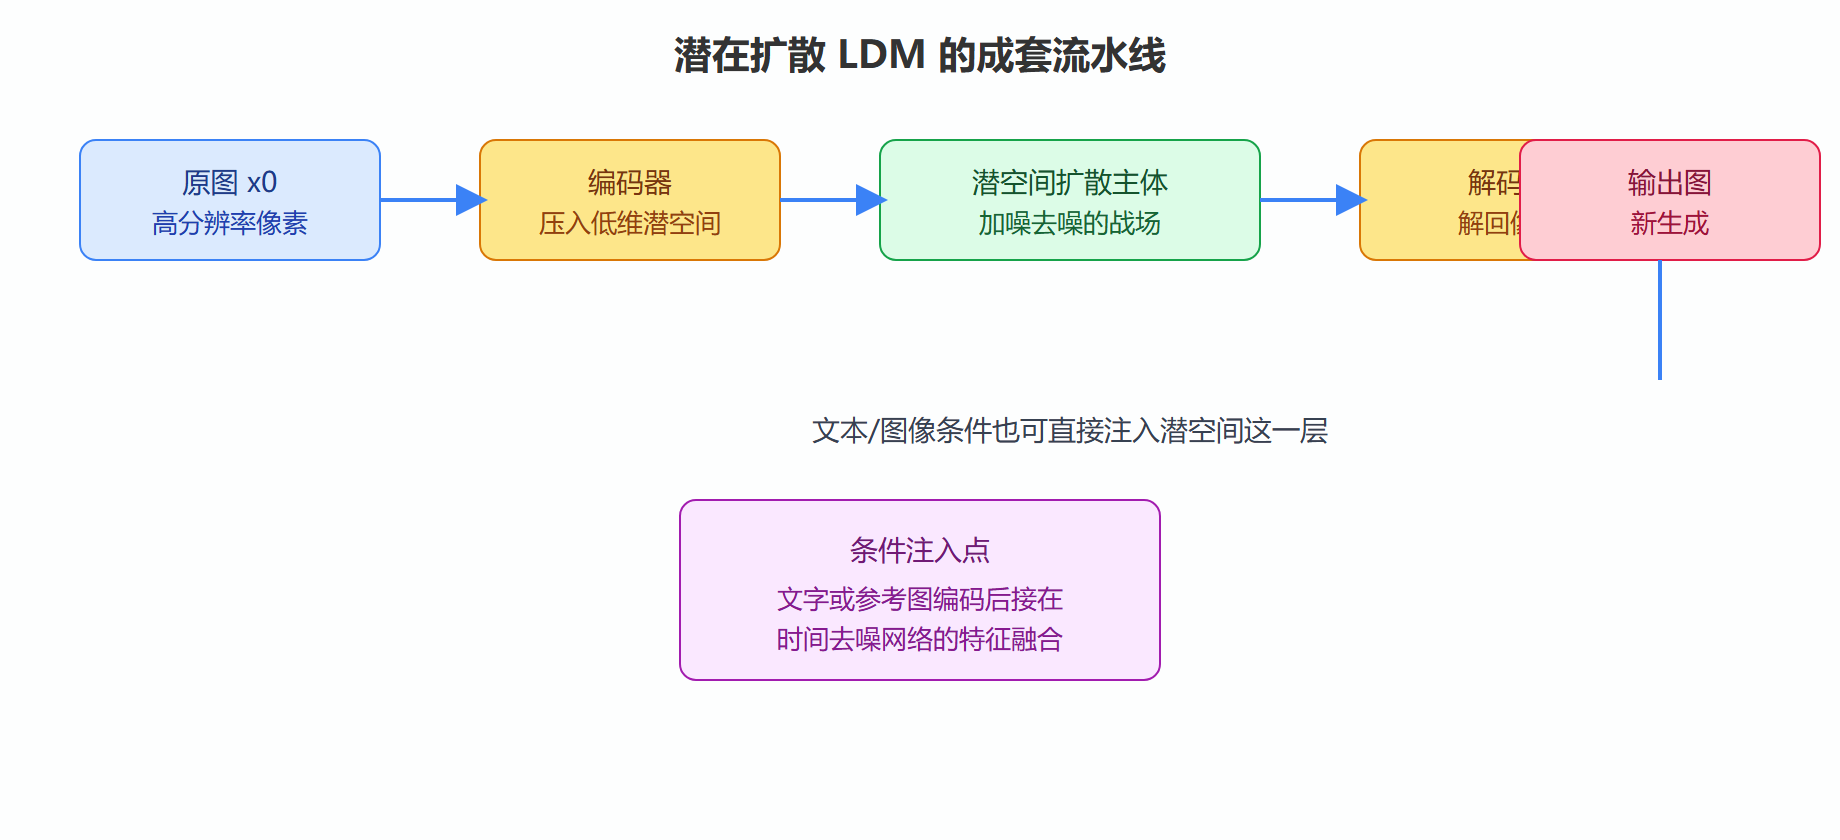
图标题:潜在扩散 LDM 流水线透视
上图为 LDM 的六段链路:左边原图经编码器增压到中段的低维潜空间成为扩散战场,再经解码器解回输出图;条件注入点(右下)是文本或参考图控制的主要熔炉。它把第二章"纯在像素上跑"升级成了"先在浓缩画布上跑"。
级联扩散:先定骨架再补毛发
哪怕做了 LDM,一次就生成 1024 甚至 2048 的大图仍是挑战。级联扩散(Cascaded Diffusion)换个思路——把分辨率拆成多级来完成。先跑一个低分辨率模型生成"构图骨架"(比如 256),再把这张低清图喂给下一级高清模型,让它在这张已有结构上补细节、提升分辨率(比如 256→512→1024)。每一级只负责一个具体的尺度,网络负担被分摊,级间的质量监督让每个尺度都能被针对性地训练。
这套"先定结构、再磨细节"的办法,也是后面图像超分、放大后处理这一族做法的血缘。它和 LDM 并不互斥——现实中完全可以是"潜在扩散定结构 + 级联上采样补细节"的组合拳。
| 分工 | 负责什么 | 代价 |
|---|---|---|
| 低清级 | 构图、语义、大局 | 细节糊、小物件错位 |
| 高清级 | 补纹理、锐化边缘 | 易在脸/手上出伪影 |
| 级间监督 | 教高清级别跑偏 | 需额外标注或重投影 |
压缩比:省多少、又丢什么
LDM 之所以能省下量级算力,底层靠的是把整幅图"装进一小块潜在特征"。以常见的 8 倍下采样、通道数十为例,一张 512 乘 512 的图被压成 64 乘 64 乘若干通道的潜在切片,扩散战场从百万级像素缩到几千个单元。下表给出三个典型档位的感觉:
| 下采样倍数 | 256 图对应的潜在尺寸 | 算力感受 | 可能的失真 |
|---|---|---|---|
| 4× | 64×64 | 相对省 | 细纹理偶发糊 |
| 8× | 32×32 | 中 | 字和人脸细节打折 |
| 16× | 16×16 | 最省 | 结构易变异、需强解码 |
压缩比不是越大越好:压得越狠,潜在切片装载的语义越浓缩,解码器要"脑补"的细节越多,越容易出现"高分但内容别扭"的结果。所以主流的落地取值多在 8 倍左右,在算力与细节之间取一个实用的平衡点。理解这条权衡,你就能解释为什么同一个模型同一个提示词在不同下采样配置下,细节表现会有肉眼可见的差别。
量化与感知损失:质量由谁兜底
顺着压缩这条线再往里走一层,LDM 还有两个隐蔽的质量开关。其一是对潜在特征做离散量化:把连续的小数切成有限的"刻度值",相当于给浓缩画布再压一道,换来的是便于压缩存储与后续建模的整洁,但代价是原本微妙的连续渐变可能会带上"阶梯感"。其二是感知损失——训练解码器时不再只看逐像素是否贴近,而是额外拿一个预训练网络比较高层语义是否一致,让"看着像"优先于"逐点像"。这两者合起来,等于回答了"压扁之后谁来赎回细节"这个问题:不完全靠解码器硬猜,而是靠"离散刻度 + 语义监督"双保险。看懂这两个旋钮,你在选模型版本时就会多一个比较维度——同样的 LDM 家族,换了量化格数与感知损失的权重,观感就会有可感知的差异。
⚠️ 常见坑:把 LDM 的"潜空间"误当"已经是在图像上做超分"。LDM 输出仍是解码回像素的结果,它省的是计算域,不是省下清晰度。
💡 关键直觉:把镜压缩到潜空间去做主战场、把尺度拆成多级去推进——这两招的本质都是"把生活的重活卸给最擅长它的那一个模块"。
与主流模型对口
读到这里你应该已经把它和真实世界对上了:Stable Diffusion 系列本质就是 LDM 的工程版——自编码器压潜 + UNet 去噪 + 文本条件,三者正是本节流水线的主要零件;而 DALL-E、若干超分方案则用到级联思想。SDXL 等高分辨率模型往往同时用到潜在扩散和级联上采样两者。掌握了本节,你在第九章动手时就不至于被一大票缩写绕晕。
一个常被忽略的工程细节是:LDM 的潜在空间并非唯一一种——有的实现用像素屈光度更低的自编码器,有的在潜在层上再做一次小量离散量化。选择不同,解码后的画质、压缩味、对条件注入的敏感度都会有差异。因此面对"哪个模型更好"这类问题时,别只看发论文的名字,更要看它的潜在尺寸、压缩比和文本注入位置;这些字段通常就在模型卡的最前面几行,读得懂就是差距。
本节要点回顾
- LDM 骨架:编码压潜 + 潜域扩散 + 解码回原,砍算力、利于条件注入。
- 文本条件挂潜空间:语义距近,更省力地建立图文对齐。
- 级联分工:低清定结构、高清补细节、级间监督防跑偏。
- 两者可叠加:LDM 定结构 + 级联上采样,是高清主流配置。
- 与 SD 对口:Stable Diffusion 即 LDM 的工程实例,SDXL 常用潜在+级联。
下一节要在大砍速度这件事上加码:一致性模型怎么做到一步乃至几步就出图,又为此放弃了什么。