7.1 生成质量与多样性评估
7.1 生成质量与多样性评估
评估生成模型的第一对主轴是"质量高低"与"多样充分"。FID 用真实与生成分布的特征距离衡量两者合一,IS 用分类器置信度衡量质量与多样,各有盲区。本节拆开 FID、IS 的数学性格,给出解读与反误用清单。
一句"这批生成得好不好"其实是两件事缠在一起:单张好不好看(质量),以及这一批有没有重去看一个模样(多样性)。很多工具把这两件事揉进一个数字里,好处是省事,坏处是你一听数字就拍板、结果被那个数字骗得团团转。这一节的任务就是让你看穿这些数字的"性格"——它们各自优先保护什么、对什么样的失败完全无感。
FID:两面是同的一把尺
FID(Fréchet Inception Distance)是当下最被广泛引用的生成质量指标。它把真实图和生成图分别送进一个预训练视觉网络(通常是 Inception),在其特征层算出两个分布的均值与协方差,再算这两个高斯之间的 Fréchet 距离。数值越小,说明生成分布与真实分布越接近——它是"分布越像越好"这一信念的量化。
FID 的强项在于它一次抓住"整体像不像":不会因为你单独某一张嘴糊了而崩溃(分布距离对个案不敏感),但反过来也是它的盲区——如果某个 user 常见的失败模式集中在小部分样本上(如偶发手指多一根),这批的平均统计可能照样被别的高质量样本掩盖过去。它也不感知"是不是正合题目",是一个纯粹的分布相似度尺。
IS 与"质量×多样"的纠缠
IS(Inception Score)走另一条路线:它把生成图送进分类器,看分类器"多有信心"地给它分到一个类(置信度高代表像某一类的真实样本)以及"用得有多散"(类别分布均匀代表多样)。IS 就是"质量越高越自信"与"类别越分散越好"乘积的粗略打包。它当年是评价能力的天花板,但其缺陷现在已经人尽皆知:对一张"模型把一堆错误类别却高置信猜到"的生成图,IS 可能反给高分,因为它只看"是否自信",不查"是否该是这个类"。
一句话总结两者的分工与坑:FID 关心"跟真的像不像"、对个案失败迟钝;IS 关心"自信 & 多样"、会奖励"自信的错误"。
把"哪个指标偏袒哪种失败"画出来:
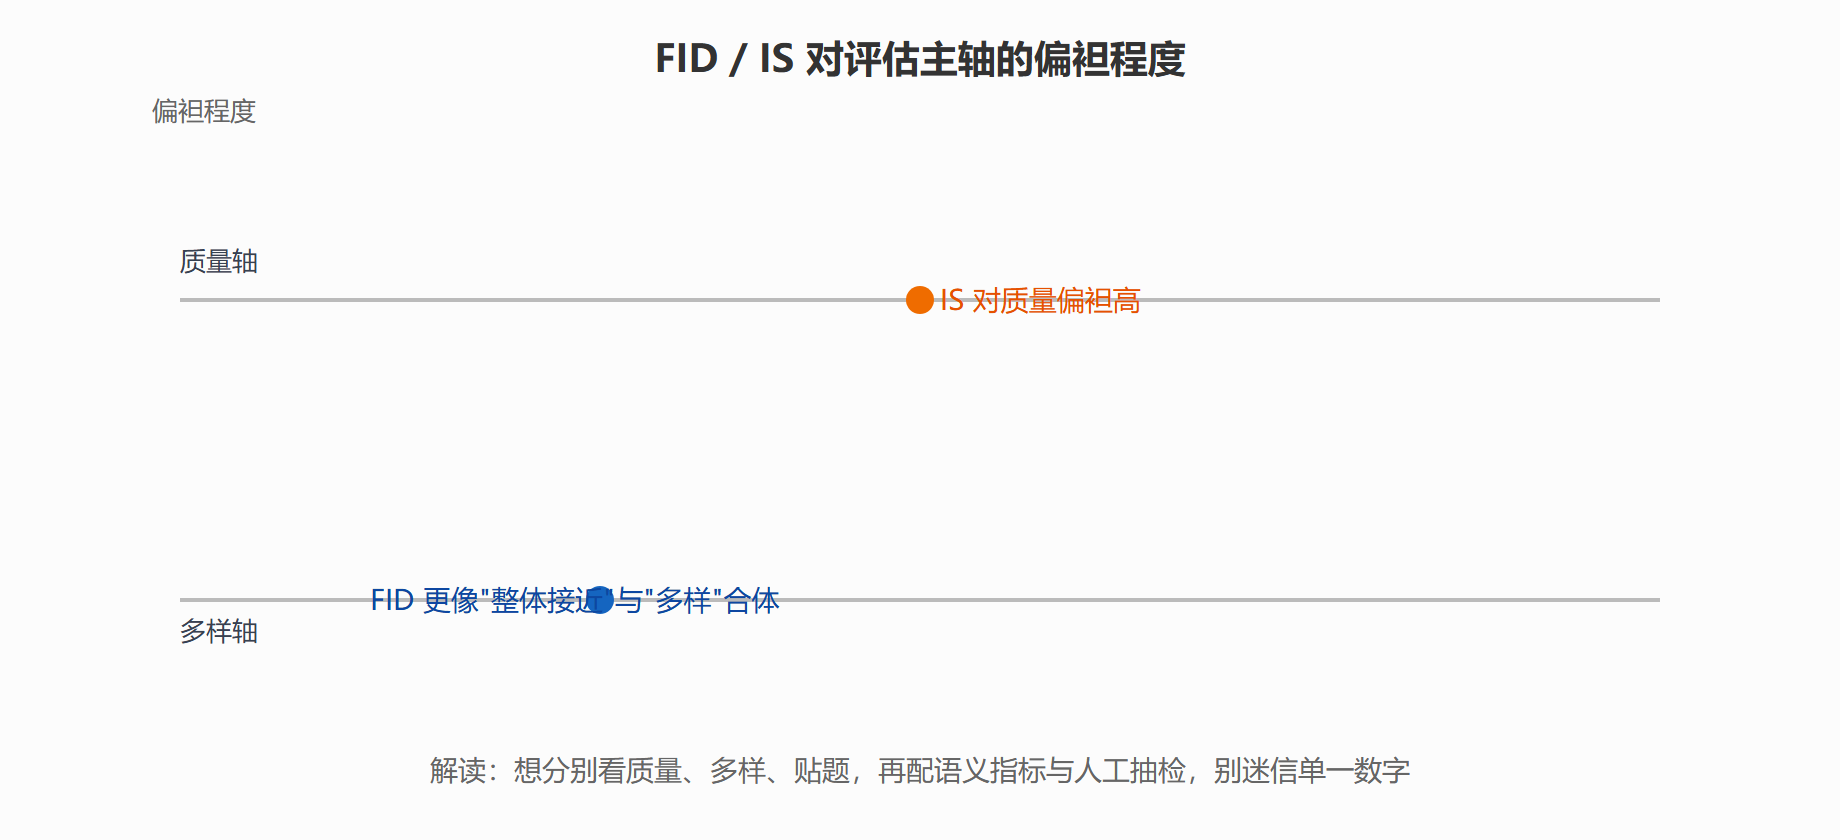
图标题:FID 与 IS 对评估主轴的不同偏袒
上图以两点标出:IS 更偏袒"质量轴"的置信度、却可能对"多样轴"视而不见;FID 更像"整体接近"的合体尺。读懂两点,你就知道拿到报告该先问"这个数字想保护什么"。
反误用清单
面对任何"FID 降了就是好"的结论,先让自己冷静,逐条过这份清单:
- 单张失败被平均掩盖,先看看坏样本占比。
- 指标本身对"分错类却高置信"无感,先想到 IS 的提升可能是错得自信。
- 分布距离不感知"是否合题目",贴题评估要另配语义指标。
- 小样本上指标噪声大,别拿一次运行的数字下定论。
⚠️ 常见坑:只看 FID 一个数就宣布模型赢——它压根不管题材对不对题;质量之外必须再配多样与忠实度两轴。
💡 关键直觉:评估是"三根轴三步量"——FID/IS 量整体像不像,另有指标量多不多样,两者之间那句"贴不贴题"得交给语义指标。
解码:到底该信哪个
给实践一条路径:先问你要的结论是哪方面的。只要判断"这一批生成图和真实图整体像不像",FID 够用;要同时看到"又自信又分散"的粗略体感,可以联读 IS;要高保真、可复现、避免被个案与错误置信带偏,一定在 FID/IS 之外再配一个"贴题/忠实"指标(下一节)与至少一个人工抽检。三种一起用,才能对"这批生成到底如何"下负责任的结论。
拿到报告后的一套读法
指标数字到手,不等于你读懂了它。这里给一套不必写代码也能上手的"读报四问",专门用来戳破被平均掩盖的问题:
先问**"这是哪批样本的数字"——是全部、还是挑过的好样本?很多 benchmark 会顺手把明显失败的图滤掉再报指标,这样的数字高得再漂亮也没有参考意义。再问"样本量多大"——几百张和几万张算出来的 FID,噪声水平差两个量级,小样本上 0.3 的波动根本不值得惊动,先看数量再谈变化。接着问"除整体数外有没有看坏样本画像"——FID 是分布距离,脚不踩到具体某张上,你必须在旁边开一张"失败样本抽查表",把最差的一批翻出来看看到底崩在哪。最后问"有没有与上一版本同口径对比"**——模型迭代成什么,永远要拿同一批参考集、同一个特征提取器来比,换了参考分布等于换了尺子,之前的"进步"随时可能只是把尺换短了。
这一套四问,把"啊 FID 降了"的白喜悦,改造成"降在哪、稳不稳、是不是真在我要的方向上降"的实判断。真正专业的评估报告,往往是这一串追问逼出来的。
指标的三个常见陷阱再敲一锤
关于 FID/IS,最后有三条被反复验证过、值得记一辈子的教训。第一,它们是"相对"的不是"绝对"的:FID 的绝对值随所用特征提取器与参考集而变,脱离参照谈"FID=12 算好吗"没有意义,它只适合"两个方案横着比"。第二,多样性可能骗过 FID:分布只相差"形状"的高斯协方差差异,FID 是敏感的,但若你的失败是"整批都在同一个错误模式里重复",FID 可能看不出这种"又窄又偏"的塌陷,因为它只量到整体距离、量不到对称性。第三,质量与多样的耦合是 IS 的先天缺陷:它把一个乘积值当作终点,可同一个 IS 分可以来自"质量很高但只出几个类"也能来自"质量平庸但铺得很开"——单看分数你永远分不清是哪一种。这三条合起来指向同一个动作:永远不要只报一个数,至少要报"总体 + 分轴(质量/多样/忠实)+ 抽检"三个层次,才算对得起读者。
本节要点回顾
- 质量与多样并立:单张好看与整批不重是两件事,别揉成一个数字。
- FID:分布距离越近越好,强在整体像不像、弱在个案失败无感。
- IS:质量×多样打包,会奖励"自信的错误"。
- 反误用:别被单一数字拍板,坏样本、分错自信、小题材都要防。
- 三轴兼顾:整体像、多样性、贴题,缺一不可才敢下判断。
质量与多样看过了,下一节补最后一根轴:这些生成到底贴不贴题、该拿什么数据验——语义一致性与数据集地图。