7.2 语义一致性评估与常用数据集
7.2 语义一致性评估与常用数据集
生成图"贴不贴题"由语义一致性指标承担,典型有 CLIP Score 与人工偏好评分;评估又依赖数据集。本节讲忠实度指标怎么做、盲区在哪,再给出 LAION、COCO、ImageNet、FFHQ 等数据集的性格与用途。
把图像生成的质量比作完成度,多样性比作风,那么"贴不贴题"就是这台编辑器到底有没有读懂题。上一节的质量与多样,句句都绕不开一个缺口:它们都不管"题目本身"。本节补上第三根轴——语义一致性——再回答"用什么数据来验证":数据集。搞清楚这两件事,你在面对"模型声称听从文字却跑偏"时,就不再只会拍桌子吐槽"它不懂我",而是能把它翻译成一个可量化的分数来状告。
语义一致性:图到底跟没说
衡量"图是不是照着描述画的",两个最常用的抓手是 CLIP Score 与人工偏好。
CLIP Score 的思路很优雅:CLIP 是一种跨模态模型,把文本和图像编码进一个共享空间,让它能给"文本<->图像"的匹配度打分。于是生成图与其提示词之间的 CLIP 相似度,就成了"贴题度"的直接度量——分高说明图上确实承载了题目要的语义。它的弱点也明显:CLIP 是在海量弱监督图文对上训练的,"语义"颗粒度有限,遇到"需要空间排列、数量精确、光照微妙"的题,它的打分常常偏乐观或偏迟钝。
人工偏好(human preference) 则是"让真人给哪张更贴合/更好看投票",用于做终结仲裁。它最忠实地反映"人觉得好不好",却贵、慢、还容易带着人的主观差异。所以现实产品里常把它当成"最后一道关",或把"让模型去模仿人类偏好的排序"做成带标签的代理模型(reward model),省人工成本、又保留人类品味。
一致性评估的常见陷阱
贴题评估有个典型的谎言:数值不低,但"是碰巧谈得上,还是真在懂?"——CLIP 很容易因为"图里有只鸟 + 文字写鸟"就给高分,尽管细节(鸟的数量、姿势)完全不符。另一个陷阱是"题目太弱":一个像"美丽的风景"这样模糊的题,怎么做对怎么做错都说得过去,指标自然失去区分度。所以设计一致性用例时,要把题目写得"有足够多必须实现的关键点可核查",再去看分数是不是真的随实现程度上升。
写一句直给的人话:一致性指标是让你把"它不懂我"变成"它这道题多少分"的工具,但它也只能量到它训练时见过的语义颗粒,别让一个分数替你背上"完全理解文本"那种超出能力的信任。
数据集地图:验证也要有合格的公园
评估(尤其训练少数的目标)离不开数据。不同的生成任务对应的数据集性格完全不同:
- ImageNet:大而自然,含干种分类,适合"无条件/类条件"生成的质量与多样基线。
- COCO:自然图+描述语的图文对,是"文本到图像"与检测最常用的语义配对场。
- LAION:从互联网采集的海量图文对,规模大、噪声也大,训新一代视觉模型的主力。
- FFHQ:高质量对齐人脸集,专供人脸生成、编辑、身份一致性评估。
把地图摊开:
真实场景:用一个例子串起来
假设你要比较两个文生图模型"谁更会按给你的描述画"。现在你能拿出一套完整方案:第一步用 CLIP Score 看这两家输出与同一批题目的贴题分数;第二步看 FID 估计它们各自的整体分布接近真实图的程度;第三步人工抽选一组"难度题型"做人工偏好投票。三根轴各有各的适用,别指望一个数字包打天下——这也是本节很想强调的:稳定、可辩护的结论,都是三根轴+适当抽检一起给的。
指标背后的两个现实
看任何评测报告前,最好先给两个现实打上预防针。第一,指标是统计量,不是个体真理:FID、CLIP Score 分数衡量的是"一批图"整体,单个样本翻车并不罕见,好分数也不承诺每一张都对。所以接受报告时,别把"平均分高"解读成"张张都好"。第二,基线一定要对齐:同一指标在不同数据集、不同分辨率、不同提示词写放下,得分区间完全不同。跳过基线、"裸比较两个数字"通常是评测报告里最容易被钻空子的地方。拿高分的模型,也常是被选中了它最擅长的题目——这又是另一层"题目偏科"。
画一张"三轴评估"的接线图,把每根轴各量什么标清楚:
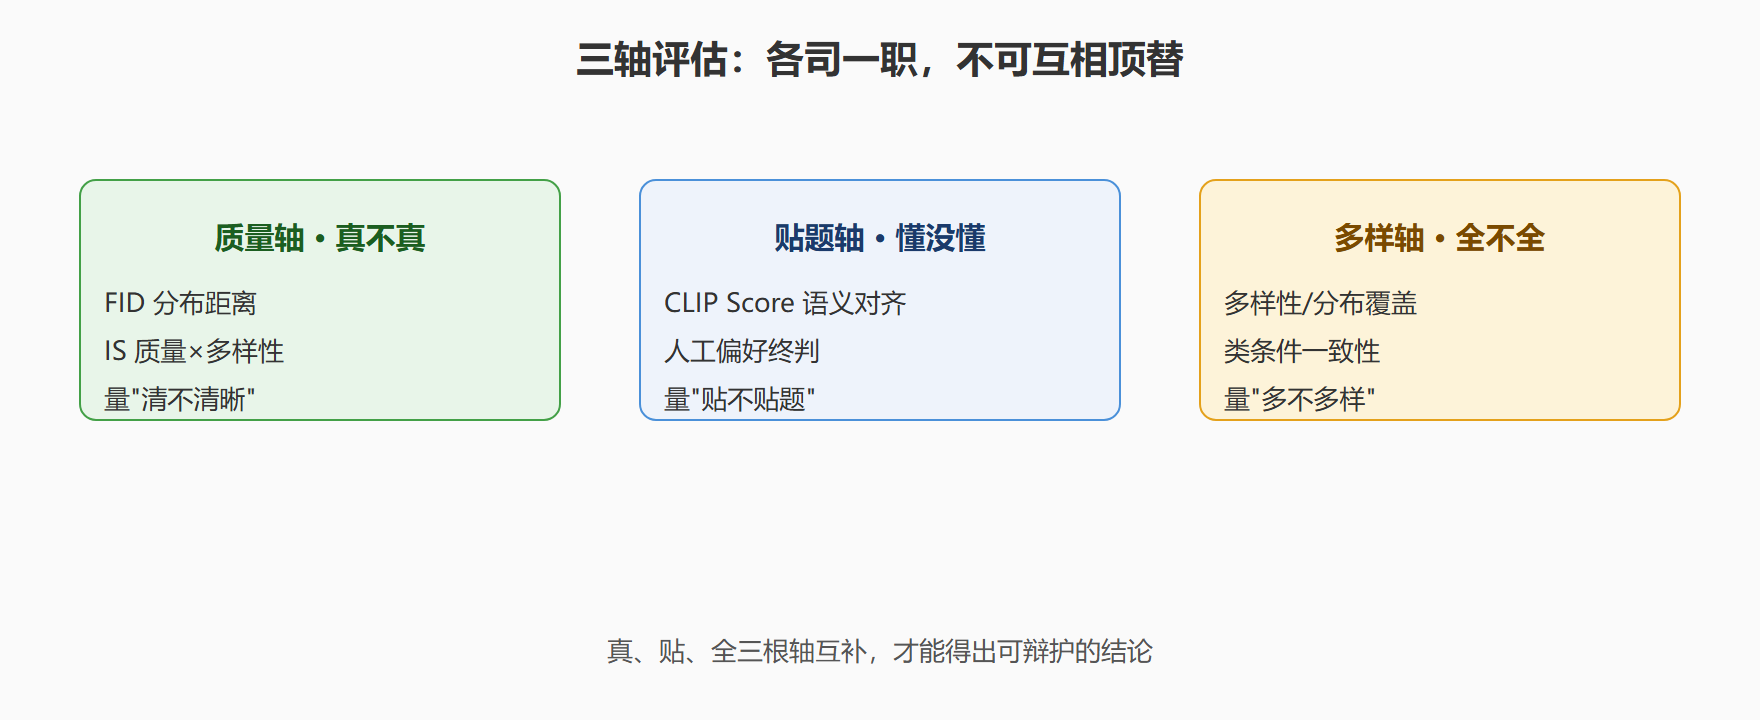
图 7-2:三轴评估接线
这张图提醒一个最容易犯的错:拿贴题轴(CLIP Score)去论证单张图的真假,或用多样轴去硬撑质量结论,都会张冠李戴。每一根轴都有自己"管得到"的那一面,组合在一起,才算一份不露馅的评测。
数据集使用的三个常见姿势
最后补三点数据集使用的经验。其一,规模不等于代表:LAION 虽海量,却存在很强的 web 分布偏差,人脸很少、真实街景偏少,换领域要用对应专用集兜底。其二,一定要留出不参与训练的验证子集:拿训练时见过的图片去测 FID,等于是"开卷考试",分数虚高,结论不可信。其三,评估别只看当日分数:模型与数据集都在演进,跨时间的分数对比要在同一套题目、同一基线、同一清洗规则下做。记下这三点,你在"选哪套数据来验证"上就不容易被人带偏。
⚠️ 常见坑:只拿 CLIP Score 高分就说"模型听懂了",结果可能只是"碰巧沾词"的高频词面;
💡 关键直觉:一致性指标量的是"它的训练语义里跟你的题目碰上的程度"——设计可核对的难题,再让分数跟实现程度同步升降。
本节要点回顾
- CLIP Score:跨模态匹配度,量贴题程度,缺陷在语义颗粒有限。
- 人工偏好:真人投票最忠实,但贵慢,可化作奖励模型省成本。
- 反误用:题目要设计到"关键点可核查",否则分数缺区分度。
- 数据集分工:ImageNet 类条件、COCO 图文、LAION 图文对、FFHQ 人脸。
- 三轴并测:贴题 + 类似 + 偏好抽检,结论才可辩护。
各家模型都能量产"好/坏"了,接下来该坦然地看代价——挑战、伦理与边界,第八章。