8.1 计算效率与实时部署
8.1 计算效率与实时部署
扩散模型训练与推理都吃算力、采样慢,部署到边缘或实时场景难上加难。本条给出四类降本路径——量化、蒸馏、分布式加速、边缘裁剪——并按"云端/交互/移动端"给出一张部署侧重量表。
扩散模型把质量带上去了,也把账单带上去了:一次高清采样要跑几百上千步,推理动不动占用几 GB 显存。这在云端大卡上算不上致命,可真要到手机 App、实时直播、批处理流水线里,就成了硬约束。这一节把"怎么让它跑得快更便宜"这摊事拆开,给你四条已经实战验证的降本路径与一张部署侧重量表。读完你会明白,"省成本"不是等科幻,而是今天就能干的工程活。
路径一:量化,把权重压薄
量化是把模型权重从高精度(如 fp16)压到低精度(int8、int4),每次运算更省、显存占用更低。它是四条路径里门槛最低、见效最快的,尤其适合只需要降低内存与单步推理时延的部署点。代价是压得太狠会引入数值误差、伪影加重,且有些层(注意力)对低精度特别敏感,需要按层选择压到多少位。
路径二:蒸馏,把步骤抄短
蒸馏用一个"老师扩散"教出一个"学生模型",学生学着少步甚至一步复现老师几十步的结论。它能显著缩短采样步数,直接回写"单图生成延迟"。难点在于,每要压新的场景往往要重新蒸馏一轮,且学生会损失一部分老师的高频细节能力。它是"交互实时出图"阵营的主力路线,与第三章一致性模型互为表里。
路径三:分布式,让众人抬轿
当单卡装不下、单张卡跑不动时,把模型切到多卡或多机并行推理。分布式加速的思路是各卡分头负责一部分计算或一批样本,适合批量任务(一次出几百张图)。瓶颈常在通信开销,且要写对并行切分逻辑,学习的曲线高。它赚的是"吞吐量",不直接降单张延迟。
路径四:边缘裁剪,只带能带的出门
边缘部署(手机、摄像头)则以"裁剪 + 量化 + 蒸馏"的组合拳为纲,把一个完整大模型瘦身到能在端侧芯片里跑的形态。裁剪去掉对输出贡献最小的参数,量化压精度,蒸馏省步数,三者叠加能把模型体积从 GB 级压到几十 MB 级。没有哪单独一招够,必须因地制宜叠加。
把四条路放在一张台面上比:
| 路径 | 主攻 | 代价 | 最佳位置 |
|---|---|---|---|
| 量化 | 内存与单步算力 | 数值误差 | 边缘、吞吐型 |
| 蒸馏 | 采样步数 | 高频细节损失 | 实时交互 |
| 分布式 | 吞吐量 | 通信开销 | 批量任务 |
| 边缘裁剪 | 模型体积 | 参数删减风险 | 端侧设备 |
给一个部署侧重量表
落到实际决策,一套可参考的分流:云端高质打样,用多步采样 + 大模型,不求快;实时预览与编辑,用蒸馏 + 适当步数,把单图延迟压到秒级;移动端 App,用量化 + 裁剪的轻量版,接受画面在细节上的妥协。这中间没有免费的午餐——每一步降本都对应某一端的取舍,关键是先想清楚哪个"端"最不能妥协,再倒推路径。
这里再补一个被低估的动作:上线前先跑一次"端到端预演"。不要在部署当天才知道某条路径在你真实负载下的表现,而是先用脚本把"批量打样 / 实时交互 / 端侧推理"各压一批真实请求,把显存、单步时延、吞吐、能耗这几张表都现场记下来,再决定哪些优化值得上、上多少。这一步能帮你把上面所有"理论取舍"变成"手上数据",避免白烧一遍功夫。
def pick_deployment(budget, latency_budget, edge): if edge: return "量化 + 裁剪" # 体积优先 if latency_budget < 1.0 and not budget.sensitive: return "蒸馏 + 少步采样" # 交互求快 return "分布式批量 + 多步采样" # 云端吞吐
别忘了先量后算:三项成本台账
聊降本前,先把"账目"建清楚更值钱。一类工程人常犯的错,是只测单张出图延迟,不看别的。真正完整的成本台账至少有三本账:显存/内存账面,决定这台机器跑不跑得动;单步时延,决定交互体感;总吞吐(每小时出多少张),决定规模经济的账单。同一套优化,可能在这三本账里利弊相反——量化省内存但可能拖慢极低精度下的某些算子,蒸馏省步数但单张模型反而更大。所以动手优化前,先写下"这次到底优化哪本账、以哪本账作硬约束",避免优化了个寂寞。
在"体积/延迟/吞吐"三本账之外,越来越多人开始把能耗与碳排当作第四本账。一批高清采样的耗电,对移动端用户是续航焦虑,对云端是无形的电费与碳足迹。它和上面的决定又常常耦合:量化既省内存又省能耗但损质量,蒸馏省步数等于省电转但可能让模型体积回升。想把这本账也算清,你就得记住一个原则——"省算力"和"省电量"大体同向,但具体到每条路径的红利并不一致,量化主要赚体积与能耗,蒸馏主要赚单图电耗,分布式则大概率让你总电耗不降反升(因为通信与重复计算被摊了进来)。所以真要认真算"更便宜",第四本账也值得顺手记一笔,别让"我只关心延迟"蒙住了全局。
画一张"路径→硬约束→取舍"的对应图,把决策逻辑钉住:
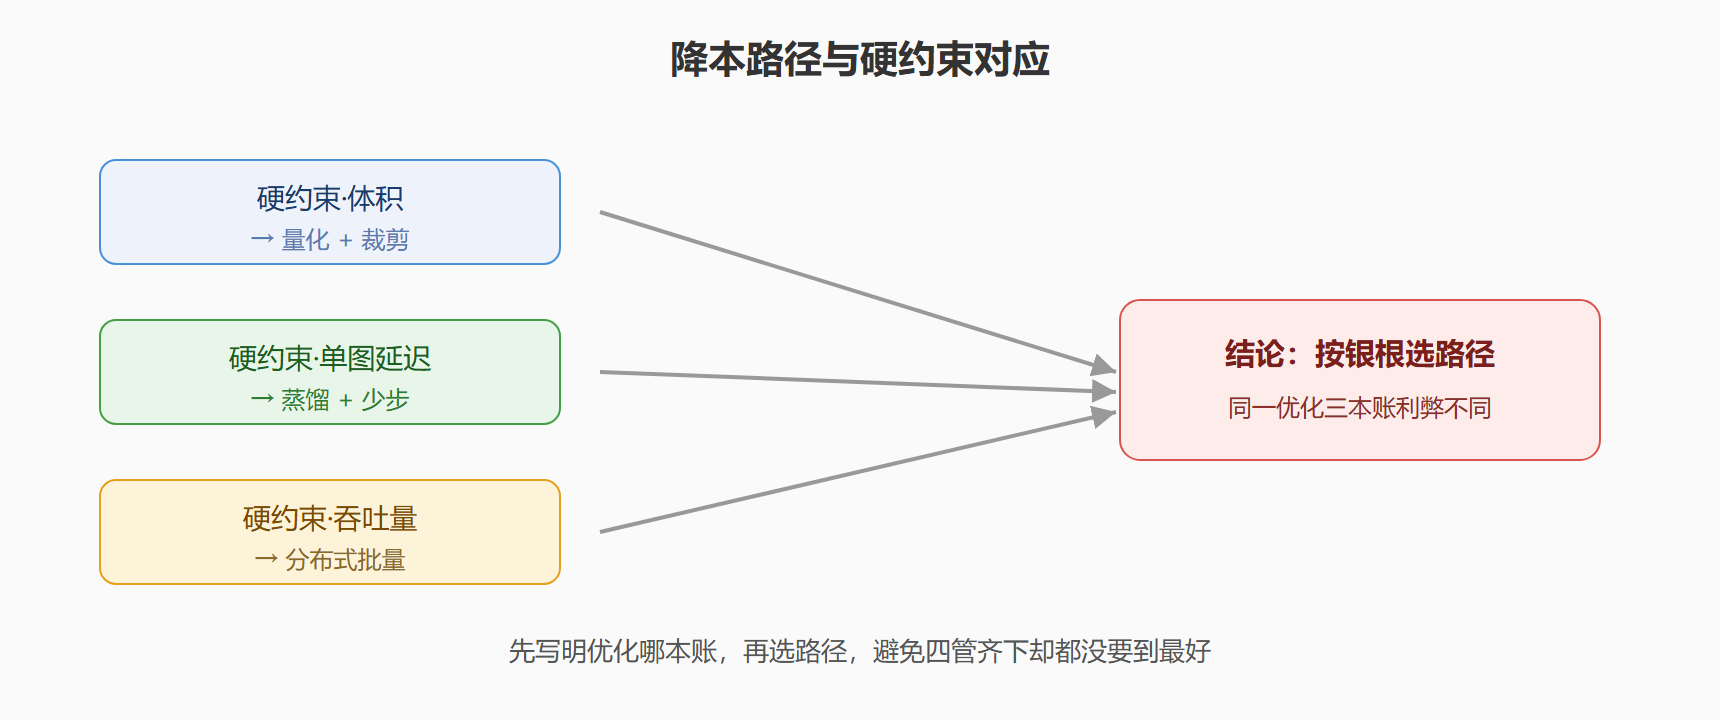
图 8-1:降本路径与硬约束对应
这张图把四条路径凑成一套决策卡片:你想优化的那本账,直接指向主打的那条路。反过来也能提醒你——当多个指标同时要时,没有一条路能同时满分,取舍是必然的。
篇末的一杯冷水
收尾泼一杯冷水:没有免费的午餐,也没有一键的魔法。量化、蒸馏、分布式、裁剪,每一条都好用,但每一条都要求你先具备"量化、会评估、能接受取舍"的基本功。真正高水平的部署,往往是这几条路径轮着实验、反复调比例才磨出来的。所以别把这一节当成"一个命令解决方案",而是当成"一个决策框架"——什么时候该心疼显存、什么时候该省延迟、什么时候该追吞吐,你已经有了打开的钥匙。
⚠️ 常见坑:把"省成本"误当成"不损质量"。四条路径都有代价,脱离"哪端不能妥协"谈降本,等于没有约束的优化。
💡 关键直觉:降本是工程约束,不是玄学——先定好哪个指标(体积/延迟/吞吐)是硬线,再选路径,别让所有指标同时都要。
本节要点回顾
- 量化:压权重精度,省钱快见效,但别压过头。
- 蒸馏:少步复现,交互实时,但要按场景重新蒸馏。
- 分布式:多卡抬轿赚吞吐,不直接降单张延迟。
- 边缘裁剪:量化+裁剪+蒸馏打包瘦身,移动端轻量。
- 决策逻辑:先定"哪端最不能妥协",再倒推路径,别四管齐下贪全。
成本这块账算清楚了,下一节谈更难算的账:伦理与社会影响——版权、偏见、深度伪造,怎么让"能造图"变得"放心造图"。