8.2 伦理与社会影响
8.2 伦理与社会影响
生成式AI把"能造图"变成人人可用,也把版权、偏见、深度伪造三颗雷一起端上桌。本节分别拆解谁的利益受损、为什么难解,并给出技术层与治理层的缓解抓手。
能一键画出以假乱真的脸、能一分钟再造一遍某人的形象——这样的能力,自由是真的自由,风险也是真的。这一节不谈模型内部,而是把镜头对准它落地后啄开的三个社会问题:版权归谁、偏见从哪来、深度伪造怎么防。理解它们,不是劝你别用,而是让你在用的时候知道"红线在哪、缓和的手段有哪些",避免成为无意中踩雷或传播伤害的人。
版权:谁该为"AI 画的画"负责
生成模型的训练数据大量来自互联网采集的图像,其中不少归属明确版权。于是问题层层叠叠:模型"学"了某插画师作品的分布,输出了神似而不完全相同的图,这算不算侵权?用某艺术家的名字当提示词去"仿风格",又该怎么定性?答案是暂无统一判规,各国仍在定细则。工程上我们能做的有一件起效的:可溯源与许可——尽量用有明确授权的训练数据,让"模型用过谁的、在什么授权下用的"透明可查。这也是很多负责任的公司转向"合规数据"路线的动因。
判断层面,版权问题最容易被一句话带偏("AI 作品没有作者,所以没人有版权")。实际上各法域大多承认"有人参与创作"的部分可以获得某种权益,只是"谁的参与、到什么程度"众说纷纭。别把这个当成一道非黑即白的选择题,它是一道在不断磋商中的灰色题。
偏见:模型的"世界观"从数据里带进来
训练数据本身带着社会偏见,模型会把这些偏见"学习"成默认假设:比如某个职业的配图往往偏性感化或种族化。这不是模型"邪恶",而是数据分布的忠实投影。缓解的抓手有内外两层:内层是数据筛选与配平(在训练时尽量平衡各群组的样本与标签),外层是输出侧的护栏与人工审核(对高风险类别拦截、敏感职业做额外校验)。要认清的是,内层配平做得越多,往往越以牺牲部分多样性/通真度为代价,这是一个有真实权衡的工程选择,而非可有可无的好人政策。
深度伪造:造像越强,真相越稀
深度伪造让"替真人说谎"变得廉价:换脸、伪视频、制造不存在的"现场"。风险集中在个人被冒充、公信力被稀释与核实成本飙升。技术侧缓解包括水印与溯源(在生成内容里埋可检测标记)、检测模型(识别换脸痕迹);治理侧则依赖平台标注、立法与教育。但现实比这复杂——检测永远追不上生成,水印可被去除,而将来普通人很难分辨一张图的真伪。这要求我们把"谨慎核实"作为一种社会共识来补位,而不只寄望于工具。
把这三颗雷与应对放一张表更清楚:
| 议题 | 受损方 | 难解的根 | 技术抓手 | 治理抓手 |
|---|---|---|---|---|
| 版权 | 原作者 | 训练数据授权不清 | 合规数据、可溯源 | 立法、授权协议 |
| 偏见 | 被固化标签群体 | 数据分布 + 历史成见 | 配平、输出护栏 | 审计、审核规范 |
| 深度伪造 | 被冒充个人 | 生成强于检测 | 水印、检测模型 | 标注、立法、科普 |
从行业自律到产品层面落地
你未必是立法者,但你是产品设计者和使用者。所以"伦理"也不是光靠立法和行业讨论,它最终要落脚到你写的每一行需求和每一个默认开关。一个负责任的工程实践至少包含这几条可落地的动作:
一是用合规、透明的数据源,保留授权记录——别再随便爬一堆互联网上无授权的图就训模型,数据合规是第一道红线,也是最容易卡住项目的红线;
二是对高危任务加强前端拦截及复审——人脸、真实公众人物、敏感品项,这几类一旦生成不当内容,风险会成倍放大,多一道复审好过出事之后救火;
三是在自己发布的生成内容里明确来源标记——明确说明哪些是生成的,哪些是真实的,降低被二次滥用的可能;
四是你自己作为使用者,遇到"可能造假"的信息,转发前多一道核实——普通人随手转也会成为扩散不实信息的一环,多一分谨慎就少一分风险。
每一条都不复杂,却都是让这套能力活在底线之上的真实动作。伦理不是把自己摘干净说"这都是技术的问题",而是你在做每一步选择时,都把它当成一道可做取舍的选择题。
值得再说透一点的是,治理的目标从来不是"把生成能力关上",而是"给真伪留出竞价空间"。当造图变得人人可用,"某张图片是否可信"就不再是该不该存在某种技术的问题,而成为一个需要信号来回答的问题:来源标签、创作者信息、检测痕迹、平台的明示等等,都是在给"真/伪判断"供料。一个更聪明的取向,不是禁止换脸,而是让"这是换脸"这件事本身可被发现、可被询问。这就解释了为什么优秀的落地方案往往给用户连续三个选项——"允许生成 / 强制标注 / 高风险拒绝",把拍板权交给使用场景,而不是一刀切。理解这层逻辑,你在设计功能时就不会再把伦理当成一张"禁用清单",而是当成一套"信任的基础设施"来搭。
关于"伦理"的一句清醒话
最后给一句清醒话:技术上没有"绝对安全"的生成模型,所有伦理护栏都是"把风险降到可接受",而不是"让风险彻底消失"。缓解不代表消除,但每一个小缓解叠加起来,就能让整个行业走得更远。别因为还不完美就躺平,也别因为技术进步就觉得伦理是碍事的枷锁——它是保护使用者,也保护你自己。
画一张"技术-治理-个人"三层发力的示意图,把缓解的抓手归拢到三层:
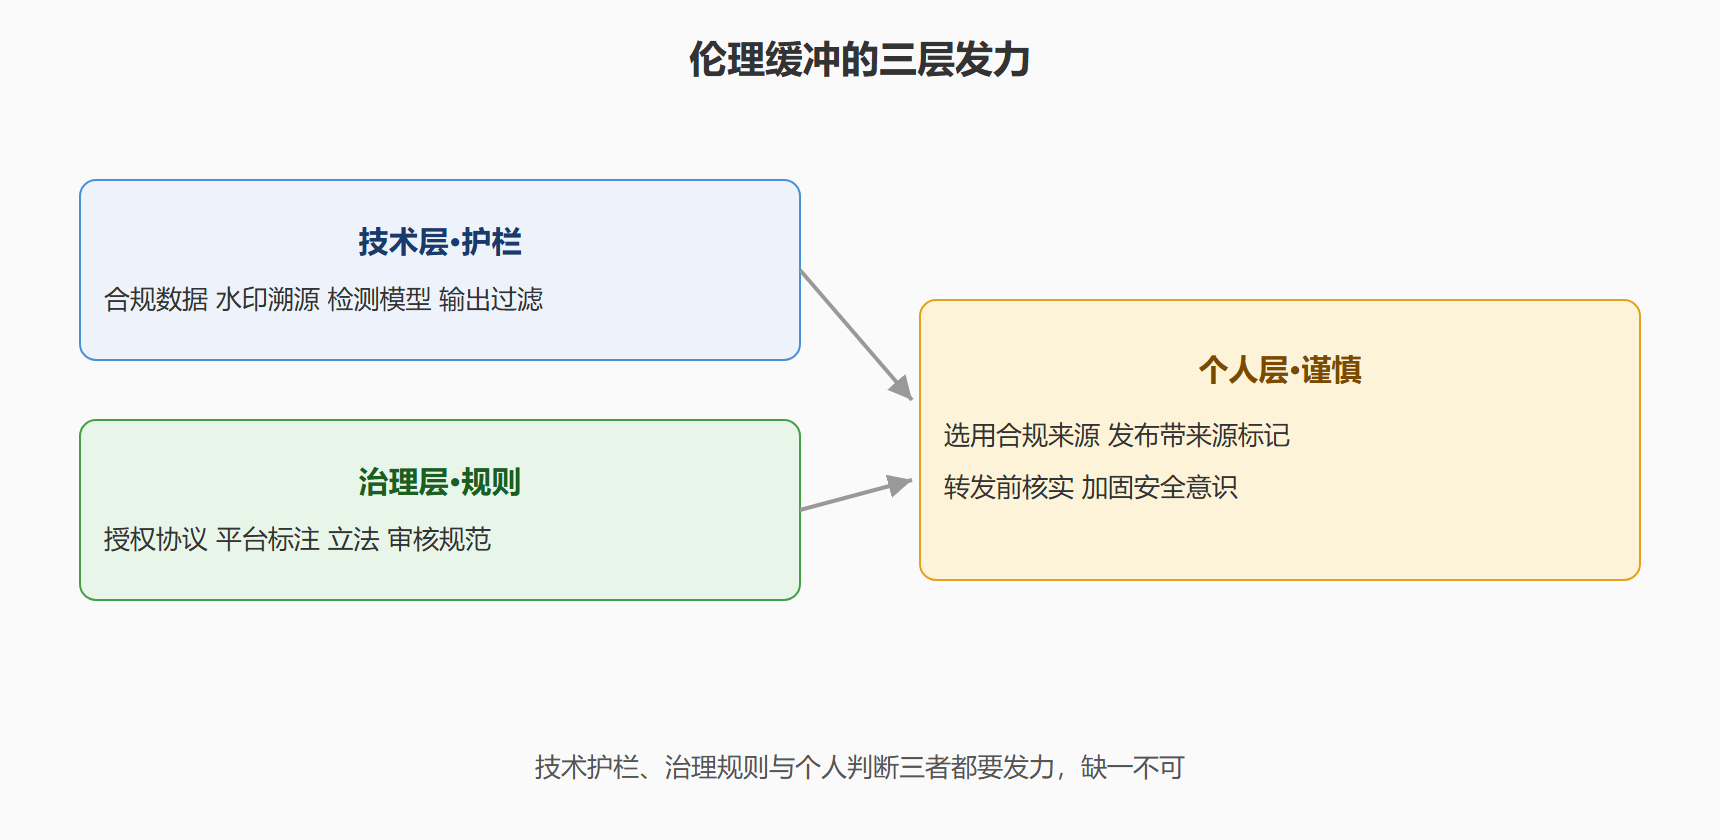
图 8-2:伦理缓冲的三层发力
这张图把上一张表里的"技术抓手 / 治理抓手"再补上"个人层",凑成完整的三层。应对版权、偏见、深度伪造,只靠某一层都兜不住——技术和治理给支撑,个人谨慎才让上限落地。
⚠️ 常见坑:把"AI 没有作者,所以不用管版权"当成结论。实际是"谁参与创作就有谁的权益"在不同法域仍是流程中的灰色题,别轻率下死结论。
💡 关键直觉:版权、偏见、深伪的共性在于——它们是"数据+能力"对社会的外溢,缓解多数要"技术(护) + 治理(规) + 人的谨慎(识)"三层同时发力,缺一不可。
本节要点回顾
- 版权:训练数据授权与输出归属是灰色题,靠合规数据+可溯源缓和。
- 偏见:数据偏见会被模型学成默认假设,配平与输出护栏是抓手。
- 深度伪造:生成强于检测,靠水印、检测与人的谨慎三方补位。
- 工程落地:合规数据、高危前端拦截、内容标记、转发多核实。
- 三层发力:技术护栏 + 治理规则 + 个人判断,缺一不可。
负责任的产图被放上必须的护栏后,我们再往前看模型的硬边界——鲁棒性、泛化、与未来多模态视频的路怎么走。