1.1 一管样本到一份 FASTQ:测序流程全景
1.1 一管样本到一份 FASTQ:测序流程全景
本节摘要:本节是全册问题的起点:测序仪吐出的数据从哪里来。我们跟着肿瘤样本走过提取、片段化、接头连接、上机、碱基识别的完整链路,弄清每一步物理操作会在最终数据里留下什么痕迹。读完你应当能对照一份 FASTQ 反推出文库的构建方式。
从一管样本说起
分析人员拿到的永远不是样本,而是数据;但数据的每一个特征,都是上游实验动作的投影。读长为什么是 150 个碱基?因为建库时超声打断的目标片段在 350 bp 左右。为什么有十几条读长的序列一模一样?因为 PCR 扩增把同一种分子复制了很多份。为什么部分读长开头十几处碱基质量偏低?因为簇生成阶段的信号还不稳定。把"数据特征→实验原因"这条映射背下来,你看数据的目光会从"一堆字符串"变成"一份实验记录"。
人类基因组单倍体约有 30 亿对碱基。一次常规全基因组测序要产出约 100 GB 的碱基数据,才能把基因组覆盖 30 层。这么大的通量靠的是高度并行:Illumina 测序仪的流动池上有数以亿计的纳米级孔洞,每个孔里克隆扩增出同一种 DNA 片段的许多拷贝,仪器对每个孔同时读序——不是一条一条读,而是几亿条一起读。
图:从样本到 FASTQ 的测序流程全景
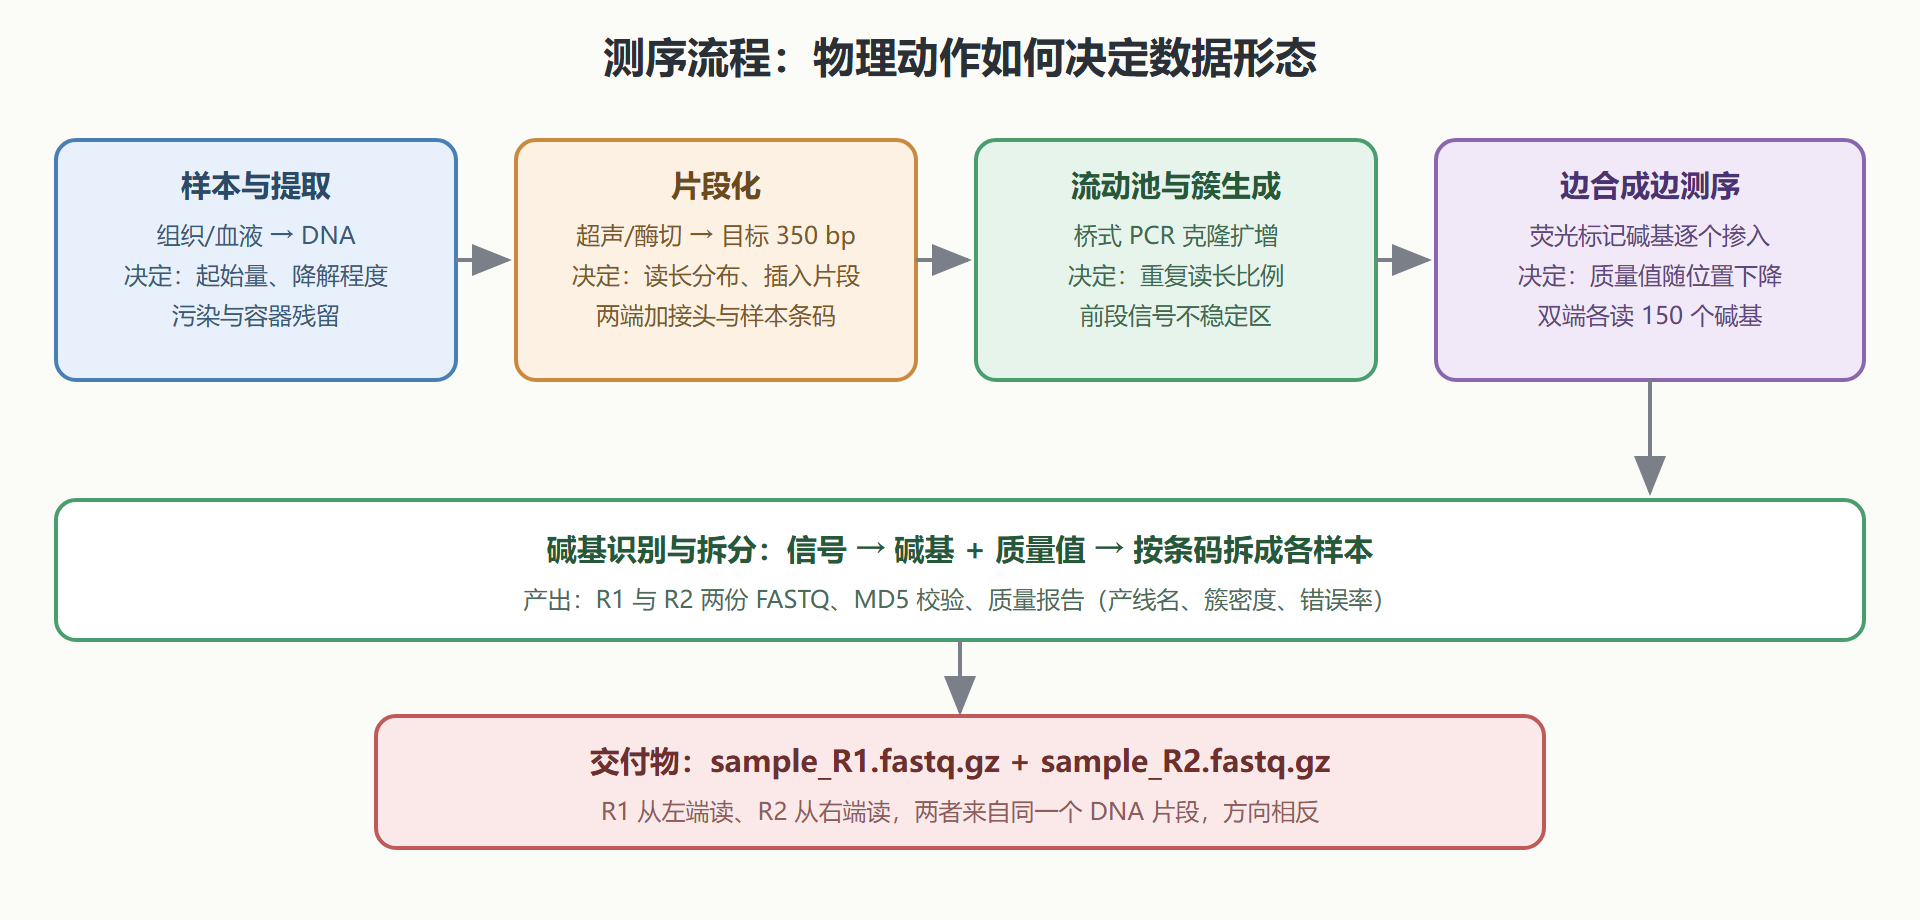
样本到文库:物理过程决定数据形态
文库构建的步子可以归成四步。提取:从组织里把 DNA 或 RNA 拿出来,RNA 还要反转录成 cDNA 才能测序,所以转录组数据测到的其实是 mRNA 的拷贝。片段化:用超声或酶切把长链 DNA 打断,通过磁珠筛选留下目标长度的片段——这个长度是人为选的,常规选 350 bp 左右,因为它既足够短以便簇生成,又足够长以覆盖大部分酶切位点。接头连接:在片段两端接上人工合成的接头序列,接头里有三个关键元件:与流动池表面寡核苷酸互补的区域(让片段能"锚"在流动池上)、样本条码(多个样本混在通道里测,靠条码拆开)、以及测序引物的结合位点。富集:PCR 扩增把文库放大到仪器需要的量。
每一步都在给数据"盖章"。片段化的长度分布变成了读长两端的坐标间距(双端测序里 R1 与 R2 起点之间的距离);条码序列会出现在索引文件或读长尾部;PCR 的偏好性会让某些区域的覆盖度系统性偏高。分析时看到的许多"怪数据",怪的不是数据,是实验。
流动池里发生了什么
Illumina 的流动池是一块玻璃芯片,表面密布接头探针。单链文库片段漂过表面,随机锚定到探针上,然后以它为模板做桥式扩增——片段两端弯下来与邻近探针结合,反复循环后在原位形成一簇约一千个相同拷贝。读序时,四种荧光标记的可逆终止碱基随流动相加入,每掺入处激光激发一次、拍照一次;几亿个簇同时被拍,每轮照片里每个簇的颜色对应它掺入的碱基。循环重复 150 次,就得到 150 个碱基的读长。双端测序是读完一端后把链反转再读另一端,两端各 150 bp,合起来跨过整条 350 bp 的插入片段。
Nanopore 走的是完全不同的路线:一条 DNA 链穿过膜上的纳米孔,不同碱基组合对孔内电流的阻塞模式不同,仪器实时记录电流并解码成序列。它不需要扩增、读长可以横跨上万个碱基,代价是单碱基错误率高于短读长平台。两家的取舍会在 1.3 节展开。
信号变碱基:你拿到的文件是怎么生成的
仪器拍到的荧光图先经过碱基识别(base calling)软件转成碱基与质量值,再按条码把混合样本拆开(demultiplex),最后压缩成 FASTQ 交付。这个过程里你可以在服务器上核对几件事:文件是否成对(R1 与 R2 行数一致)、MD5 是否匹配交付单、读长数是否达到合同约定的产量。
# 下机核对:确认双端文件行数一致、读长长度、文件完整性 zcat sample_R1.fastq.gz | head -8 # 看前两条读长的完整记录 zcat sample_R1.fastq.gz | wc -l # 行数除以 4 即读长条数 zcat sample_R1.fastq.gz | awk 'NR%4==2{print length($0)}' | sort | uniq -c | head # 输出示例:2950423 个 150(绝大多数读长满 150bp,少量偏短属正常切割) md5sum sample_R1.fastq.gz # 与交付单上的校验值比对
wc 的输出除以 4 就是读长条数——FASTQ 每四行记录一条读长,这是它最基本的结构特征,1.2 节会逐行拆解。如果 R1 与 R2 的行数对不上,文件大概率在传输中被截断,先找测序公司补传再谈分析。
下机异常速查:从数据症状回查实验
拿到交付后,有几类高频异常值得对着排查表过一遍。症状与根因的对应关系,就是本节"投影"论的具体化:
| 数据症状 | 最可能的根因 | 处理方向 |
|---|---|---|
| 比对率远低于预期 | 样本污染、参考版本拿错、条码串扰 | 查 GC 双峰、核对版本号、重拆条码 |
| 重复读长比例畸高 | 上机浓度过高或文库复杂度不足 | 标记重复后评估有效深度 |
| 大量读长带同一短序列 | 引物二聚体或接头残留 | 剪切,严重的退回重建库 |
| 双端行数不一致 | 传输截断或文件损坏 | MD5 校验后补传 |
| 碱基里 N 比例偏高 | 信号弱、簇密度异常 | 评估整体 Q30,差则重测 |
排查表的价值不在于背下来,而在于建立"先查数据、再回问实验"的工作习惯。分析人员与实验员的对话质量,往往取决于你能不能用数据语言准确描述症状——"前段质量曲线整体下移"比"数据好像不太好"有效得多。
双端数据的配对关系:后面章节会反复用到
双端测序的 R1 与 R2 不只是两份独立文件,它们之间的三重关系是后续分析的常用杠杆。坐标关系:两条读长的起点在基因组上相距约一个插入片段长度(350 bp 上下),比对后工具用这个先验校正落点——比对间距异常是 2.5 节结构变异检测的核心证据。命名关系:R1 与 R2 的记录按行序一一对应,第 i 条对第 i 条,因此任何过滤操作必须双端同步,否则对应关系全乱——这是新手用脚本处理 FASTQ 时最常见的事故。方向关系:R1 沿正向读、R2 沿反向读(对同一片段而言),做拼接或重叠分析时要把方向转正。
理解了这层关系,也就明白了为什么剪切工具要成对输入输出、为什么比对工具要一个命令同时吃两个文件。数据结构上的一点严谨,换来的是下游无数工具的顺畅运转。
本节要点回顾
- 数据是实验的投影:读长分布、重复比例、前段质量,都能追溯到建库与上机的具体动作;
- 文库三要素:接头锚定、样本条码、引物位点——分别决定了片段能否被测、样本如何拆分、从哪里开始读;
- 双端测序:R1 与 R2 来自同一个片段的两端,中间隔着已知的插入片段长度,这层关系在 2.3 节比对时会派上大用场;
- 下机核对动作:行数配对、读长长度分布、MD5 校验,是接手任何数据的第一步。
下一节把 FASTQ 文件逐行拆开,看看质量值那一串奇怪字符到底在说什么。