1.2 FASTQ 四行结构与 Phred 质量值
1.2 FASTQ 四行结构与 Phred 质量值
本节摘要:FASTQ 是测序数据的标准容器:四行一条记录,碱基行与质量行逐字符对应。本节拆解每行的含义,讲透 Phred 质量值的对数本质——Q20 等于 99% 的碱基正确率——并用脚本统计一份真实文件的长度分布与质量分布。
先看一条真实的记录
一份 FASTQ 打开来是这样四行:
@A00689:123:HTLKWDSX3:1:2101:1000:1000 1:N:0:ATCACG GATCGGAAGAGCACACGTCTGAACTCCAGTCACTGACCATGATCTCGTATGCCGTCTTCTGCTTG + FFFFFFFF:FFFFFF,F:FFFFF:FFFFFFFFFFFFFFFFFF,F:FFFFFFFFFFFFFFFFFFF:F
四行的分工必须像背口诀一样清楚。行首 @ 加读长标识符:仪器编号、流动池编号、通道(lane)、坐标(tile、x、y),这套坐标能唯一定位一个簇,排查批次问题时非常有用;冒号后的 1:N:0:ATCACG 表示这是双端里的第一条、未通过过滤标记、控制位为零、样本条码是 ATCACG。第二行是碱基本体,只含 A、C、G、T 和 N(识别不出的碱基)。第三行以 + 开头,通常重复标识符,也可以只写一个加号。第四行是质量行,每个字符对应第二行同位置的一个碱基。
质量行的字符看着杂乱,是因为它把数字编码成了可见字符:把 Phred 分数加上 33,再取对应的 ASCII 字符。字符 F 的 ASCII 码是 70,减去 33 得到 37,即 Q37。
Phred 值:用对数刻度表达出错概率
Phred 质量值的定义是 Q = -10 × log10(P),其中 P 是这个碱基判错的概率。对数刻度的好处是能用小范围的数字覆盖极大的概率跨度:Q10 对应 90% 正确率(十次错一次),Q20 对应 99%(百次错一次),Q30 对应 99.9%(千次错一次),Q40 对应 99.99%(万次错一次)。每提高 10 分,错误率降一个数量级。
| 质量值 | 正确概率 | 每千碱基预期错误 |
|---|---|---|
| Q10 | 90% | 约 100 处 |
| Q20 | 99% | 约 10 处 |
| Q30 | 99.9% | 约 1 处 |
| Q40 | 99.99% | 约 0.1 处 |
行业里默认的及格线是 Q30:一条 150 bp 的读长若全部碱基达到 Q30,整条读长至少 86% 的概率完全无误。这就是为什么测序报告总把"Q30 比例"当核心指标——人类全基因组测序通常要求 85% 以上的碱基达到 Q30。变异检测对质量更敏感,低质量碱基混进来会直接变成假阳性位点。
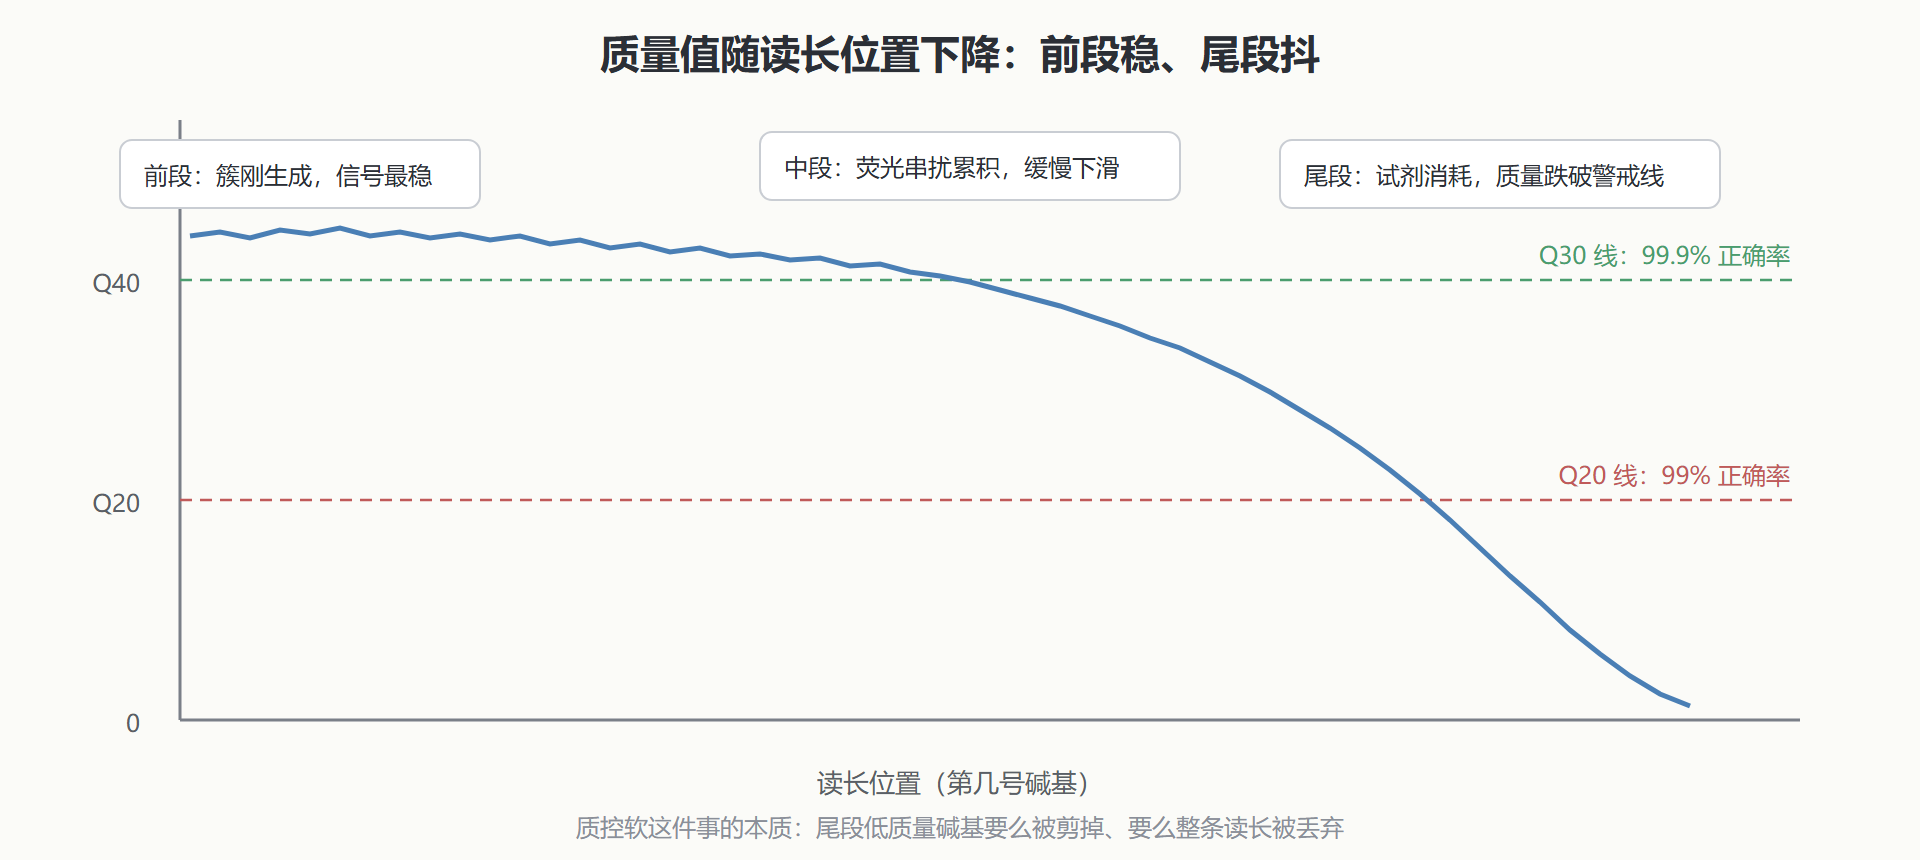
图:一条读长的质量分布与 Phred 标尺
质量曲线为什么长这样
典型 Illumina 数据的质量分布有个固定形状:前几个位置质量很高但略有波动(簇生成刚结束时信号尚不稳定),中段缓慢下滑(荧光串扰与相位漂移逐轮累积),尾段加速下跌(试剂耗尽、信号衰减)。这个形状解释了两件事:其一,为什么质控总是盯着尾部——那里的碱基最不可靠;其二,为什么读长是平台设计出来的参数而不是越长越好——把读长从 150 加到 200,多出来的 50 个碱基大多落在低质量区,得不偿失。
Nanopore 的质量分布不同:整体偏低且均值多在 Q10 到 Q20 之间,但它靠多层一致序列(consensus)把最终精度拉回来。平台的质量模型不同,质控策略就不能照搬,这是 1.3 节平台对照的伏笔。
动手统计一份 FASTQ
光看不练记不住。用一段 Python 把上文的概念全算一遍——碱基长度分布、逐位置平均质量:
import gzip lens, qual_sum, n = {}, [0]*150, 0 with gzip.open("sample_R1.fastq.gz", "rt") as fh: for i, line in enumerate(fh): if i % 4 == 1: # 碱基行 lens[len(line.strip())] = lens.get(len(line.strip()), 0) + 1 elif i % 4 == 3: # 质量行 for j, ch in enumerate(line.strip()): qual_sum[j] += ord(ch) - 33 # ASCII 减 33 还原 Phred 值 n += 1 print("读长长度分布(前5):", sorted(lens.items(), key=lambda x:-x[1])[:5]) print("逐位置平均质量(每30bp取样):", [round(q/n, 1) for q in qual_sum[::30]]) # 预期输出示例: # 读长长度分布(前5): [(150, 2950423), (149, 8211), (148, 3120), ...] # 逐位置平均质量(每30bp取样): [37.2, 36.8, 35.9, 33.4, 28.1] —— 尾段明显下滑
这段脚本就是 FastQC 这类质控工具的核心逻辑。跑一遍你会发现:长度分布通常高度集中在 150;平均质量从 37 一路滑到 28 上下。2.1 节会把这些统计扩展成完整的质控报告并决定怎么过滤。
容易踩的细节
FASTQ 有个历史遗留的格式分叉:老版 Sanger 标准里质量行从 33 起编码(Phred+33),早期 Solexa 标准从 64 起编码(Phred+64)。今天所有主流平台的交付都是 Phred+33,但网上下载的十几年前的旧数据可能还是 +64,直接混用会把 Q20 错算成 Q52 之类荒谬的数值。工具链里加一个格式探测步骤,成本极低,能省掉一天的排查。
另一个细节是质量行的字符不是"分数越高字符越靠字母表后面"那么直观——比如 # 是 Q2,I 是 Q40,~ 是 Q93。读报告时不用背表,记住 F 大约 37、尖括号区域低于 20 就够用。
两个补充细节:N 碱基与识别模型
碱基行里偶尔出现的 N(识别失败)也是信息。N 比例整体偏高说明信号层出了问题(弱簇、流动池气泡、试剂异常),逐位置统计 N 的分布还能定位具体的坏区域——比如某个通道的固定坐标反复出 N,基本可判是流动池局部缺陷。健康的人类全基因组数据 N 比例通常远低于千分之一,转录组数据略高也属正常。
另一个值得知道的底层事实:现代碱基识别已经从手工阈值进化成了深度学习模型——仪器厂商的识别软件用神经网络直接从原始信号(Illumina 的荧光图、Nanopore 的电流序列)解码出碱基与质量值,Nanopore 的碱基准确率近年从 92% 提到 99% 以上,主要就是靠识别模型的迭代重训,硬件几乎没动。这解释了一个现象:同一台老仪器配新版软件,数据质量能"免费"提升——质量值是模型的输出,不是物理常量。
下一节换一个维度:不同平台给出的读长差别有多大,又分别适合什么问题。