2.1 下机先体检:FastQC 质控与读长清洗
2.1 下机先体检:FastQC 质控与读长清洗
本节摘要:垃圾进,垃圾出——比对与定量不会修正坏数据,只会放大它。本节以 FastQC 报告为主线,讲清每个模块在体检什么、哪些报警可以忽略、哪些必须处理,并用 Trim Galike 类工具完成清洗。
为什么体检排在第一位
第 1 章说过,质量与接头这些数据特征是实验动作的投影。质控的目的不是"让数据变好看",而是在投入昂贵的计算之前,先确认数据能支撑你想要回答的问题。同样的报警在两类项目里结论完全相反:转录组项目里 3 端接头残留是常态,剪掉就行;而宏基因组项目里出现大量接头残留,可能意味着上机浓度异常,要回头找实验员核对。
FastQC 的输出是一份 HTML 报告,十来个模块。要记住一个原则:它把每个模块标成 PASS/WARN/FAIL,但这些标记只是经验阈值,不代表对与错。真正要练的是看懂每个模块的图在画什么,再结合项目类型判断。
报告里的重点模块
基础统计模块(Basic Statistics)先看四个数:读长条数是否达到预期产量、读长长度分布、GC 含量比例、总体 Q30 占比。人类全基因组样本 GC 应在 40% 上下,明显偏高要怀疑扩增偏好或污染。
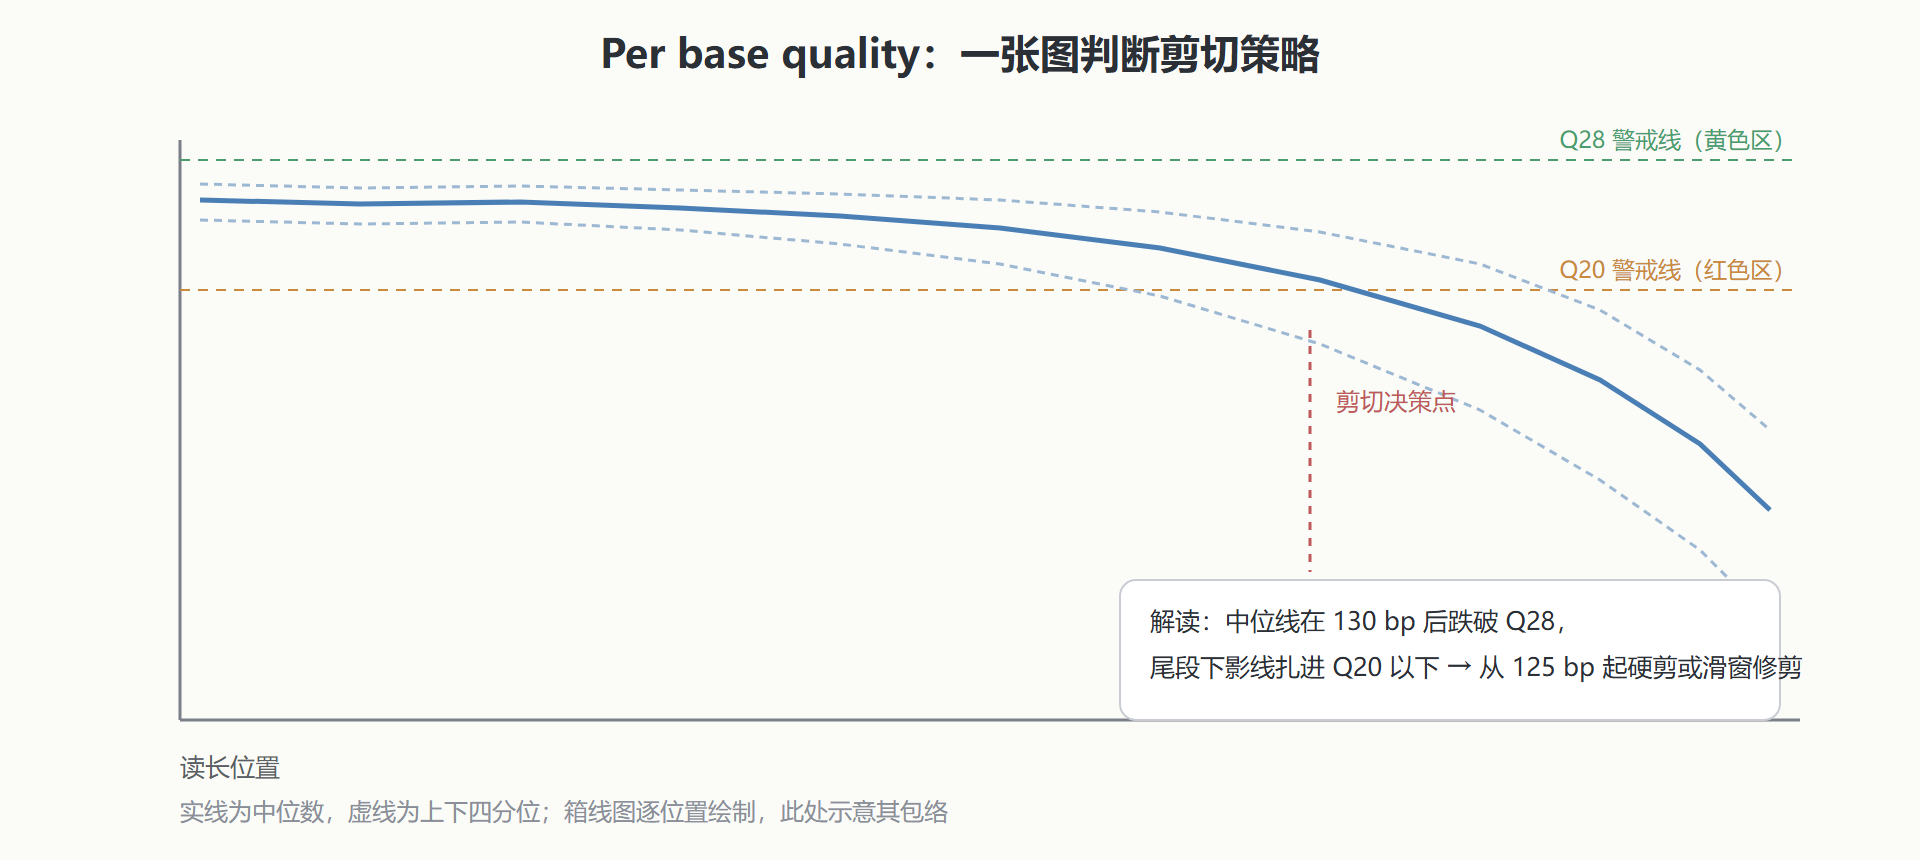
逐碱基质量模块(Per base sequence quality)是 1.2 节那张质量曲线的正式版:箱线图逐位置画出质量分布。中位数跌破 Q20 的区域就是候选剪切区。它是最该看的图,因为它直接决定后面怎么剪。
接头污染模块(Adapter Content)画各位置上接头序列的累积比例。350 bp 插入片段配 150 bp 读长理论上不该读到接头,若曲线在 120 bp 后开始爬升,说明插入片段偏短,必须剪切。overrepresented 序列模块列出异常富集的序列,通常是接头、rRNA 或引物二聚体。
GC 分布模块把观测 GC 含量分布与理论分布叠画。理论曲线是正态状的单峰;出现双峰往往意味着样本混入了另一种生物的 DNA(比如人类样本混了细菌),这是污染排查的重要线索。
图:FastQC 逐碱基质量模块的典型形态
动手跑一次质控
FastQC 接受单文件也接受批量;跑完用 MultiQC 把几十个样本的报告汇总成一张表,批量项目里这是标准动作。
# 单样本质控 fastqc sample_R1.fastq.gz sample_R2.fastq.gz -o qc/ # 批量样本汇总:把所有报告合成一份交互式网页 multiqc qc/ -o multiqc_out/ # 读取报告要点(MultiQC 的 fastqc_data.txt 已含各模块数据) grep -A3 "Total Sequences" qc/sample_R1_fastqc/fastqc_data.txt
对照报告定清洗策略,用 Trim Galore(底层是 cutadapt)执行:
# 自动探测接头;--quality 20 剪尾部 Q20 以下碱基;--length 25 丢弃剪后过短的读长 trim_galore --quality 20 --length 25 --paired \ sample_R1.fastq.gz sample_R2.fastq.gz \ -o trimmed/ # 输出:sample_R1_val_1.fq.gz 与 sample_R2_val_2.fq.gz # 日志会给出两个关键数:剪掉的碱基比例、被丢弃的读长比例
清洗后再跑一遍 FastQC 复查,确认接头曲线归零、质量箱线图整体抬升。两次报告都要留档——发文章时的数据处理部分,审稿人会要这张"清洗前/清洗后"的对照。
哪些报警可以放过
不是所有 FAIL 都要处理。RNA-seq 的逐碱基质量在尾部 FAIL 是常态,剪到中位数 Q20 以上即可;序列重复度偏高在 PCR 深度扩增的甲基化数据里也常见,交给后续去重步骤。反过来,GC 分布双峰、总产量远低于合同约定、read 内容出现未知富集序列,这三类必须停下去查样本与实验记录,清洗救不了它们。
批量项目的质控管理
多样本项目里,逐个翻 FastQC 报告效率太低,MultiQC 的汇总表才是工作界面。汇总视图能把几十个样本的关键指标排成一列,异常样本一眼跳出来:产量明显低于同批的、GC 偏离群体中心的、接头比例独高的。批量的意义还在于"横向对比"本身——单看一个样本的质量分布很难判断是样本问题还是批次问题,同批样本整齐划一地偏,多半是上机批次或建库批次的锅。
| 汇总指标 | 健康区间(人类 WGS/WES 参考) | 越界动作 |
|---|---|---|
| Q30 碱基占比 | 85% 以上 | 低于 80% 与测序方交涉 |
| 比对率 | 全基因组 95%+ / 外显子 70%+ | 查污染与参考版本 |
| 重复读长比例 | 全基因组 15% 以下 | 高则评估有效深度 |
| 接头残留(剪后) | 接近零 | 复查剪切参数 |
| 插入片段中位数 | 外显子 200–300 bp | 偏移大影响覆盖解读 |
质控记录本身就是项目资产。报告与清洗参数随流程仓库归档,半年后审稿人问起"数据如何处理",这份记录连同命令一起回执。第 4 章的 MultiQC 集成与报告自动化,会把这些动作固化进工作流。
清洗参数的取舍逻辑
剪切参数不是越狠越好,每一刀都要有理由。硬剪(固定剪掉尾部若干碱基)简单粗暴,适合整批数据质量曲线形状一致的场景;滑窗修剪(窗口内平均质量低于阈值就从那里剪断)更贴合质量下滑的渐进形态,是多数项目的默认选择。剪后最短长度(如 25 bp)是另一道闸:剪得太短读长的定位能力骤降,MAPQ 不可信,不如整条丢弃——丢弃比例超过百分之几就要在方法学里写明并解释。
参数选择的验证方式是对比:清洗前后的比对率、唯一比对率、目标区间覆盖度各跑一遍。理想状态是清洗后比对质量明显改善而读长损失有限;如果清洗后关键指标不升反降,说明剪过头了(或者问题根本不在质量,清洗救不了)。质控环节的所有判断都该这样闭环——参数改了,指标要给出回应,没有回应的参数改动一律撤销。另外把最终选定的参数与两次报告一起归档,方法学部分的表述就有着落了。
💡 关键直觉:质控报告的作用不是打分,而是回答"这份数据能不能回答我的问题"。带着问题看图,比背模块阈值有用得多。