2.2 参考基因组与三种核心文件格式
2.2 参考基因组与三种核心文件格式
本节摘要:比对是把读长放回坐标系,坐标系就是参考基因组。本节讲清 FASTA、GFF/GTF、索引文件三类格式各管什么,版本号为什么致命,比对前为什么必须先建索引。
坐标系先于位置
"把读长放回基因组"这句话隐含一个前提:得先有一份公认的基因组。参考基因组就是这个坐标系——它是某个物种的代表性个体(或拼接群体)的基因组序列,由国际联盟维护并持续更新。人类参考基因组当前的主流版本是 GRCh38(2003 年后逐步替代 GRCh37/hg19),它不是一个"标准人",而是一个拼接得足够好的模板,上面还留着不少未填实的缺口(用一串 N 表示)。
版本问题是新手最容易翻车的地方。同一个位点在 hg19 与 GRCh38 里坐标不同——两个版本之间有数千万碱基的差异,包括倒位、序列填补与坐标整体偏移。把 hg19 坐标的变异列表直接对到 GRCh38 的注释上,等于拿 A 城的门牌号去 B 城找人。全流程必须锁定同一版本:参考 FASTA、注释 GFF、已知变异库、比对索引,一个都不能混。文章里报告结果也要写明版本号,这是可重复性的底线。
FASTA:序列本身
FASTA 是最朴素的序列格式:第一行以大于号开头,写序列名与描述;之后每行 60 个字母(行宽不强制),写碱基或氨基酸。人类参考基因组是一个 FASTA 文件,里面按染色体各存一条序列:
>1 dna:chromosome chromosome:GRCh38:1:1:248956422:1 REF NNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNN ACCTCAGTC...(约 2.49 亿个字符) >2 dna:chromosome chromosome:GRCh38:2:1:242193529:1 REF ...
别看格式简单,它背后是体积:人类基因组 FASTA 压缩后仍约 900 MB。分析中你会频繁见到它的变体:转录组比对用的参考是全部 mRNA 序列的合集;蛋白质搜索用的参考是氨基酸序列合集。同一个词 FASTA,既指格式也指这类文件的俗称。
GFF/GTF:坐标上的注释
光有序列不够,还得知道基因在哪、外显子边界在哪、哪个链。GFF(General Feature Format)与它的近亲 GTF 用制表符分隔的九列表格回答这件事:
# seqname source feature start end score strand frame attribute 1 ensembl gene 11869 14409 . + . ID=ENSG00000223972;Name=DDX11L1 1 ensembl exon 11869 12227 . + . Parent=ENST00000456328 1 ensembl exon 12613 12721 . + . Parent=ENST00000456328
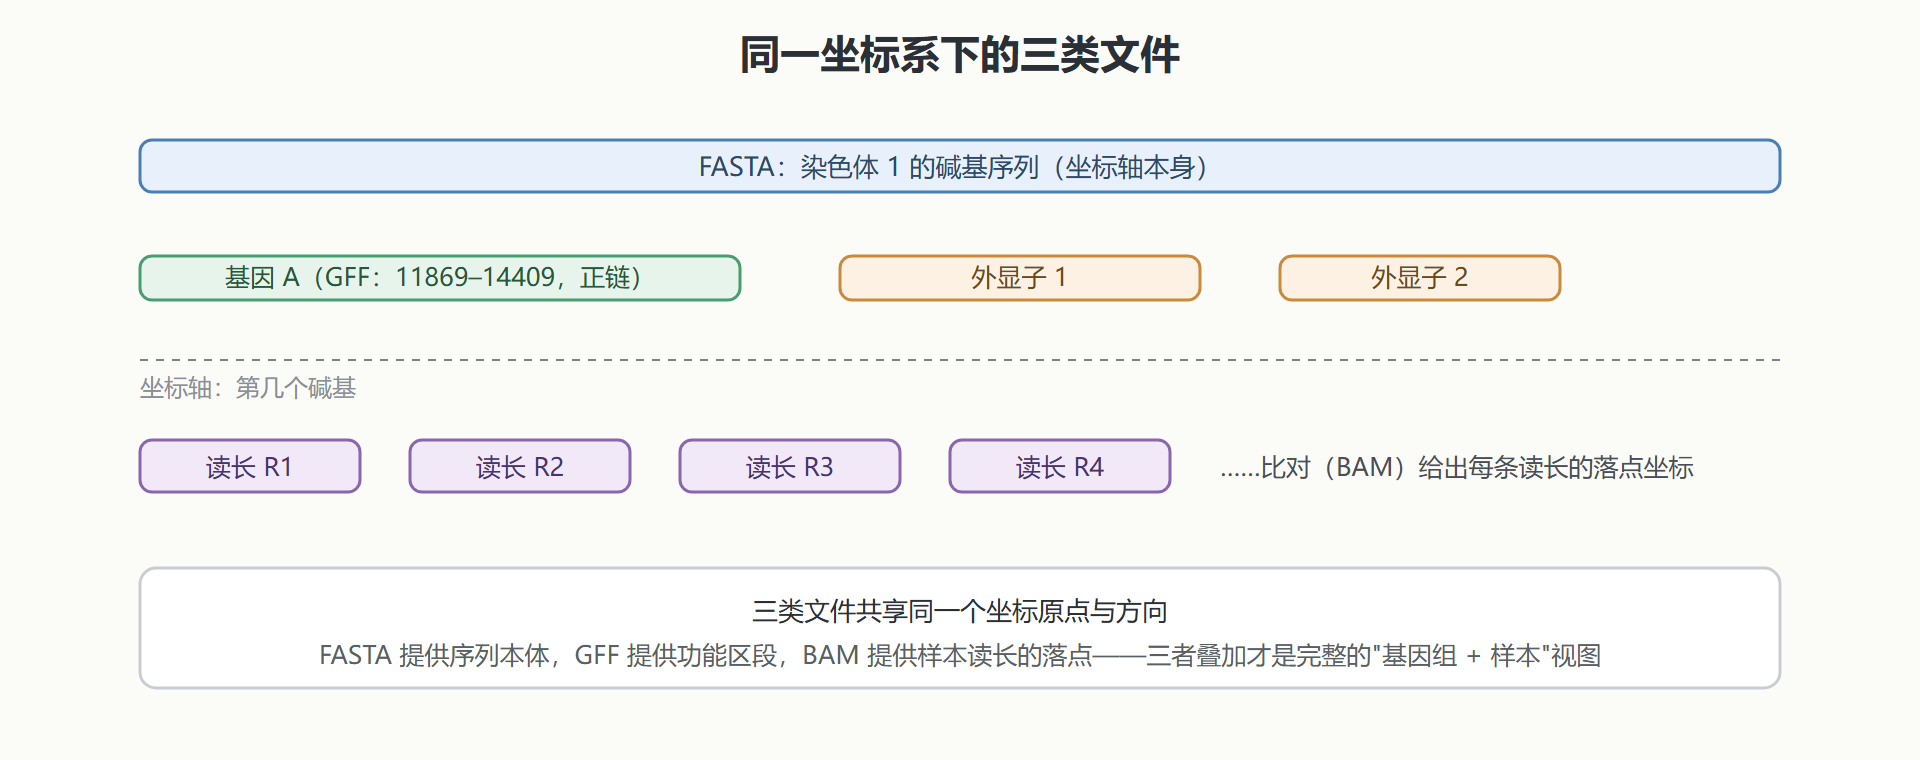
每行是一个"特征":基因、转录本、外显子、CDS……start 与 end 是在这个染色体 FASTA 上的坐标,strand 记录正负链。做差异表达分析时,把读长计数到基因上的那一步(featureCounts 或 HTSeq),用的就是这份文件的外显子坐标。GFF 与 GTF 的区别主要是第九列属性区的写法习惯,工具会各自挑食,用之前先看目标工具的文档要哪种。
图:FASTA 序列、GFF 注释与比对结果的坐标对齐关系
索引:让亿条读长秒级归位
在 30 亿碱基里为一条 150 bp 的读长找位置,朴素做法是把读长与基因组每个位置对一遍——每条读长要 30 亿次比较,一亿条读长就是天文数字。索引解决的就是这个问题。比对前先对参考 FASTA 建索引:工具把参考序列变换成一种可快速查询的结构(BWA 用的是 Burrows-Wheeler 变换加后缀数组思路),记录"什么样的读长片段大概出现在哪里"。查询时先查索引锁定候选位置,再做精细比对。这一步把每条读长的比较次数从十的九次方降到几十次。
# 为人类参考基因组建 BWA 索引(一次性,耗时数十分钟到数小时,产出多个索引文件) bwa index -p grch38.fa samtools faidx grch38.fa # 建立随机访问索引,之后能秒级抽取任意区间序列 # 验证索引可用:抽取 1 号染色体 11869-12227 区间 samtools faidx grch38.fa 1:11869-12227
索引文件建好后不要动参考 FASTA 的存放路径与文件名——大多数工具靠"路径+索引"成对查找,参考文件换了内容而索引没重建,是最阴险的错误来源:比对照常完成,结果全错。
拿到参考数据的三条路
参考数据从公共库下载:NCBI 的 RefSeq 与 Ensembl 是两大主流来源,同一版本号下两者的注释精细度与命名习惯有差异(Ensembl 的基因 ID 以 ENS 开头,RefSeq 以 NM/NR 开头)。第 4 章会专门梳理数据库地图。无论从哪拿,下载时同时取 MD5 校验文件,落地即校验;并把版本号、下载日期写进分析记录。这些看似繁琐的动作,都会在半年后重跑分析时救你一次。
坐标的进制陷阱:0 基与 1 基
参考数据的坐标还有一个隐蔽的进制问题。FASTA、GFF、VCF 用的是 1 基闭合区间(第 1 个碱基记作 1,区间含两端),而 BED 一类区间文件用 0 基半开区间(第 1 个碱基记作 0,终点不含)。同一个"11869 到 12227 的外显子",写成 BED 要变成 11868 与 12227。混用进制会把所有区间整体错位一个碱基——剪接位点、变异注释这种单碱基敏感的场景,错位就出错判。写脚本抽区间序列时,先确认工具文档声明的是哪种进制,再动手。
顺带一提随机访问的工程价值:2.2 节的 faidx 索引让"取第 100 万到 101 万个碱基"成为毫秒级操作,靠的是记下每行序列在文件里的字节偏移。BAM 的索引(.bai、.csi)同理——按参考序列与坐标分箱记录数据位置。理解了"索引即偏移表",你就明白为什么索引文件必须与主文件同生共死、为什么主文件重排后索引必须重建。
下一节就用这套坐标系回答核心问题:BWA 怎么把几千万条 150 bp 的读长放回它们原来的位置。