3.1 中心法则:从基因到蛋白质的信息流
3.1 中心法则:从基因到蛋白质的信息流
本节摘要:蛋白质组学的一切分析都建立在中心法则之上。本节把信息流的三段——复制、转录、翻译——与各组学技术的监测位置对齐,并讲清为什么 mRNA 丰度不能代替蛋白丰度。
把信息流画出来
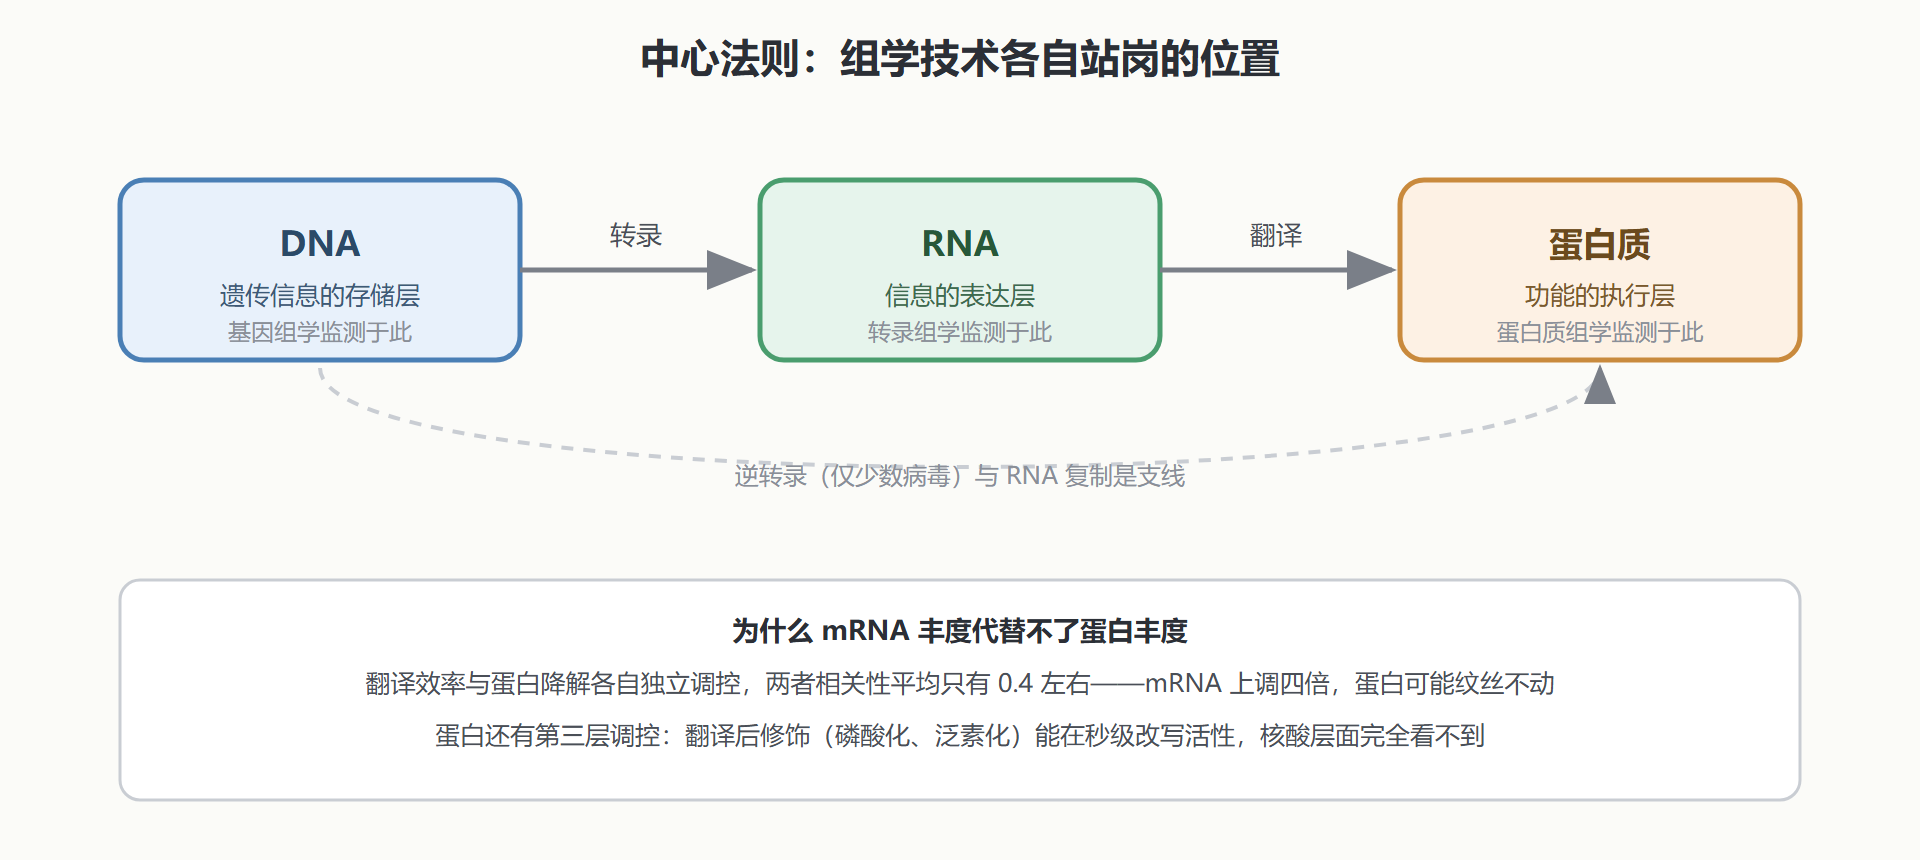
中心法则描述了生物信息的流向:DNA 复制自己;DNA 转录成 RNA;mRNA 在核糖体上被翻译成氨基酸序列;蛋白质折叠成三维结构去执行功能。少数病毒的逆转录酶能把 RNA 抄回 DNA(HIV 就靠这个),RNA 也能自我复制,但主流信息流就是这三段。第 1、2 章的测序技术监测的是 DNA 与 mRNA 层面,本章下到蛋白。
图:中心法则信息流与各组学的监测位置
从序列到机器:蛋白的四级结构
氨基酸序列(一级结构)决定局部螺旋与折叠片(二级结构),再盘绕成整体形状(三级结构),多条链组装成复合体(四级结构)。功能长在结构上:酶的催化口袋由相距很远的残基折叠后凑在一起,蛋白互作的界面是特定表面的拓扑。这条"序列→结构→功能"的因果链,是 3.7 节结构预测合法性的全部依据——只要序列同源,结构与功能就大概率可以迁移。需要补充的边界条件是:结构还依赖环境——pH、离子浓度、伴侣蛋白的辅助都会影响折叠走向,体内环境与体外实验的差异,正是部分"结构正确、功能异常"案例的解释来源。
对蛋白质组学而言,四级结构还有实验含义:复合体(比如蛋白酶体是 28 个亚基的桶状机器)在常规变性流程里会被拆散,测到的是亚基列表而不是机器本身。研究复合体的组成与组装,需要非变性的专门技术(blue native PAGE、AP-MS),常规数据的解读要记得这层信息已经丢失。
蛋白质组为什么比基因组难测
三个数字说明难度。动态范围:血浆里白蛋白的浓度是最稀有蛋白的十个数量级以上,质谱采谱永远先打到丰度高的,低丰度信号(往往是药物靶点、信号分子)被淹没。没有扩增:PCR 能把一份核酸放大十亿倍,蛋白没有等效手段,多少就是多少。没有互补配对:核酸杂交有碱基配对的物理抓手,蛋白识别靠抗体,而抗体的广度与一致性远不及探针合成。这三难决定了蛋白质组的技术路线:鸟枪法打碎、色谱分离、质谱高速采集、计算搜库——下一节展开。
顺带校准一个期望:一次深的哺乳动物细胞蛋白质组实验(TMT 多通道加分级)今天能稳定鉴定八千到一万种蛋白,已经接近全谱;但修饰与互作层面的"完整蛋白质组"仍是进行时。理解当前技术的边界,比记住"鉴定了多少种"更有用。另一个常被问起的问题是"蛋白组与转录组哪个更接近表型"——这个问题没有绝对答案,但对多数药物与疾病的终点(功能改变)而言,蛋白与修饰层确实离得更近:药物作用在蛋白上,代谢流走在酶的活性上,mRNA 只是中间账本。实际项目里两层一起测的成本通常可接受,得到的互补信息远大于任何一层单独加深的收益,这个判断已经被大量疾病研究的双层设计反复验证过。
三段信息流上的调控开关
中心法则不只是单向传送带,每一段都装着调控开关,各组学的"差异"实际上测的是这些开关的合力。转录开关:启动子与增强子的活性、转录因子的结合决定一个基因的出勤率——表观基因组学测的组蛋白修饰与染色质可及性就在监测这一层。加工开关:前体 mRNA 的剪接选择决定一个基因产出哪几种转录本,人类基因有可变剪接的比例超过九成,同一种蛋白家族的成员差异常常出自这里。翻译开关:mRNA 的二级结构、microRNA 的结合、mRNA 的定位都调节它被核糖体使用的效率。降解开关:蛋白的寿命由泛素化与自噬决定,寿命缩短与合成减少在丰度读数上无法区分——这也是蛋白组数据的固有模糊。
把这些开关摆出来,组学数据的解读就有了坐标系。转录组差异反映开关的组合在 mRNA 层面的净值;修饰组(3.5 节)监测翻译开关之后的活性层;而蛋白组总量是所有层输出的合计报表。做跨层比较时(5.5 节的多组学),层与层之间的"不一致"往往不是数据质量问题,而是某一层开关被独立调控的证据——这是系统生物学最感兴趣的那类信号。举例来说,某基因的 mRNA 不变而蛋白丰度上去了,第一嫌疑是蛋白降解速率下降;mRNA 上去而蛋白纹丝不动,第一嫌疑是翻译效率被压制——两类情形指向完全不同的实验跟进路线,这就是把信息流拆成段落来读的实际回报。
一个易被忽视的事实是 RNA 本身也执行功能:核糖体 RNA、转运 RNA、剪接体的小核 RNA、长非编码 RNA,功能 RNA 的种类与数量远超编码 mRNA。常规 RNA-seq 流程测的主要是多聚腺苷酸化的 mRNA,非编码 RNA 的世界需要专门的建库方法——解读"转录组"三个字时,默认它只覆盖了 RNA 世界的一个角落。
用相关性数字校准预期
mRNA 与蛋白丰度相关性约 0.4 这个数字,值得拆开看它对不同工作的含义。做靶点验证的人要明白:转录组筛出的候选有一半以上在蛋白层面看不到变化,验证实验的设计预算要按这个折损率来排。做机制解释的人要看到另一面:凡是 mRNA 与蛋白丰度明显背离的基因,自动成为翻译调控或差异降解的候选——这不是数据的瑕疵,而是埋在数据里的第三层调控线索,5.5 节的多组学整合会专门去挖它。
相关性低还有技术成分:蛋白组的定量动态范围与覆盖率都低于转录组,低丰度蛋白测不全,相关系数被测量误差整体拉低。所以解读层间相关时要把"生物学不一致"与"测量缺失"分开——前者是发现,后者是噪声。两个数字放进口袋:整体相关约 0.4;高丰度、注释完整蛋白的层间相关能到 0.6 上下。用这两个锚点判断你算出来的层间相关是正常还是异常。
本节要点回顾
- 信息流三段:复制守恒、转录表达、翻译执行——基因组、转录组、蛋白质组分别站岗,表观层在上游调节转录开关;
- 序列决定结构、结构承载功能:这是同源功能注释与结构预测共同的合法性来源;
- mRNA 与蛋白丰度相关性仅 0.4 左右:转录组结论需要蛋白验证,层间背离本身是翻译与降解调控的线索;
- 蛋白质组三难:动态范围巨大、无扩增、无配对——它们塑造了鸟枪法的技术路线。
下一节进入质谱仪内部,看肽段怎么被"称重"与"打碎",谱图里藏着哪些序列信息。