3.2 质谱如何认出蛋白质:鸟枪法与两级采谱
3.2 质谱如何认出蛋白质:鸟枪法与两级采谱
本节摘要:质谱不直接"测蛋白",它测的是肽段的质荷比。本节讲清鸟枪法流程——酶解、色谱分离、一级定质荷、二级打碎片——以及为什么鉴定报告里数的是肽段、落账却在蛋白。
鸟枪法:把难题化整为零
完整蛋白太大、修饰太多、不好电离,直接测整分子只有小蛋白做得到。主流策略是鸟枪法(shotgun):先把所有蛋白用胰蛋白酶酶解成肽段(平均每个蛋白被切成几十段),把"认蛋白"化简成"认肽段"。胰蛋白酶的切割规则极其规整——只在赖氨酸 K 与精氨酸 R 的羧基端下刀——于是每种肽段的理论质量可以从序列直接算出来,这正是后续搜库的数学基础。
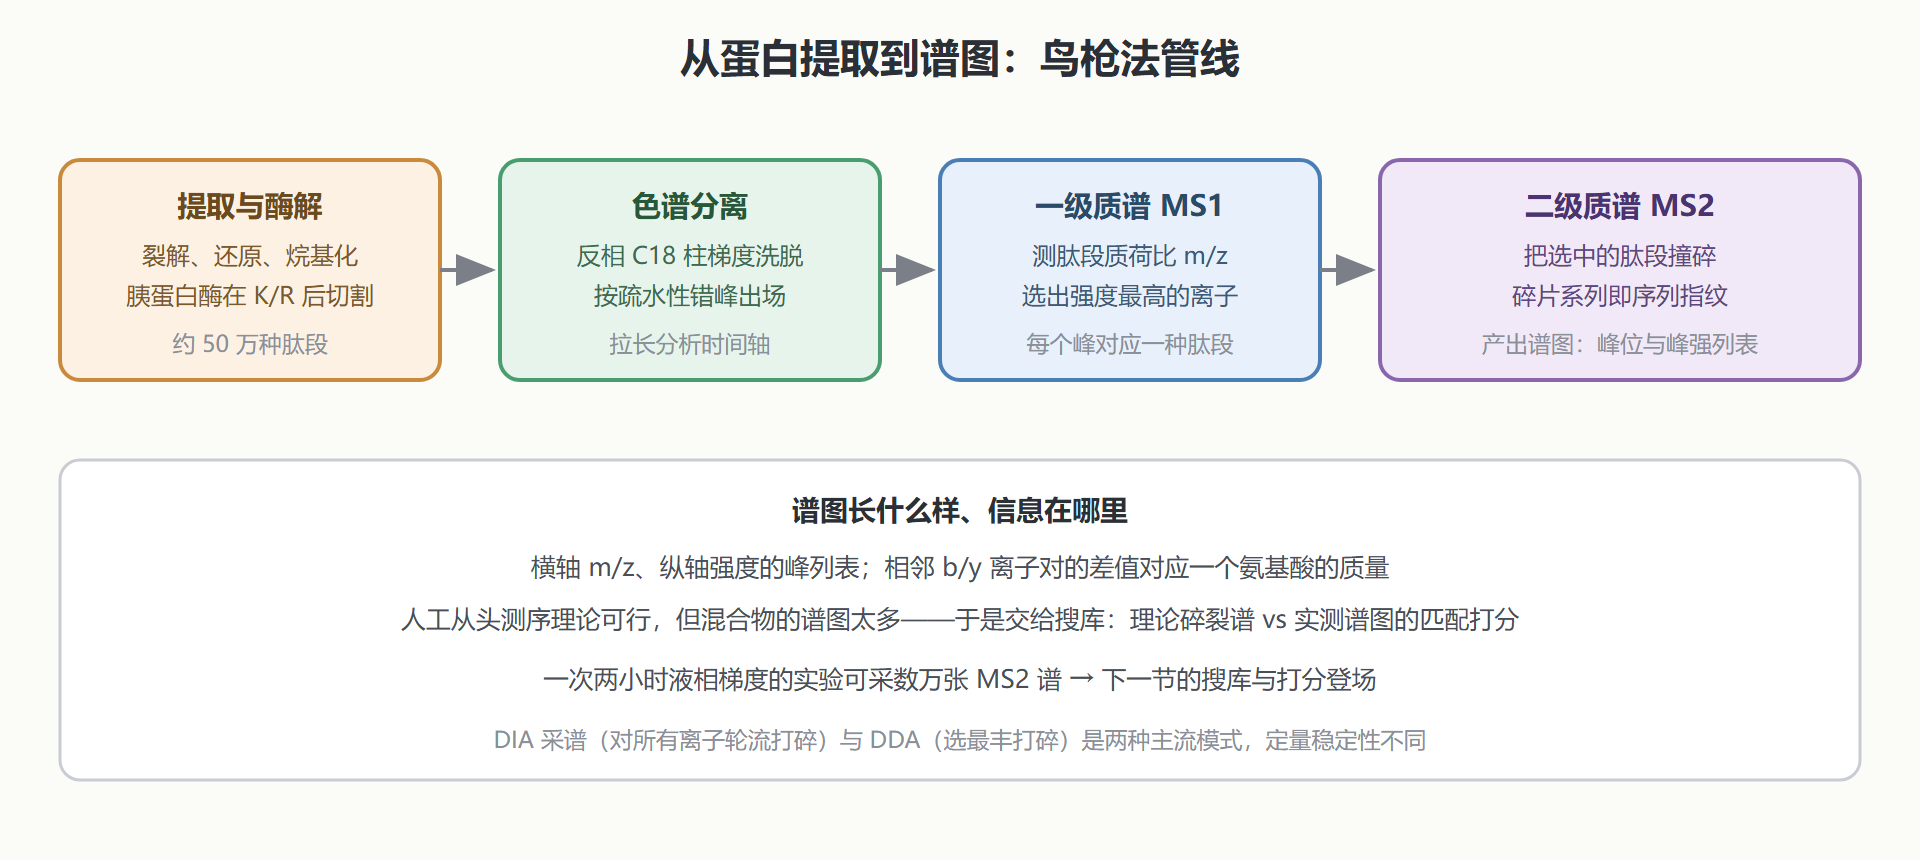
一次典型实验的体量:一个细胞系的蛋白组酶解后产生约五十万种肽段,而质谱每秒只能采几十张谱。把五十万种分子塞进每秒几十条的通道,靠的是色谱分离——肽段按疏水性在反相 C18 柱上洗脱,出峰时间前后错开,混合物在时间维度上被拉成一长串相对简单的脉冲。
图:鸟枪法蛋白质组学的完整管线
两级采谱:先点名,再审问
质谱的采谱循环是两级问答。一级(MS1)快速扫描当前流出的所有离子,记录各自的质荷比与强度——这是"点名册",也是定量的主要数据来源(峰面积正比于丰度)。随后挑出强度最高的若干离子进入二级(MS2):在碰撞池里用惰性气体把它们撞碎,记录碎片离子的质荷比——这是"审问记录",肽段的序列信息藏在里面。
两段式问答有一个固定的节拍:一级扫描快、二级鉴定慢,一次完整循环通常不到一秒,两小时梯度能积累数万张 MS2 谱图。节拍里还藏着一个对定量影响深远的取舍——每轮选哪些峰进入二级,决定了低丰度肽段有没有出场机会:被高丰度峰挤掉轮空的肽段,这轮就没有谱图,形成 DDA 数据缺失值的主要来源。理解了采谱节拍,3.4 节的缺失值问题就有了物理层面的解释,DIA 路线的动机也随之自明。
碎裂有个对分析极其友好的规律:肽段骨架主要在酰胺键处断开,产生 b 离子(保留 N 端)与 y 离子(保留 C 端)两个互补系列。相邻两个 y 离子的质量差恰好对应序列里相邻位置的一个氨基酸。所以一张高质量的 MS2 谱,理论上是"从两端往中间逐残基读出序列"的题目——人工从头测序(de novo sequencing)就是这么做的。但混合物谱图太多、低质量谱里峰不齐,工程上更稳的做法是搜库:把样品来源物种的全部理论肽段碎裂谱算出来,与实测谱图匹配打分,把谱图"认领"回肽段。
从肽段落账回蛋白
搜库认领的是肽段,但生物学结论要以蛋白为单位——这一步叫蛋白推断,里面有个著名的模糊:如果某个肽段的序列同时出现在多个蛋白(同工酶、蛋白家族成员常共享肽段),无法判断这些肽段属于哪一家。处理原则是"俭省":能用最少数量的蛋白解释全部观测肽段,就不多报。同行评审最常问的数字是"unique peptide 数"——每个蛋白被几个独有肽段支持,通常要求至少两条 unique 肽段才算高可信鉴定。单肽段蛋白在报告里会单独列出,审稿人大概率要你解释。这一步的谨慎还有回报:鉴定列表的"颗粒度"直接决定后续定量的可信度——共享肽段的蛋白在定量时无法彼此区分,它们的丰度读数是家族合并值,做差异分析前要把这类合并值挑出来单独处理,否则会把家族级的变化误安到单个成员头上。
鉴定深度的上限也在这里:血浆蛋白组常规能报两三千种蛋白,细胞裂解液深挖能到八九千种;没被报出来的不等于不存在,只是丰度低于当前采谱量的探测线。报告鉴定数时附上肽段总数、谱图利用率与 FDR 设定,是蛋白质组数据的行规。
质量分析器:仪器怎么把离子称出来
谱图的质量取决于质量分析器——质谱仪里真正"称重"的部件。当前蛋白组学的主力是 Orbitrap(静电场轨道阱)与飞行时间(TOF)两类。Orbitrap 让离子在静电场里绕轴旋转,旋转频率与质荷比相关,傅里叶变换把频率谱转成质量谱,分辨率可达十万级——高分辨率意味着能区分质量只差百万分之几的离子,前体质量容差才能压到几个 ppm。TOF 则让离子在无场管里飞行,轻的先到重的后到,速度快、质量范围宽,MALDI 源配合 TOF 的组合常用于肽段指纹图谱与成像。
采集模式的两条路线(DDA 与 DIA)值得单独一表,因为它们决定了后续数据分析的整套工具链:
| 维度 | DDA(数据依赖采集) | DIA(数据独立采集) |
|---|---|---|
| 选碎对象 | 每轮选强度最高的若干峰 | 轮流打碎一段质量窗口内的全部离子 |
| 谱图归属 | 干净,一谱一肽 | 混合,需解卷积 |
| 缺失值 | 多(低丰度易被挤掉) | 少,定量连续性好 |
| 适用场景 | 探索性鉴定、建谱图库 | 大队列定量、临床验证 |
实验设计的三个前置决定
质谱实验的成败有一半在上机前就定了,三个决定最关键。蛋白质组数据库的选择:搜库用的参考要与研究物种匹配——模式生物用现成的参考蛋白组,未测物种要先测转录组拼出翻译组当数据库,数据库里塞满不存在的序列会白白抬升假发现率。酶的选择:胰蛋白酶是默认(切点规整、肽段长度适中、碎片规律好),但单一酶的覆盖总有死角,深入项目常用双酶策略(胰酶加 LysC 或 GluC)拼出互补覆盖。分级与否:样本复杂度太高时,一次液相分离不够用,把肽段按等电点先分成几十个级分、逐级分上机,鉴定深度能上一个台阶——分级换深度,代价是机时成倍增加。
三个决定共同服从一个原则:让仪器的采集能力对准生物学问题的重点。要广度就分级加深、要通量就单次 DIA、要修饰就先富集——问题定策略,策略定参数,顺序不能反。
样本制备同样有分工纪律:裂解缓冲液的选择决定能溶出哪些蛋白(膜蛋白需要去垢剂,核蛋白需要高盐),还原与烷基化打断二硫键让肽链伸直,酶解前的除盐不彻底会抑制离子化。蛋白质组项目里"谱图质量不好"的申诉,追到最后多数落在制备环节——这是一门与分析同等重要的手艺,分析人员至少要能听懂实验同事的术语,才能一起排查问题。仪器侧还有一条日常功课:质量轴校准。用标准品定期校验质量轴的准确性,漂移会让前体质量容差失准、匹配率下滑——实验室的校准记录与运维日志是数据可信度的后台凭证,翻旧数据出问题时先查这些记录。
💡 关键直觉:质谱鉴定的本质是"用理论解释实测"。数据库里没有的蛋白,谱图再漂亮也认不出来——这就是未测物种的蛋白组要先建翻译组数据库的原因。
谱图认领回来了,但认错的可能性有多大?下一节讲搜库打分与假发现率的控制。