4.3 公共数据库地图:NCBI、Ensembl、UniProt 与 PDB
4.3 公共数据库地图:NCBI、Ensembl、UniProt 与 PDB
本节摘要:公共数据库是这个领域的公共基础设施:参考序列、注释、变异、表达、结构与文献全在库里。本节按"找什么去哪"画出地图,并给出批量下载数据的标准姿势。
四大库的分工
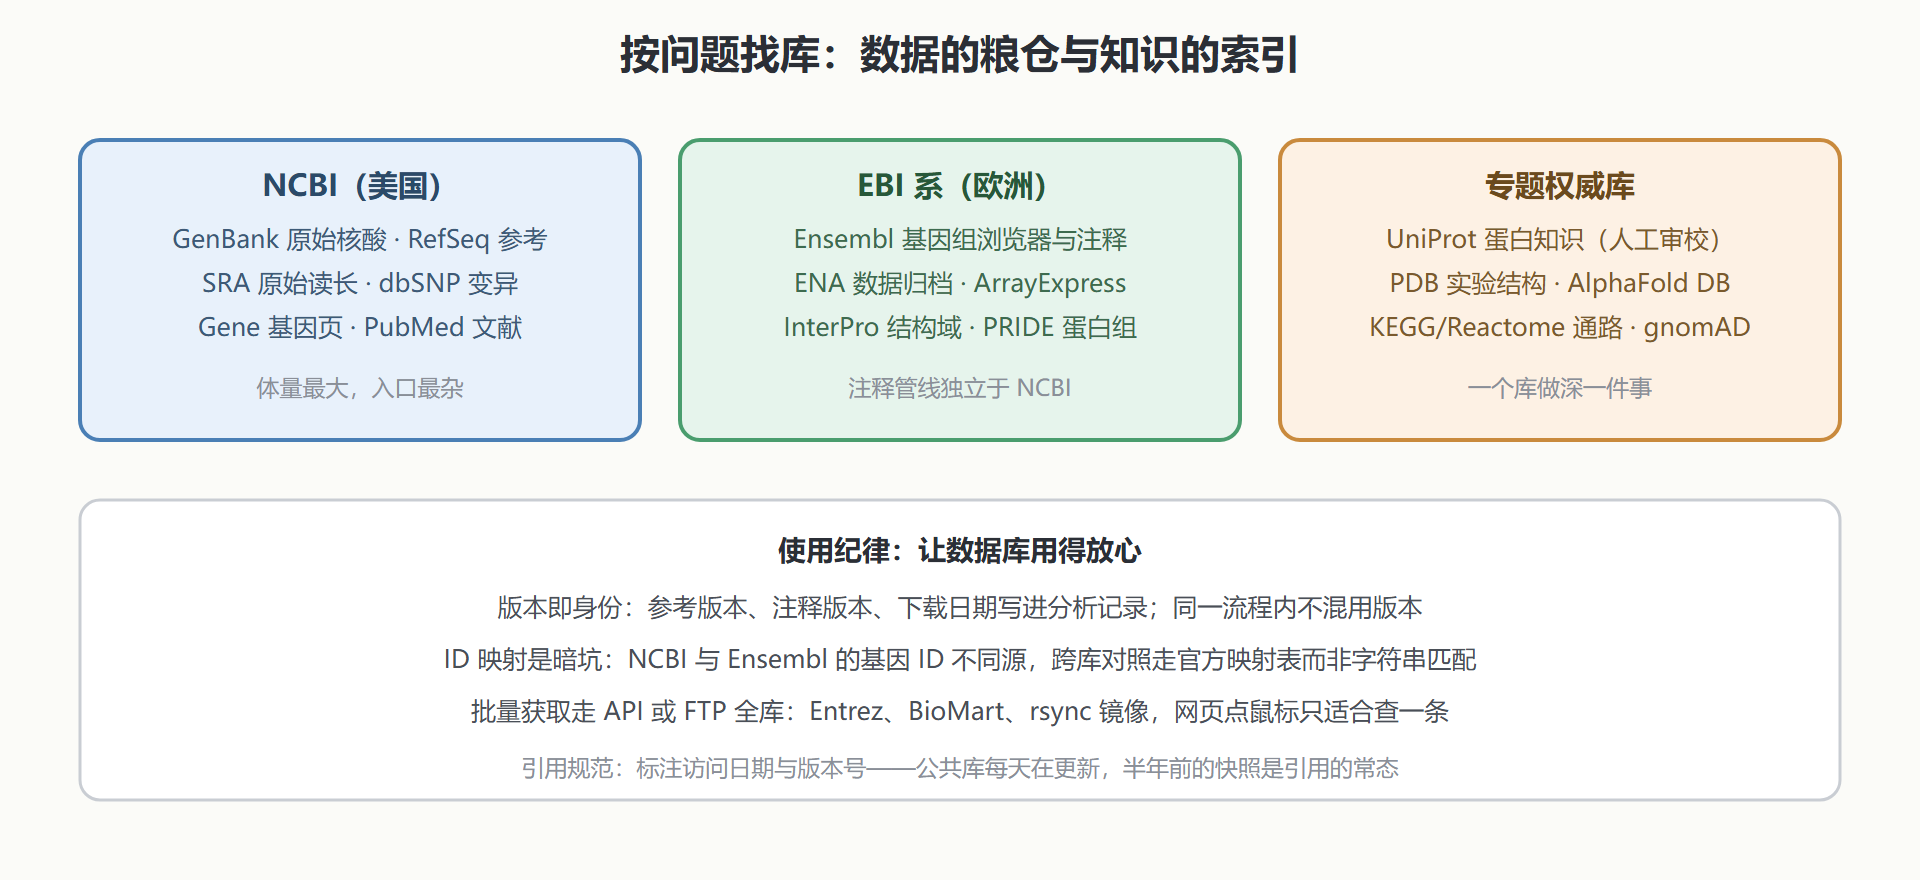
NCBI(美国国家生物技术信息中心)是最大的综合枢纽:GenBank 收核酸序列,RefSeq 提供人工审校的参考序列,SRA 存高通量测序的原始读长(发文章的数据归档地),PubMed 检索文献,Gene 与 dbSNP 分别提供基因注释与变异记录。Ensembl(欧洲 EBI 与 Sanger 研究所运营)是 NCBI 的平行宇宙:同样提供参考基因组与注释,但注释管线独立、基因 ID 体系不同(ENS 开头),系统生物学界常用的比对框架与变异库(Ensembl Variation)也在旗下。UniProt 是蛋白知识的权威库:Swiss-Prot 部分经人工审校,每条记录整合了功能、结构域、亚细胞定位、翻译后修饰、互作与跨库链接。PDB 存实验测定的三维结构,3.7 节的 AlphaFold 预测库补上了预测结构的缺口。
| 你要找什么 | 第一站 | 补充站 |
|---|---|---|
| 参考基因组与注释 | Ensembl / NCBI RefSeq | UCSC Genome Browser |
| 原始测序数据(别人的) | SRA / ENA | GEO 的 supplementary |
| 表达谱与组学数据集 | GEO / ArrayExpress | SRA |
| 蛋白功能与序列 | UniProt | InterPro(结构域) |
| 蛋白三维结构 | PDB | AlphaFold DB(预测) |
| 人群变异频率 | dbSNP / gnomAD | ClinVar(临床意义) |
| 通路与功能分类 | KEGG / Reactome | GO |
| 文献与引用 | PubMed | Europe PMC |
图:公共数据与知识库的地图
批量拿数据的标准姿势
网页点下载只适合单条记录;项目级的数据获取要走程序化接口或整库镜像。几个惯用入口:Entrez(NCBI 的 API,Biopython 的 Entrez 模块封装了它)、BioMart(Ensembl 的批量查询引擎,取"某物种某染色体的全部蛋白编码基因坐标"这类问题一气呵成)、FTP/rsync 全库镜像(SRA Toolkit 的 prefetch 拉原始数据)。数据重用也有伦理边界:SRA 数据里可能藏着受试者可识别信息,人类数据的使用要遵循库里的数据使用政策与原始论文的授权声明。
# Biopython 走 Entrez:取某基因的 FASTA(示例用 E. coli 的 lacZ) from Bio import Entrez Entrez.email = "you@example.edu" # NCBI 要求留联系方式 handle = Entrez.efetch(db="nucleotide", id="NC_000913.3", rettype="fasta", retmode="text", seq_start="3652778", seq_stop="3655413") print(handle.read()[:120])
浏览器:把坐标变成图
Genome Browser 类工具把 FASTA、注释、比对结果叠加在坐标轴上,是人工核查的利器。UCSC Genome Browser 胜在轨道丰富(保守性、重复序列、已知变异全部现成);Ensembl 浏览器胜在注释细;IGV(Integrative Genomics Viewer)是本地工具,直接拖 BAM 进来看 pileup——2.3 节画的那张比对图就是 IGV 的日常视角。变异位点的人工复核、差异基因区域的浏览、结构变异断裂点的确认,全都发生在浏览器里。把浏览器操作当成分析的固定环节,你会在统计结果与序列证据之间建立起直觉的闭环。
人类数据的访问控制与隐私
人类受试者的组学数据分开放与受控两级。开放级数据(多数肿瘤细胞系、已充分去标识的汇总数据)直接下载;受控级数据(来自可识别人群的基因组数据)存放在 dbGaP、EGA 这类受控归档库,要用要提交申请——说明研究用途、签署数据使用条款、经数据提供方与合规层批准,周期以周计。申请材料里最常见的退回原因是用途描述与研究计划不匹配,所以项目立项时就该把数据申请排进时间表。
分析端同样有义务:受控数据不上传到不受控的公有计算环境、结果里不出现试图还原个体身份的统计(如某些位点组合的联合查询)。这些约束写在数据使用条款里,违反不只是伦理问题,还可能牵连所在机构的全部申请权限。合规动作并不重:数据落盘在受控环境、分析代码与去标识结果分离管理、论文只用聚合统计——三件事做到位,绝大多数条款就满足了。
数据报送:把你的数据放进地图
数据库地图是双向的:既取也存。发表语境下的数据报送已成硬要求:测序原始数据进 SRA/ENA(拿登录号写进论文),表达与功能组矩阵进 GEO/ArrayExpress,变异清单进 ClinVar(临床相关位点),蛋白组质谱数据进 PRIDE,结构进 PDB。报送的工程要点是提前准备元数据——样本描述、实验设计、处理流程,这些字段的规范程度决定数据被别人复用的价值;很多库支持提交前校验,投稿排期前先把校验跑通,能省掉发表前的最后一刻慌乱。
数据报送的价值不止于合规:入库的数据获得永久标识(登录号或 DOI),你的分析结果因此变得可引用、可比较、可被后续研究站在上面。领域知识就是这样滚起来的——你取用别人的参考序列与数据集,也以同样方式还回去。
顺带补一条检索技巧:跨库找同一基因的信息,认准稳定的标识符(如 Ensembl 基因 ID 或 UniProt 登录号)作主键,基因符号会随命名委员会的更新而变(同一符号在不同时期可能指不同基因),符号当主键是数据拼接错位的常见根源。工整的做法是把符号到 ID 的映射表随分析脚本一起保存,几年后重跑时映射关系仍然可查。
💡 关键直觉:数据库地图的核心是"版本即身份"。任何一条从库里取出的序列或注释,脱离了版本号就失去了可追溯性——论文里那句"基于 GRCh38 与 Ensembl 108 注释",是结果可信度的地基。
知识有了来源,方法也要有来源:下一节看机器学习怎么进入生物学,以及它的适用边界。