4.4 机器学习进入生物学:能做什么、不能做什么
4.4 机器学习进入生物学:能做什么、不能做什么
本节摘要:从差异基因列表到 AlphaFold2,机器学习已渗透进组学分析的每个环节。本节按监督与无监督两条线梳理典型应用,讲清特征、样本量与数据泄漏这三个决定成败的要素。
两条学习路线在生物学里的对应
无监督学习不设标签,让数据自己显出结构——组学分析里它是探索的主力。聚类把样本按表达谱分组:肿瘤转录组聚类出的亚型(如乳腺癌的腔面、基底样分型)已成为临床语言;主成分分析(PCA)是每个组学项目的第一张图,样本在主成分上的分布暴露批次效应与离群样本——2.6 节的差异分析之前先画 PCA,是标准纪律。
监督学习带标签训练,目标是预测新样本。组学里典型任务包括:用基因表达预测药物响应(标签是敏感/耐药)、用序列预测蛋白功能(标签来自 GO 注释)、用突变特征预测肿瘤对免疫治疗的反应。模型选择上有个反直觉的经验:树模型(随机森林、梯度提升)在中小规模表格数据上长期稳赢深度学习——组学特征动辄两万维、样本只有几十到几百个,深度网络的参数量是灾难;深度学习的主场在序列与结构这类有空间结构的输入上,AlphaFold2 正是代表。
三个决定成败的要素
特征选择:两万维特征对五十个样本,直接塞模型必过拟合。常见手段按保守到激进排序:方差过滤(去掉几乎不变的基因)、单变量过滤(挑与标签相关的头部基因)、L1 正则自动稀疏、以及领域知识硬选(只进通路基因)。特征越多越错的规律在组学屡试不爽,五到五十个稳健特征往往泛化最好。
样本量与验证设计:几十个样本分出测试集后,训练集小到学不出稳定规律——所以组学论文的标准做法是交叉验证(五折或留一),再配一个独立外部队列做最终检验。交叉验证的方差要报告(各折分数的波动),只报均值是在掩盖不稳。
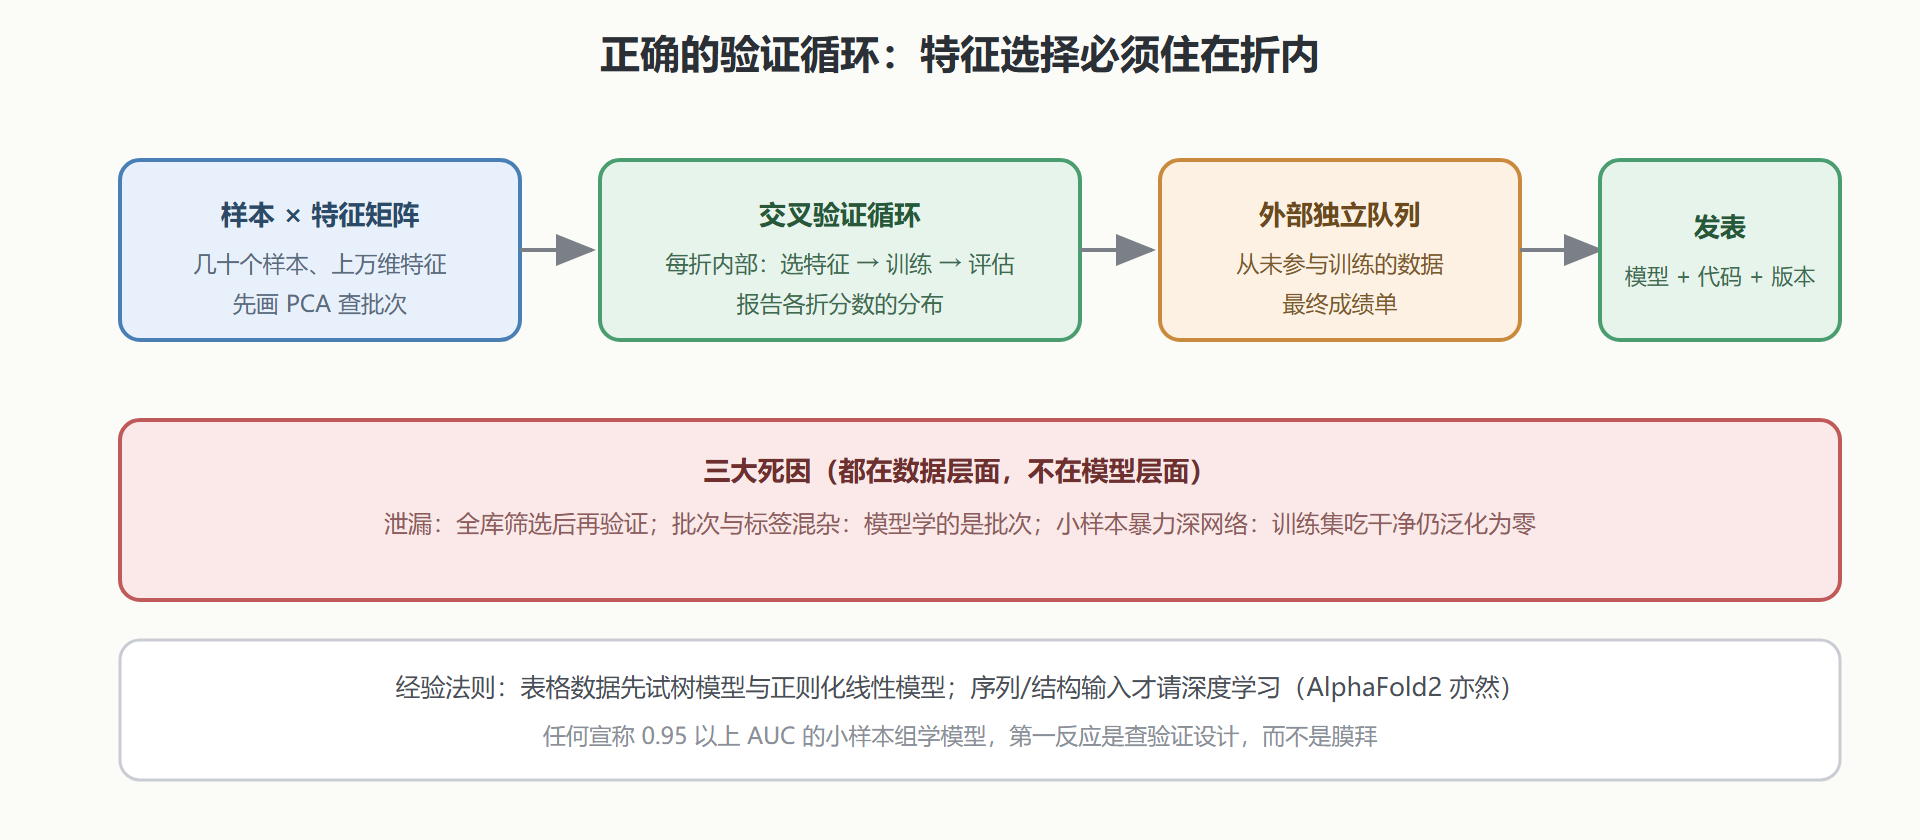
数据泄漏:这是组学机器学习的第一死因。典型形态:在全部样本上先做了差异筛选(用了标签信息),再交叉验证——测试集的信息已经渗进特征选择,交叉验证分数虚高。正确顺序是每折内部独立完成"筛选+训练+评估",特征选择必须包在验证循环里。第二个形态是批次与标签混杂:两个批次的样本恰好标签不同,模型学到的是批次不是生物学——防法是混批设计加按批次分层的验证。
from sklearn.ensemble import RandomForestClassifier from sklearn.pipeline import make_pipeline from sklearn.feature_selection import SelectKBest, f_classif from sklearn.model_selection import cross_val_score # 管道把特征选择包进验证循环,杜绝泄漏 pipe = make_pipeline( SelectKBest(f_classif, k=20), # 每折内部独立选基因 RandomForestClassifier(n_estimators=500, random_state=1), ) scores = cross_val_score(pipe, X_expr, y_response, cv=5) print("各折 AUC:", scores, "均值:", scores.mean().round(3))
图:组学机器学习的工作流与泄漏防线
从预测到解释
预测准只是及格线,生物学更关心"模型学到了什么"。树模型给特征重要性排名,线性模型看系数方向,SHAP 值把每个特征的贡献拆到单样本级——解释工具的目的不是装饰,而是回到生物学检验:模型挑出的头部基因是否富集在合理通路、方向是否符合已知机制。解释与 3.6 节的网络分析在此接轨:把模型特征映射到互作网络,常常能看出模型其实在重建一条已知通路——这既是模型可信的证据,也是发现新成员的机会。
最后校准期望:组学机器学习的高分论文很多,落地的前瞻性验证很少。癌症预测模型的临床转化需要跨中心、跨平台、数千样本的外部验证,多数模型止步于此。把模型当"生成假设的工具"而不是"诊断产品",是这个阶段的正确心态。
亚型发现:无监督学习的纪律
聚类找亚型(无监督路线)比监督预测更容易自欺,因为"簇"太容易被看出来了——任何数据随便聚类都会出簇,问题是簇有没有生物学含义。纪律从验证开始:簇的稳定性要在重采样下检验(bootstrap 聚类,样本扰动后成员关系是否保持);簇的分离度要在 PCA 之外的独立投影里复核;簇数的选择要有依据(轮廓系数、间隙统计或共识矩阵),而不是"分四组讲起来顺"。最关键的一条是生存分析(临床数据里):一个亚型要配上不同的生存曲线或治疗响应,才从"数学簇"升级为"生物学亚型"。
历史上站住了的亚型分型(乳腺癌的分子分型是最著名案例)都有共同特征:跨平台可复现、有稳定的标志基因面板、能独立预测临床结局。这三条也是评估任何新亚型声明时的检查单——审稿人按这张单子打分,你写论文前自己先打一遍。
从回归到因果:一个必要的边界
预测模型回答"谁能被预测",回答不了"改变它会怎样"。用基因表达预测药物响应的模型,逻辑回归给的是条件概率;拿它去指导"把某个基因敲低会不会增敏",就把预测当成了因果——这是组学机器学习里最贵的误用。因果问题要靠扰动数据回答:随机化实验、基因编辑筛选、时间序列干预。观察性组学数据里的混杂(年龄、批次、肿瘤纯度)会让相关性与因果在方向上彻底分家,孟德尔随机化这类工具在满足假设时能部分补救,但假设本身(工具变量无多效性)在基因组语境里常常存疑。
务实的分工是:机器学习负责筛出值得扰动验证的候选,实验负责因果判决。把两条腿的分工写进项目计划,可以避免团队在"模型分数很高但实验验证失败"的死循环里空转——那不是实验失败,是问题从一开始就问错了方向。
💡 关键直觉:小样本高维数据里,验证设计比模型选择重要一个数量级。把数据泄漏防住、把批次效应打散,哪怕用逻辑回归,分数也常常比乱用深度网络更可信。
方法讲完了,下一节回到表达的出口:结果最终要画成图给人看,生物数据的图有自己的惯例与雷区。