4.6 可重复分析:工作流引擎与容器化
4.6 可重复分析:工作流引擎与容器化
本节摘要:几十个样本、上百个步骤的分析不可能靠手敲命令维持正确性。本节讲工作流引擎如何用声明式依赖图管理流程,容器如何锁死环境,以及可重复性从"跑通"到"可引用"的分级标准。
从脚本到工作流:为什么必须换范式
分析超过三个样本,手敲命令就会出错:某样本漏跑、断点后不知道从哪续、参数改了但只改了一半。工作流引擎(Nextflow、Snakemake、WDL/Cromwell)解决的就是规模化执行的三个问题:依赖管理(哪些步骤的输入已就绪)、断点续跑(只重跑受影响的下游)、并行调度(几十个样本自动铺满集群)。
工作流的写法是声明式的:你声明"输出 C 依赖输入 A 和 B,由命令 f 产生",引擎自己推算执行顺序。以 Snakemake 为例:
rule bwa_mem: input: fq1="trimmed/{sample}_R1.fq.gz", fq2="trimmed/{sample}_R2.fq.gz", ref="ref/grch38.fa" output: bam="mapped/{sample}.bam" shell: "bwa mem -t 8 {input.ref} {input.fq1} {input.fq2} " "| samtools sort -@ 4 -o {output.bam}" rule fastqc: input: "raw/{sample}.fastq.gz" output: "qc/{sample}_fastqc.html" shell: "fastqc {input} -o qc/" # snakemake --cores 16:引擎按依赖图自动调度,改了 fastqc 的输出, # 下游比对自动重跑受影响样本,没改的上游不会白跑
通配符(sample)让规则对全部样本生效——规则只写一次,实例自动展开。这与手写 for 循环的本质区别是:依赖关系是引擎算出来的,不靠你脑子记。断点续跑配合集群配置文件,同样一份流程可以从笔记本平滑搬到上百核的服务器,这是生信项目"数据涨了十倍、脚本没改一行"的底气来源。
容器:把环境整个打包
工作流管步骤的顺序,容器管步骤的环境。Docker(集群场景常用 rootless 的 Apptainer/Singularity)把操作系统库、工具、依赖全部封进一个镜像:镜像在任何机器上展开都是字节级一致的环境。"在我电脑上能跑"这句话在容器面前失效——因为跑的不再是"你的电脑",是镜像。
# 用一份带工具链的公共镜像跑比对(镜像固定版本号) apptainer exec docker://biocontainers/bwa:v0.7.17_cv1 \ bwa mem ref.fa R1.fq.gz R2.fq.gz > aln.sam # 工作流引擎原生支持容器:Nextflow 里一行配置 # process.container = 'quay.io/biocontainers/samtools:1.17--h8c37831_1'
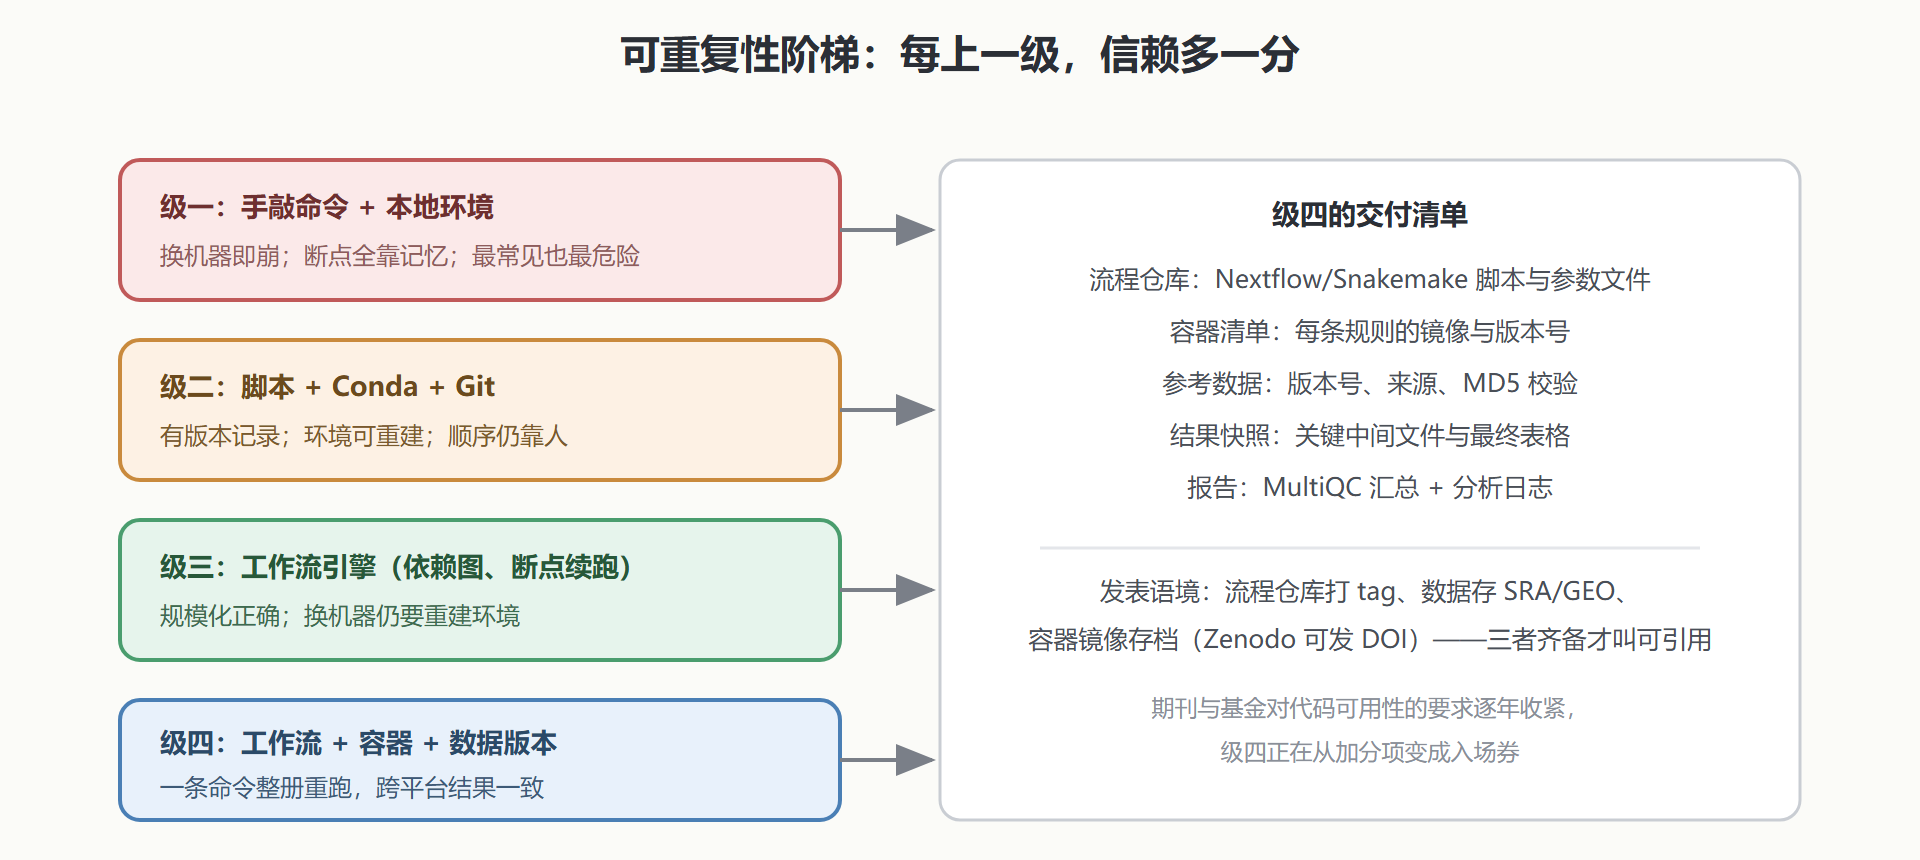
生物工具的容器生态是 Biocontainers 项目统一维护的,主流工具都有带版本号的现成镜像。工程实践是把工作流与容器绑定:Nextflow/Snakemake 配置里为每条规则指定镜像,引擎运行时自动拉取。这样得到的流程包,交付给合作者时是"一条命令 + 一个参数文件",跨平台跑出的结果与原机器一致。
图:可重复性的分级——从能跑到能引用
实战里的取舍与坑
工作流的迁移成本主要在把既有脚本改写成规则:变量路径要标准化、每步输入输出要显式声明。建议的节奏是新项目从第一个分析就上工作流(改造成本最低),老项目用"哪些步骤要重跑"来决定是否值得改造。容器的坑集中在数据卷:镜像里不放大数据,数据经挂载进容器;镜像标签用完整版本号,不用 latest——latest 会漂移,漂移就破坏了一致性。
还有一个常被忽视的层面:结果的可重复不等于结论的可重复。同样的流程跑出同样的表格是级四的承诺;但如果原始数据本身有批次混杂、样本量不足,精确复现的错误结论照样是错误结论。工程可重复与统计可重复(4.4 节)必须同时在场,流程只是后者能被检验的前提。
数据版本与自动化检查
流程与环境之外,可重复性还有一块常被漏掉的基石:数据本身的版本。原始 FASTQ、参考序列、注释文件、中间产物都该有校验和(MD5/SHA256)与来源记录,随流程仓库一起管理。数据校验的价值在事故复盘时显现——结果异常时先比对校验和,能立刻排除"文件悄悄坏了"或"参考被覆盖"这类无声灾难;没有校验和,这些排查要耗掉一整天。
再往上一层是自动检查:把关键断言写进流程(每个样本的比对率不低于某阈值、每个输出文件的行数在预期范围、统计表无缺失样本),任何一步检查不过就停止流程。这些断言就是流程的体温计——绝大多数下游事故的前兆,都会在某个中间检查点上提前露出马脚。配合 Git 钩子或持续集成(每次提交自动跑一个小样本的端到端测试),流程的"体检"就常态化了。这套机制的投入不过几十行配置,回报是深夜跑大队列时的踏实睡眠。
参数管理与项目骨架
可重复体系落地到日常,还差一横一纵。横的是参数管理:所有可调项(阈值、路径、版本号)集中在一个参数文件里,流程只读参数不改代码——调参变成改配置而不是改脚本,误改代码的风险归零,参数随项目归档后,"哪个结果用了哪组参数"永远有据可查。纵的是项目目录骨架:原始数据、参考数据、中间产物、结果、报告各居其位,命名规则统一(样本标识贯穿始终),原始数据只读不可写。骨架看起来是洁癖,实际是排错效率——路径可预测的项目,出问题时一半的排查时间都省了。
开源社区有几个成熟的项目模板(如针对 RNA-seq 的端到端示例流程)可以直接套用起步,比从零搭快得多;套用后按自身项目裁剪,保留其参数与目录的纪律即可。可重复性工程的门槛不在技术复杂度,而在"从项目第一天就执行"的纪律。
💡 关键直觉:工作流与容器分别锁死"顺序"与"环境"两个变量。分析出错时,能在几小时内排除这两类原因、把问题逼到数据或参数上,就是这套体系回报给你的时间。
工具体系至此闭环。最后一章回到问题链的出口:这套能力在临床、药物、生态与前沿组学里,究竟怎么变成发现。