4.5 把结果画出来:生物数据的可视化惯例与雷区
4.5 把结果画出来:生物数据的可视化惯例与雷区
本节摘要:组学数据的图形语言已经高度约定俗成:PCA 图查批次、火山图挑基因、热图看模块、覆盖图核变异。本节按分析流程梳理各阶段的标配图形,讲每张图该看什么、常见的画法错误,以及一张图怎么才算合格。
图形是分析的语言,不是装饰
组学分析链上每个环节都有对应的"标配图",而且读者(导师、审稿人、合作者)默认你会按惯例画。惯例的价值在于把沟通成本降到零:一张按约定编码的火山图,行家三秒钟读完结论。反过来,把惯例图改造成"创意图表",等于强迫读者重新解码——这是新手论文被批"图看不懂"的根源。本节按分析推进的顺序过一遍标配图形。
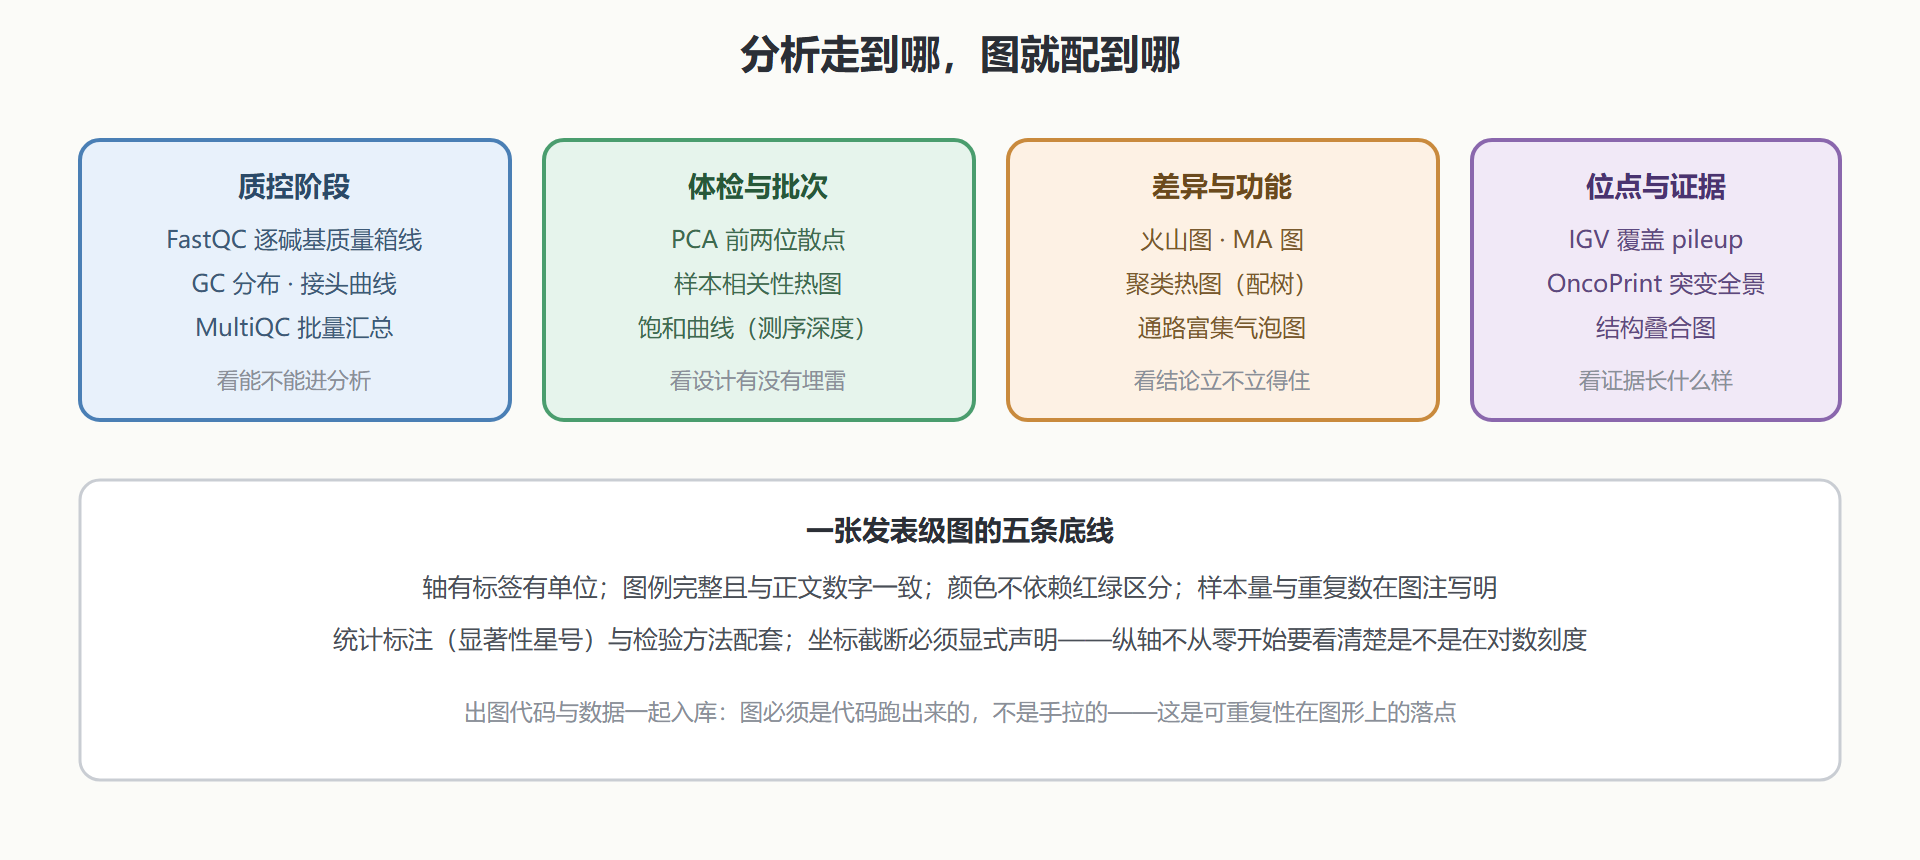
数据体检阶段:PCA 与样本相关性热图。PCA 图看三件事——样本是否按分组分开(生物学信号)、是否按批次分开(技术问题,2.6 节的差异分析会被批次污染)、有没有离群样本(该剔除或复查)。相关性热图看组内是否抱团、组间是否分离,原理与 PCA 互补。这两张图是任何差异分析的前置闸门,跳过它们直接跑 DESeq2 是常见的事故起点。
差异结果阶段:火山图(2.6 节已细讲)与 MA 图。MA 图横轴是表达均值、纵轴是倍数变化,专门暴露"低表达基因倍数虚高"的技术伪影——与火山图对照着看,能判断倍数变化阈值是否被低表达噪声污染。
模块与谱系:热图与降维图
热图是差异结果的定格照片:行是基因(通常取显著性前几十个),列是样本,颜色编码表达量,配行树与列树显示聚类结构。热图的阅读约定有四条:行要按聚类重排让模式显形、颜色标度要对称(对数倍数变化以零为中心)、色板要避免红绿双色(约百分之几的读者有红绿色盲,主流期刊已不建议)、要标注行名与色标数值。一张好热图,模块结构不靠讲解就能看出。
单细胞数据用降维散点图(t-SNE、UMAP):每个点一个细胞,颜色按细胞类型或基因表达上色。它的雷区在过度解读:降维图的距离与簇的形状受超参数影响很大,点在图上的绝对位置没有意义,只有"谁跟谁抱团"的相对关系可读。发图时必须附上降维参数,簇的生物学身份要靠标志基因表达回验,而不是看图说话。
图:一张分析全流程的标配图单
从图到数字:别让颜色撒谎
可视化里最大的伦理问题是用图形编码放大噪声。经典手法是调色板截断:热图把色标范围压得很窄,噪声就"看起来"差异巨大——判读热图先看色标范围再信颜色。其次是散点图的过度拟合线:两个变量各带几千个点的相关性,画一条回归线配 R 值没问题,但如果点云明显分簇,单一线条就是在撒谎——分簇着色或分面画才是诚实版本。还有双轴图的陷阱:两条量纲不同的曲线叠在双轴上,左右轴的刻度范围随手一调,就能把无关波动调成"完美同步"——审稿人对双轴图的默认反应是怀疑,能不用就不用。
工具层面,R 的 ggplot2 与 ComplexHeatmap(热图)、Python 的 matplotlib/seaborn 覆盖绝大多数需求;基因组位点的浏览器截图(IGV)与结构叠合图(PyMOL/ChimeraX)各有专门工具。出图纪律与代码纪律同构:图必须由脚本可重复地生成,数据到图之间不经过人工修图。
探索图与发表图的分工
分析过程中画的图与最终放进论文的图是两类物件,值得分开对待。探索图追求速度:随手一段 ggplot 或 seaborn,看分布、看相关、看批次,图丑无所谓,生命周期以分钟计。发表图追求精确:轴、色板、字体、图注反复打磨,生命周期以年计。两类图的失败模式恰好相反——探索图的失败是画太慢拖累分析节奏,发表图的失败是细节不过关被审稿人挑刺。混用两种标准(用发表级的打磨标准画探索图,或把探索图直接端进论文)是两个方向都常见的低效。
工程上还有一个从探索到发表的加速通道:把常画的惯例图封装成自己的函数或模板(火山图一个函数、热图一个函数、UMAP 上色一个函数),存进个人的绘图工具包。分析出新结果时先跑封装版看一眼(探索),确认要进论文再调参数精修(发表)。封装的副产品是全项目图形风格自动统一——审稿人对图形一致性的好感,很多时候就是这种细节给的。
组合图与报告级排版
发表级结果很少是单图独奏,更多是组合图:主图分区(A、B、C、D 面板),每区承担一个论证步骤——质控、全局结构、差异结果、功能解读依次排布。组合图的排版纪律:各面板的字号与线条粗细统一(放大缩小后视觉一致)、配色全图一致(同一分组在所有面板里同一颜色)、面板间距与对齐严格(网格对齐而非目测)。工具上,R 的 patchwork/cowplot 与 Python 的 subplots 都能实现精确拼版;矢量格式(PDF/SVG)交付,期刊排版时缩放不失真。主图的取舍原则也值得说破:不是把所有图塞进一张大图,而是选一条最短的论证路径——审稿人翻到主图时应能在半分钟内走完"数据可信、结论成立"的推理线,其余图表全部下沉到补充材料。补充图不是杂物间:同样要有图注与编号逻辑,按主线图的引用顺序排列。
图注是组合图的另一半生命。合格图注的四件套:这张图画了什么(样本与统计口径)、怎么看(颜色与形状的编码)、关键结论(一句话)、统计细节(检验方法、重复数、误差线含义)。审稿人对图注的挑剔不亚于对图本身——图让证据可见,图注让证据可查,两者合起来才算完整的可视化。
交互式图形(单细胞数据的在线浏览器、基因组位点的交互查看器)正在成为论文补充材料的新形态:读者能自己缩放、框选、查基因。交互图的纪律是把"默认视图"调到结论一眼可见,别指望读者自己探索出你的论点;静态版主线图同时保留,审稿与存档都以静态为准。图形规范在缓慢演化,但准则不变——让读者用最少的力气看到你最有把握的证据。最后一条工程建议:把出图脚本的数据输入固定为标准的表格文件(而不是内存对象),图与数据之间只隔一个可重跑的脚本,协作与返工都轻松。
💡 关键直觉:可视化不是把数字变漂亮,而是把证据的形状摆到读者眼前。惯例图之所以是惯例,是因为它们把最容易被骗的维度(倍数、显著性、批次、覆盖)固定放在了固定的位置。
图画好了、结论有了,最后一块拼图是让这一切在半年后还能重跑:下一节把工作流与容器讲清楚。