5.2 药物发现与疫苗设计:计算在链条的哪些位置
5.2 药物发现与疫苗设计:计算在链条的哪些位置
本节摘要:新药从靶点到上市平均要十年上下,计算方法的任务是缩短其中最贵的环节。本节梳理靶点发现、虚拟筛选、结构辅助设计三个计算密集位置,并用 mRNA 疫苗与病毒基因组监测两个案例看技术闭环。
靶点发现:从组学差异到可用药假设
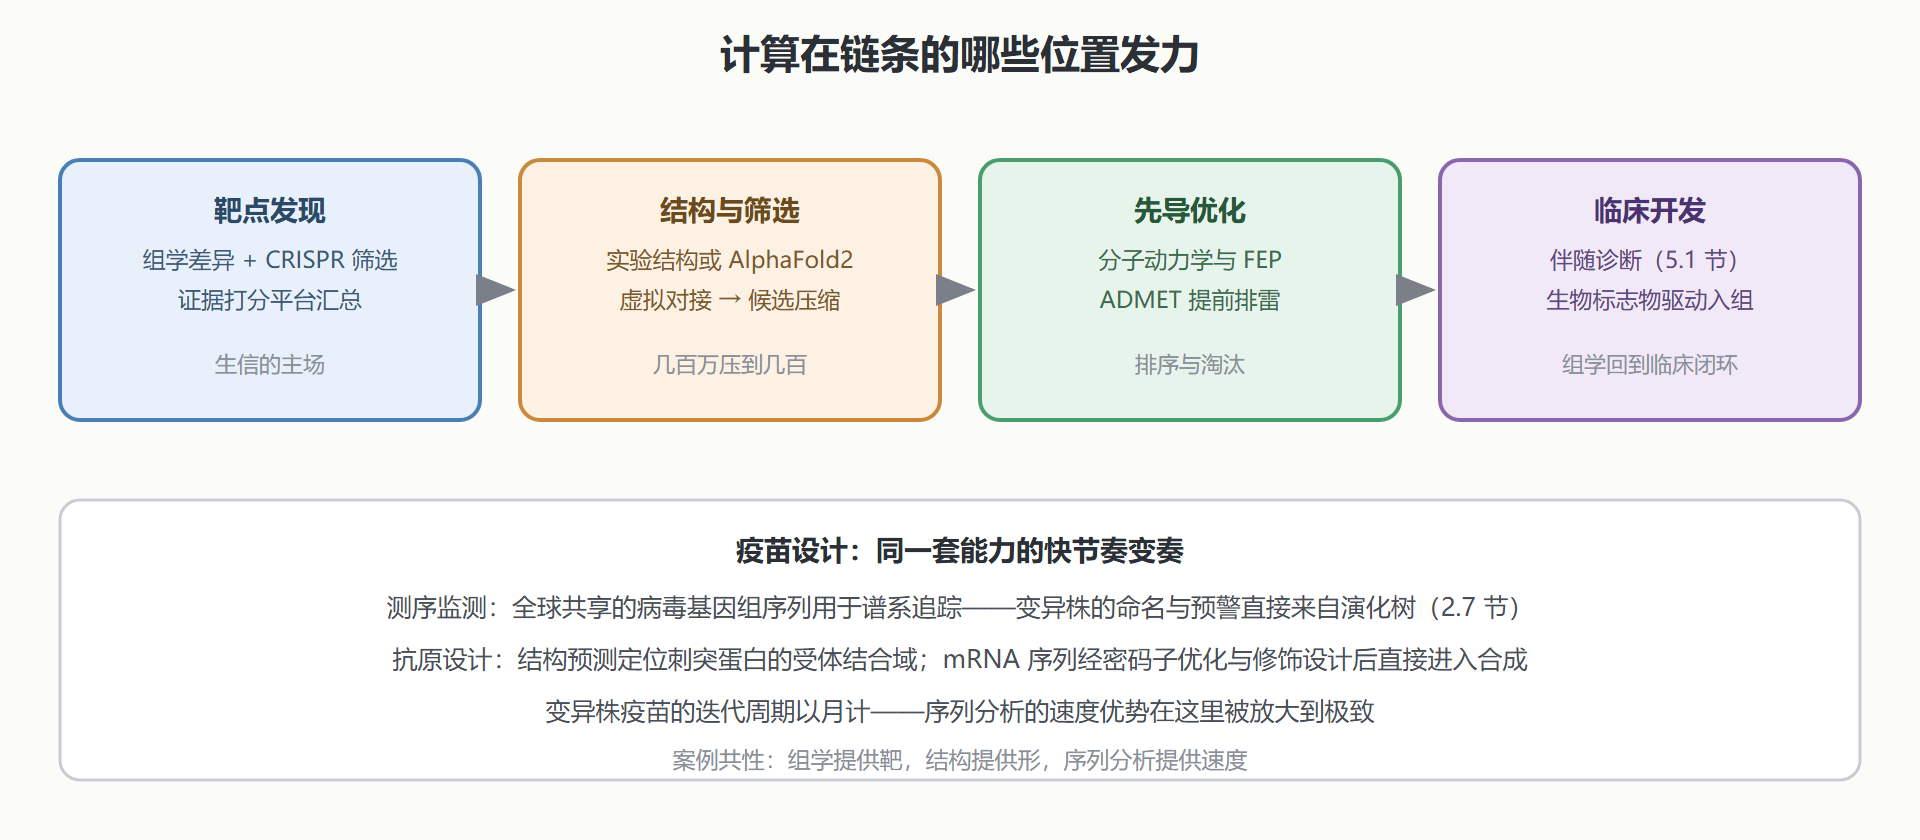
药物研发的第一问是"打哪个蛋白"。组学数据是靶点假设的主要来源:肿瘤与正常组织的差异表达与蛋白定量(第 2、3 章的方法)指认过度活跃的分子;CRISPR 筛选(全基因组敲除后看哪些细胞活不下来)提供功能层面的必要性证据;公共数据库把两者合流——Confidential 项目之外,Open Targets 平台把遗传学证据、组学证据、动物模型、文献证据打分汇总成靶点关联分。可用药性(druggability)是第二道筛:靶点最好是有明确口袋的酶或受体,骨架蛋白与转录因子长期难啃(近年蛋白降解技术 PROTAC 才给它们开了口子)。
贯穿案例在这里再出场:差异分析指认的激酶通路、蛋白组确认的磷酸化激活,写成靶点假设书交给药物化学家——生信的产出在药企语境里就是这类"有证据链的假设",而不是一张裸的基因列表。
虚拟筛选与结构辅助设计
有了靶点结构(实验的或 AlphaFold2 预测的,3.7 节),下一个计算密集环节是找到先导化合物。虚拟筛选分两条路:基于结构的对接——把数十万小分子的三维结构逐个放进靶点口袋打分,按结合能排序,挑头部几十个去做湿实验复筛;基于配体的相似性搜索——已知若干活性分子时,在化学库里找形状与电性相似的邻居。对接的分数不能太当真:打分函数误差大,排序头部与中部的区分度有限,虚拟筛选的价值在于把"几百万化合物"压缩到"几百个可测候选",把湿实验的钱花在刀刃上。
先导优化阶段计算继续在场:分子动力学模拟评估结合稳定性、自由能微扰(FEP)在同类分子间做精细排序、 ADMET 预测(吸收、代谢、毒性)提前排雷。这些方法的共同气质是"排序与淘汰"而非"判决"——计算缩小搜索空间,实验负责最终裁决。历史上结构生物信息学的高光案例(基于结构的抗流感神经氨酸酶抑制剂设计)说明了上限:结构信息用得早、用得准,真能省下一个数量级的试错。
图:药物发现链条上的计算位置
疫苗设计的闭环案例
mRNA 疫苗的设计流程几乎全册方法各出一手。病毒监测网络持续上传基因组序列,序列分析定位变异在刺突蛋白上的累积(比对与变异检测的小型重演);结构预测与实验结构标出变异与抗体逃逸的关系(3.7 节);选定的抗原序列做反向翻译、密码子优化(适配人类密码子偏好)、加修饰碱基降低免疫原性——序列从数据库到合成只要几天。这个案例最值得记住的地方是它的反馈速度:基因组监测、序列设计、产能落地的整条链以周为单位运转,而这整条链的每一格,都是前四章的工具在驱动。
药物与疫苗的差异同样有启发:药物打的是患者体内的靶蛋白,靶点错误要到临床试验才暴露,试错以年计;疫苗打的多数是外源病原,抗原序列直接可测,试错以月计。计算方法在这两处的杠杆率不同——越是"靶点清晰、结构可得、迭代要快"的场景,前面章节的方法杠杆越长。
生物标志物:让临床试验更聪明
组学对药物链条的另一大贡献是标志物驱动的试验设计。传统试验把所有患者混在一起平均,若药物只对四成患者有效,整体疗效被稀释到可能过不了审批。标志物驱动的试验反过来:先用伴随诊断把可能响应的患者筛出来再入组——同一款药的临床成功率因此显著抬升,这也是"药物与诊断同步开发"模式的由来。试验设计的变体各有取舍:富集设计(只入标志物阳性者)效率最高但要求标志物可靠;适应性设计(先入全人群、中期按标志物分层调整)更稳但更复杂。
标志物本身的开发就是全册方法的连环应用:发现阶段用差异分析与生存关联找出候选(2.6 节的框架)、验证阶段在独立队列检验预测力(4.4 节的验证纪律)、定型阶段把检测固化成 IVD 级流程(5.1 节的性能验证)。三个阶段对应三种失败模式:发现阶段过拟合、验证阶段批次混杂、定型阶段性能不达标——每一步的坑在前面的章节都铺过路。药企里"转化研究"岗位的日常工作,就是把这条链上的分析接起来。
老药新用:数据驱动的一条捷径
新药从头研发以十年计,而"老药新用"(repurposing)在已批准药物里找新适应症,安全性档案现成,周期可以压缩大半。计算方法在这个赛道特别活跃:基因表达签名反向匹配——疾病样本的表达谱与药物处理的细胞表达谱做签名相关,药物把疾病 signature 拉回健康方向即为候选(连接性地图平台的核心思路);蛋白组反向关联——药物的已知靶点蛋白与疾病的差异蛋白在网络上的距离;真实世界证据——处方数据库与疾病登记库的统计关联提示。新冠疫情期间的候选药物快速筛选,把这几种方法的组合拳公开演练了一遍。
repurposing 的候选同样要过完整验证:剂量窗、组织暴露量、临床终点一个都不能省。它的方法论价值在于示范了"公共数据 + 统计推断"能在药物链条的最前端提供多么便宜的假设生成——这也呼应了本节的主旨:计算的角色是提高假设质量,把昂贵的实验注意力用在少数高价值候选上。
给想进入这个方向的分析人员的最后一张清单:读懂靶点的生物学(通路位置、结构域、已知配体);会用至少一套对接与分子可视化工具(懂原理与局限即可,不必成为化学家);能设计并解读标志物驱动的比较(生存分析、响应分层);以及最重要的——与化学、药理同事对话的语言能力。计算药物发现是团队运动,单点技术优势远不如跨语言协作值钱。入行的现实路径也清晰:结构生物学或化学背景的补统计与组学,生信背景的补结构与成药性知识,两边的交汇处就是这个岗位的价值所在。面试或轮岗时最加分的展示,是把一个从组学证据到用药假设的完整案例讲清楚——本册的问题链恰好就是这条线的练习册。
💡 关键直觉:计算在药物链条里的角色是压缩搜索空间,不是替代实验判决。靶点假设要组学证据链、筛选要结构、临床要标志物——生信提供的是"让贵实验少走弯路"的证据。
从药物回到群体生态:下一站钻进微生物世界,看不打扰培养的方法怎么认识一个群落。