5.3 微生物组:不培养也能认识一个群落
5.3 微生物组:不培养也能认识一个群落
本节摘要:环境与肠道里的绝大多数微生物无法人工培养,测序成了唯一的全景窗口。本节讲 16S 扩增子与宏基因组两条分析路线,并重点拆解丰度数据的成分性陷阱——这是微生物组统计翻车率最高的地方。
培养的墙与测序的窗
传统微生物学靠培养:单菌落纯化、生理生化鉴定。问题在于环境样本里能被培养的物种可能只占一成上下,多数微生物的需求苛刻到实验室模拟不了。测序绕开了这堵墙:直接对环境样本里的混合 DNA 读序,从序列推断"谁在、多少、在做什么"。肠道菌群研究近十年的爆发,技术上就建立在两套测序路线上——16S 扩增子与全宏基因组。
两条路线的分野在于读什么。16S 扩增子只测核糖体小亚基基因的一个高变区:用保守引物扩增、对扩增产物测序,按序列聚类成 ASV/OTU 再对参考库(如 SILVA)注释物种。成本低、数据小、分析标准化程度高,适合大规模队列做"谁在"的组成比较;局限是只有属种级的分辨率、测不到功能基因。全宏基因组测序(shotgun metagenomics)直接打碎全部基因组 DNA 测序:既回答"谁在"(物种分类,分辨率到菌株级)也回答"能做什么"(功能基因与通路丰度,用 KEgg/KO 或 MetaCyc 注释),代价是数据量大、宿主污染要处理、组装与 binning(把读长归回基因组箱)的计算成本高。
一次标准分析的流程骨架
以肠道菌群的两群体比较为例(疾病组与对照组各几十人)。路线 A(16S):扩增、混样上机、质控去引物、DADA2 类工具按错误模型生成 ASV、对 SILVA 注释、抽平或用组成型方法比较组间差异、多样性分析(α 多样性看样本内丰富度,β 多样性看样本间结构差异)。路线 B(shotgun):质控去宿主与低质量、按物种标记基因或 k-mer 分类(Kraken2、MetaPhlAn)估计物种丰度、组装与基因预测构建功能谱、组间差异检验。
# 16S 主线(QIIME2 风格的流程骨架) qiime2 import --type 'SampleData[PairedEndSequencesWithQuality]' \ --input-path manifest.tsv --output-path demux.qza qiime2 dada2 denoise-paired --i-demultiplexed-seqs demux.qza \ --p-trim-left-f 17 --p-trunc-len-f 280 --o-table table.qza qiime2 feature-classifier classify-sklearn \ --i-classifier silva-138-99-nb-classifier.qza --i-reads rep-seqs.qza \ --o-classification taxonomy.qza # 产出:ASV 计数表 + 物种注释表,进入多样性与差异分析
图:丰度矩阵的成分性陷阱
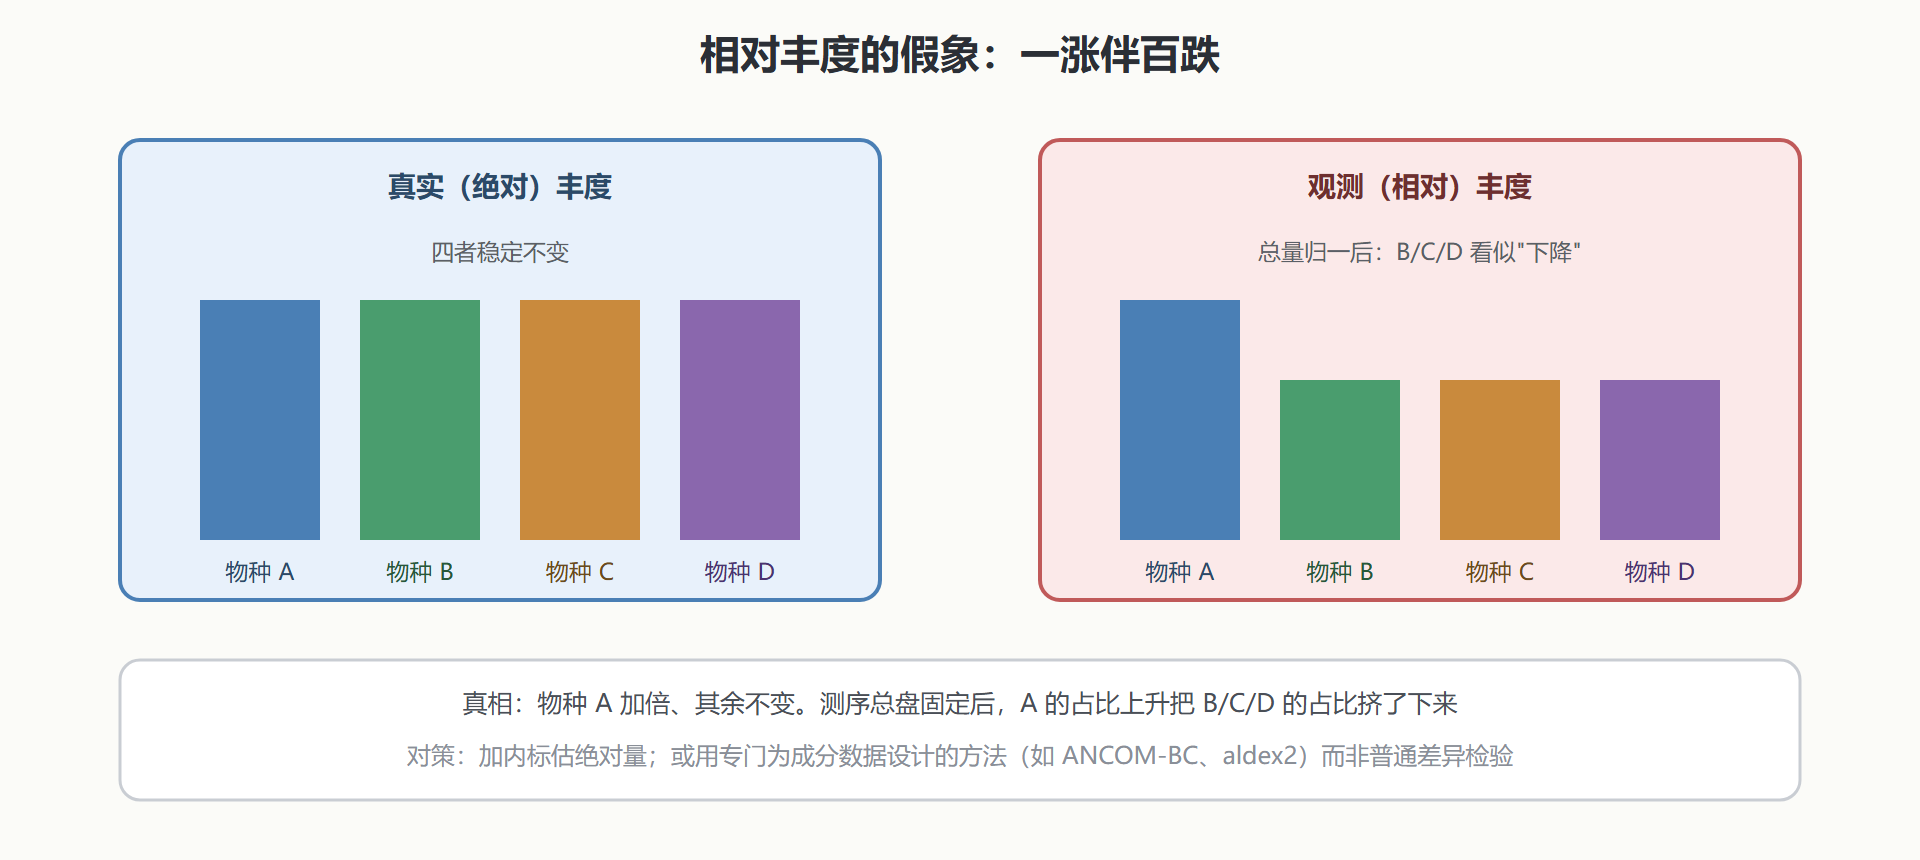
成分性:这个领域的头号统计陷阱
测序给出的丰度永远是相对的——reads 总量被归一到固定盘子里。这带来一个反直觉后果:即使群落里只有一个物种真实增殖、其他全都没变,归一后其他物种的相对占比也会"下降"。把相对丰度直接喂给普通的 t 检验或 DESeq2(它们假设各基因独立),就会批量制造假差异。这不是理论洁癖:肠道菌群研究里大量早期"某菌减少与疾病相关"的结论,复检时站不住脚,成分性是主要嫌疑人之一。
工程上的三层对策。设计层:加已知量的内标(spike-in)或定量 PCR 锚定绝对丰度,让相对变回绝对。方法层:用专门为成分数据设计的方法(ANCOM-BC、aldex2、MaAsLin 系),它们显式建模归一化约束。解释层:报告差异时明确写"相对丰度差异",避免"绝对减少"的断言。与 2.6 节对照会发现熟悉的影子——DESeq2 的 size factor 归一化解决的也是同一族问题,只是微生物组数据的约束更极端(总盘恒定、零值海量)。
功能与生态的出口在组成之上。功能丰度用 KO/通路层级比较,把"谁变了"升级为"什么能力变了";共现网络(物种间相关性网络)与 3.6 节的互作网络同构但要小心解释——相关性不是互作,批次与成分性都能造出假边。菌群-宿主关联(如菌群与免疫治疗的响应关联)是当下的热点出口,分析套路仍是全册的骨架:先体检(批次、成分性),再检验(多重校正),最后用机制收尾。
多样性指标:把"群落像不像"量化
微生物组的入门统计是两组多样性指标,读法要分开。α 多样性描述单个样本内部:丰富度(物种数)与均匀度(各物种占比是否均衡)合成常用指数(Shannon、Simpson),回答"这个肠道里住了多少种、住得均不均"。经验规律:饮食单一、抗生素暴露后的样本 α 多样性偏低;但"多样性高就是健康"是过度简化——某些疾病状态(如阴道菌群的大洋洲型)反而以低多样性为特征,指标要与场景结合解读。β 多样性描述样本之间的组成差异:把每对样本的差异算成距离(Bray-Curtis 按丰度算、Jaccard 只看有无),再用排序图(PCoA)摆出来,两组样本在图上分开与否是组成差异的直观检验,配套用置换检验(PERMANOVA)给 p 值。
两条读图纪律:PCoA 图要标注两轴的解释率(常只有百分之十几——排序图只呈现差异的一部分,轴解释率低不代表组间无差异);PERMANOVA 显著只说明"分布有差异",差异来自位置(中心偏移)还是离散度(组内散布不同)要另行检验,否则会把"一组更散"误读成"组成不同"。
从组成到功能:宏基因组的深水区
物种组成只是宏基因组的第一层,深水区在功能与菌株级解析。功能层面:组装出物种的完整基因组(MAG,宏基因组组装基因组)后,可以回答"这个未培养物种拥有哪些代谢通路"——近年来一大批门级新物种的代谢能力(比如古菌的产甲烷路径变体)就是这样从环境样本里读出来的。基因层面:把全部样本的读长对齐到非冗余基因集,做基因丰度的组间比较与富集,把"哪些功能模块与疾病相关"变成可检验清单。
菌株级解析是难度上限:同一物种的不同菌株差异可以很大(毒力基因、耐药基因的有无),分辨它们需要高覆盖数据加专门的分相工具(strainphlan 一类)。临床相关的两个硬场景——粪便移植的供体筛选与耐药基因的传播追踪——都卡在菌株分辨这一级。宏基因组分析的能力天花板,正随着长读长(直接读穿重复区与耐药盒)与计算方法(宏基因组的分相组装)的进步快速上移,这个领域的方法学远未定型,紧跟工具演进是常态。
💡 关键直觉:微生物组数据是成分数据,"一部分涨"必然意味着"其他部分跌"。在这个前提下,任何关于"减少"的结论都要先过成分性这一关,否则就是归一化玩出来的幻觉。
群落看完了,下一站把尺度切到最细:同一个组织里的每个细胞,各自在说什么。