5.4 单细胞组学:把组织拆成细胞图谱
5.4 单细胞组学:把组织拆成细胞图谱
本节摘要:bulk 转录组测的是组织的平均值,单细胞测序把分辨率切到每个细胞。本节讲液滴法的原理、从原始数据到细胞图谱的标准流程(质控、降维、聚类、注释),以及数据稀疏性带来的特殊统计问题。
为什么平均值不够用
bulk RNA-seq 把一个组织的几万个细胞的表达量混成一条平均数。问题在于生物学常常住在差异里:肿瘤组织里免疫细胞浸润的比例变了,bulk 数据只能看到混合信号变了,分不清是癌细胞变了还是免疫细胞变了。单细胞测序把几千到上万个细胞分开测,让"哪种细胞在、各占多少、各自在表达什么"同时可读——细胞图谱(atlas)由此成为可能:人类细胞图谱计划的目标就是把人体所有细胞类型编目成册。
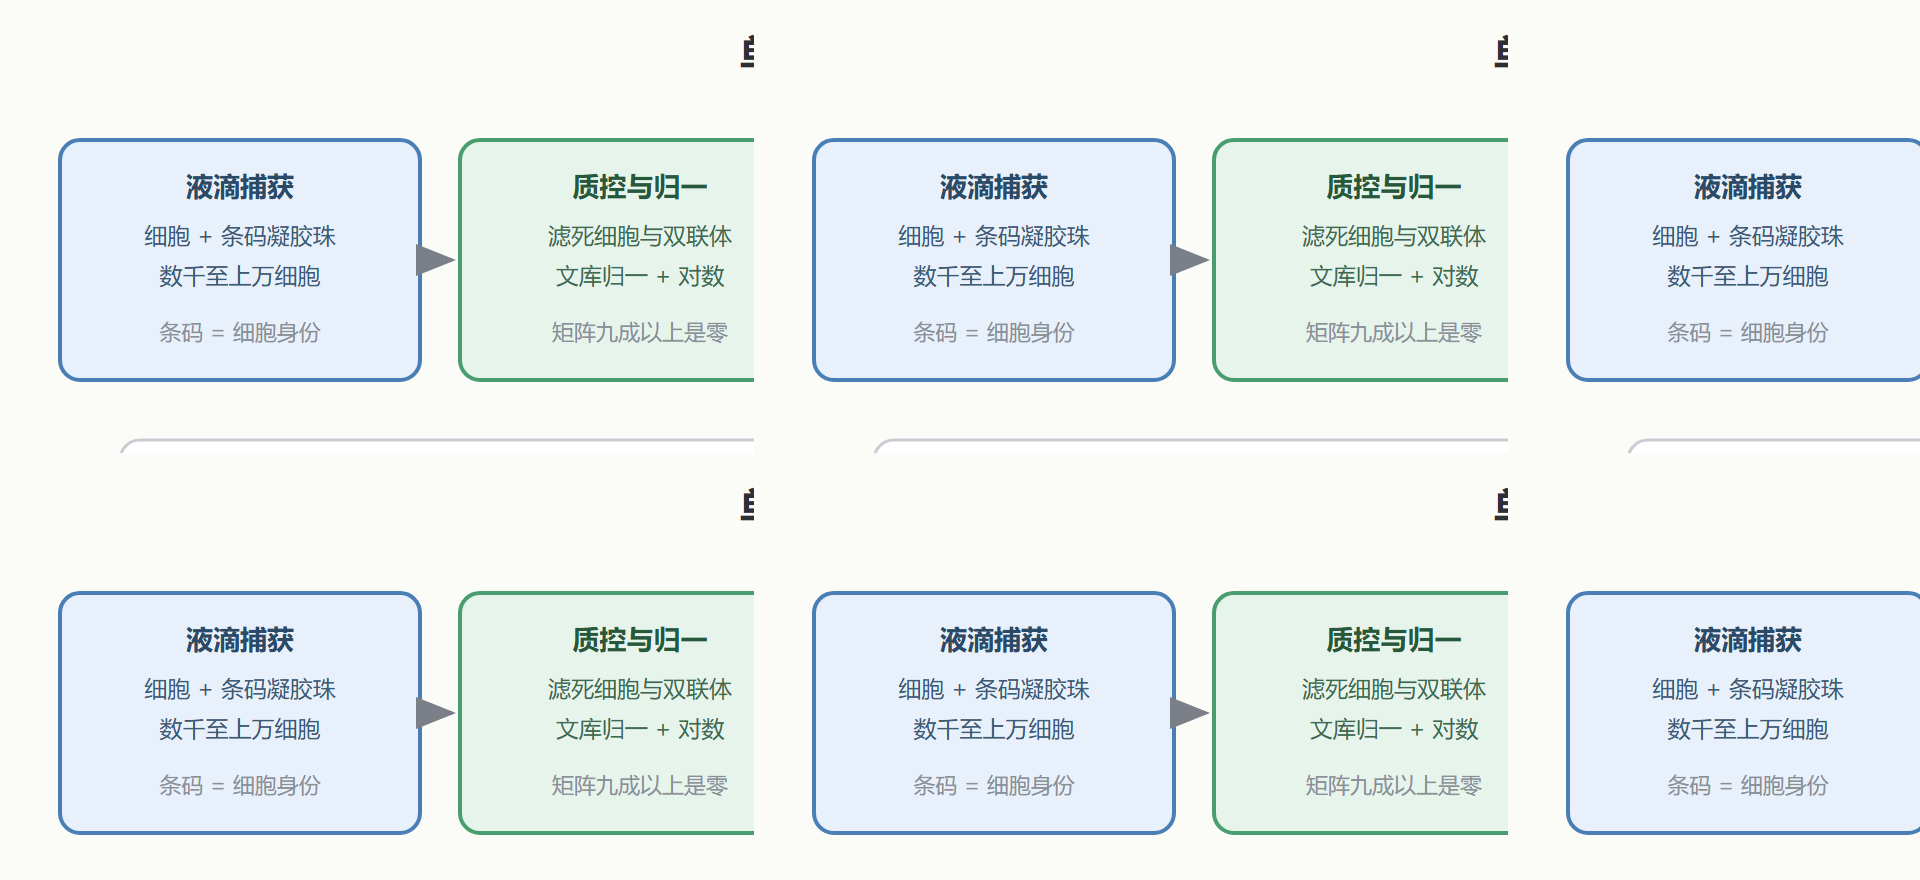
主流的液滴法(10x Genomics 为代表)这样工作:把细胞悬液与凝胶珠一起流过微流控通道,每个液滴捕获至多一个细胞和一颗带条码的凝胶珠;裂解后,每个细胞的 mRNA 被反转录并带上该液滴独有的条码——测序后按条码把读长分回细胞。每个细胞只测到几千条读长(深度远低于 bulk),换取的是同时观测上万个细胞。代价随之而来:深度浅加上基因表达的突发性(转录爆发),单细胞矩阵里九成以上格子是零——这些零绝大多数是"没测到"而不是"真不表达",这个简单事实决定了整个领域的统计方法学。
标准流程四步走
第一步质控与归一化:滤掉破损细胞(基因数过少)、双联体(一个液滴包了两个细胞,基因数与线粒体比例异常)、高线粒体比例的死细胞;counts 用文库大小归一后转对数,或用专门为稀疏数据设计的模型(如 sctransform 的负二项正则化)。第二步特征与降维:取变异最大的两三千个基因做 PCA,保留前几十个主成分。第三步聚类与可视化:在 PCA 空间里构建细胞近邻图,Louvain/Leiden 算法切出簇,UMAP 把图投影到二维——第五.3 节的成分性陷阱在这里换了个面目出现:单细胞的归一化与批次校正是同样不可跳的前置工序。第四步注释:每个簇是什么细胞类型,靠标志基因表达回验(T 细胞看 CD3D、浆细胞看 MZB1、上皮细胞看 EPCAM),自动注释工具(SingleR 等)用参考图谱打辅助,最终要人工复核。
# Scanpy 的标准流程骨架(数据:一个肿瘤组织的细胞矩阵) import scanpy as sc adata = sc.read_h5ad("tumor_sc.h5ad") sc.pp.filter_cells(adata, min_genes=200) # 滤破损细胞 sc.pp.filter_genes(adata, min_cells=3) sc.pp.normalize_total(adata, target_sum=1e4) # 文库归一 sc.pp.log1p(adata) # 对数化 sc.pp.highly_variable_genes(adata, n_top_genes=2000) sc.tl.pca(adata, n_comps=30) sc.pp.neighbors(adata, n_neighbors=15) sc.tl.leiden(adata, resolution=1.0) # 聚类 sc.tl.umap(adata) sc.pl.umap(adata, color=["leiden", "CD3D", "EPCAM"]) # 下一步:按标志基因给每个 leiden 簇起生物学名字
图:从组织到细胞图谱的流程与 UMAP 读法
稀疏数据的统计纪律
单细胞数据的方法学几乎都是围绕稀疏性展开的。差异表达不能直接抄 bulk 的检验:每个细胞是一个样本会造成"伪重复"(同一供者的细胞不独立),规范做法是按供者聚合做拟bulk检验,或用显式建模零膨胀的工具。簇的分辨率是主观参数——resolution 调高簇就多,"发现了新细胞类型"的声明要先排除分辨率伪影:稳定地在多个分辨率、多种降维方法下独立成簇,才算站住。批次效应在单细胞里比 bulk 更凶(每个细胞是独立捕获),多供者整合必须校正(Harmony、scVI),但校正力度过大又会把真实的生物学差异抹平——整合之后用对照标志基因复查是纪律。
成本与样本设计的账也要会算:单细胞项目的预算瓶颈常在试剂与测序量,几十个样本的队列设计里,"每个条件多供者、每个供者少深度"通常优于"少供者、深测"——供者间的生物学方差才是推断的根基,与 4.4 节"生物学重复不可替代"的原则同源。
拟 bulk 与细胞组成:连接两个尺度
单细胞与 bulk 的衔接分析有两类,各自回答不同问题。拟 bulk(pseudobulk):把同一供者同一细胞类型的所有细胞计数加总,还原成"细胞类型级的 bulk 矩阵",再用 2.6 节的 DESeq2 做差异检验——这是单细胞差异分析的稳健正解,因为它绕开了把单个细胞当独立样本的伪重复陷阱。细胞组成分析:bulk 数据其实是各细胞类型信号的加权混合,反卷积方法(CIBERSORT 一类)用单细胞图谱当参考,从 bulk 矩阵反推各细胞类型的占比——肿瘤样本的免疫浸润评估就是这么做的。
两类分析合起来给了一个重要的视角转换:bulk 差异分析里"表达变了",在单细胞分辨率下可能拆解成"比例变了"(某类细胞增多)与"状态变了"(同类细胞表达改变)两种来源,两者的生物学解释完全不同。把 bulk 结论先按组成与状态分解,再下机制判断,是单细胞时代做差异解读的基本素养。
轨迹与速率:给图谱加上时间维
细胞图谱是快照,但很多问题问的是过程——分化怎么走、细胞状态怎么转变。轨迹推断(pseudotime)把快照里的细胞按表达相似性排成一条"伪时间轴",假设过渡态细胞同时携带起点与终点的部分特征;RNA 速率(RNA velocity)更进一步,利用剪接与未剪接转录本的比值直接推断每个细胞表达变化的瞬时方向,把快照外推成矢量场。两类方法在发育与肿瘤分化研究里产出过漂亮的结论(某些耐药亚群被速率场指认为从敏感态流出的下游)。
使用它们要带着同样的怀疑精神:伪时间轴是"相似性的排序"不是真实时间,方向可能因采样不全而反转;速率场对建库方法(对未剪接读长的捕获效率)敏感。规范的做法是把轨迹结论与已知的时间梯度样本(处理时间序列、发育阶段标记)交叉验证,矢量只在被独立证据支持的区段上解读。
💡 关键直觉:单细胞数据的零是"没测到"而非"不表达",一切方法(归一化、差异检验、整合)都在为这个事实打补丁。理解了这一点,各种工具的选择逻辑就不再是玄学。
单细胞把维度切细,最后一站把维度合起来:多组学整合与系统生物学的收官。