4.1 芯片设计的三条记账原则
4.1 芯片设计的三条记账原则
本节摘要:本节立起神经形态硬件设计的骨架——存算一体、事件驱动、异步大规模并行,并逐一讲清各自的省账动作与代价。读完你能用这三条验算表,去判断任何芯片是不是"真神经形态"。
上一章你在数学层画好账,这一章第一脚先不急着看具体电路,而是把硬件设计的"宪法"讲清。第 4 章的每一节(存储器内计算、非易失器件、模拟电路、代表芯片)都是在三条原则指导下开花的。读它前最好闭上眼睛回测第 2 章那三笔账的直觉,因为这三条原则就是神经元记账方式在硅上的物理回声。
一、三条原则是什么
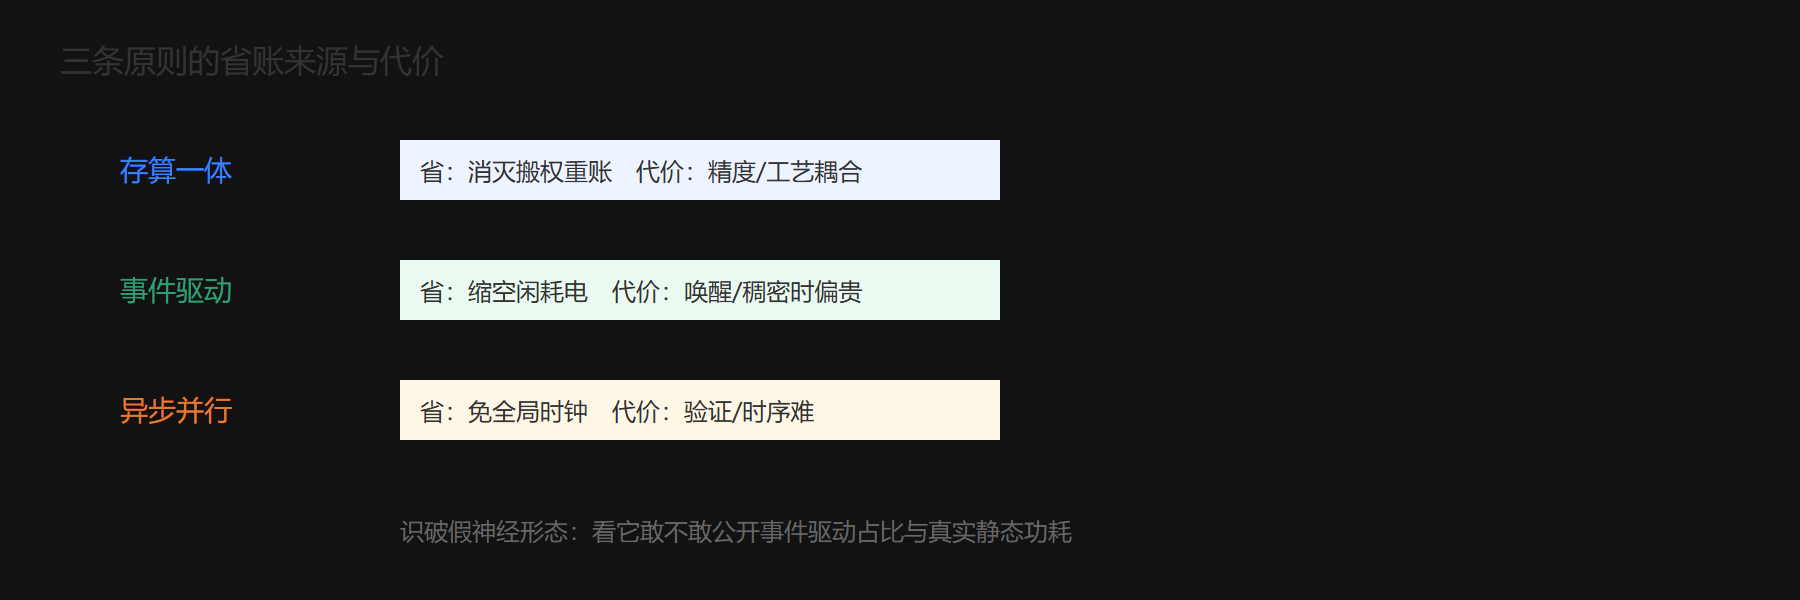
①存算一体(In-Memory Computing):不再"先搬权重再算",而是让算发生在权重所在的位置。第 1 章讲的"搬运烧能",这一条把搬走动省掉。代价是:存储与计算耦合,工艺、可靠性、精度都得重新设计,不是免费的。
②事件驱动(Event-Driven):神经元不放脉冲就不耗电——软件层视作"无事可做",硬件层就是真实关闭相关电路、节约静态功耗。代价:一旦来脉冲,唤醒与路由的系统开销要被摊得很精,否则小的省被大的系统成本吃掉。
③异步大规模并行(Asynchronous Massive Parallelism):不靠一个全局时钟同步,而是各神经核独立、用"事件"驱动互相协调。好处是省下全局时钟的能耗、且天然容错(一个核忙,别的照常)。代价:异步时序难测、难调试、设计复杂。
二、三条原则怎么互相咬合
把三条原则拼起来看,它们不是三个并列的技巧,而是互相补位的一条流水:
事件驱动保证"平时钱不烧",存算一体保证"一烧就烧在刀刃上",异步并行保证"所有刀刃能同时开工、互不拖累"。三者合成一章开头说的那把省账的总路线。
三、往代价那边也看一眼
原则是理想,落地处处要付款:
- 存算一体的高精度乘法(浮点)塞不进常态存储,只能折成低精度甚至离散;
- 事件驱动在尖峰稀疏时才划算,数据一旦稠密(如普通图片全量输入),唤醒成本反而比连续处理还贵;
- 异步设计让工具链与验证痛苦,量产时序收敛难。
这就是为什么你会发现——市面上所谓神经形态芯片,其实大多是"纽结削弱"地在这三条原则里做减法:有的优先存算一体,有的优先事件驱动,都保留了能接受的代价。识破一个"假神经形态"的方法很简单:看它敢不敢公开自己的事件驱动占比与所有者静态功耗。
把三笔"省电来源"与三笔"代价"摆成一张四象限,你一眼能看出每一项都同时带着收益与欠账:
四、三句话把原则挂在嘴上
⚠️ 常见坑:别把三条原则当成"必须全都做到才叫神经形态"。真实产品是"按应用挑其中一两条做到位"。TrueNorth 把事件驱动与数字确定性做到极致,Loihi 把片上学习与异步做到极致,各有偏科。
💡 关键直觉:把三条原则想成医院的三张省钱处方——事件驱动是"没病人就关灯",存算一体是"药房挨着病房",异步并行是"每个病房独立打表"。智慧不在某一招,而在给一家医院配齐三张处方。
五、怎么拿三条原则验一台真芯片
三条原则不只是读书框架,是你对芯片做尽职调查的清单。拿到一款号称神经形态的芯片,别急着信发布会,按下面顺序走一遍:
第一步:看它是否为事件驱动而设计。 翻开数据手册,找"事件/异步/稀疏调度"这类字眼,而不只看"低功耗 AI"。如果它核心仍是一个按固定帧率跑的死循环,那事件驱动占比就成问题。
第二步:问存算一体的成色。 权重是存在计算核内还是外挂内存?看存储带宽与计算单元的物理距离。真存算一体会让"读权重"和"乘加"在同一物理位置发生;若它靠庞大的片上 SRAM 搬运,那只是"把存储做近了",离存算一体还有一截。
第三步:要三张表。 负责任的厂商能给:峰值与满负荷的有功功耗、不同稀疏率下的实测功耗、以及"静态/空闲功耗"这一行。只肯给峰值 FLOPS/TOPS 的,多半在拿传统加速器的话术包装。
第四步:对账基准。 看它发布的评测是"稀疏、实时、低功耗"类任务,还是跨稠密大模型。用第 1 章那把尺子问:这评测里的任务真的稀疏吗?真的实时吗?是否在拿小数据集掩盖精度妥协?
这四步走完,大多数"挂羊头"的芯片会现形:要么缺事件驱动的真核,要么不肯公布静态功耗,要么拿普通加速的跑分充数。反过来说,靠这三条原则真正设计的芯片——TrueNorth 死磕事件驱动加数字确定性、Loihi 死磕异步与片上学习——是经得起这张验沙发的。这样一个一个验下来,你会发现"验真里"其实是在替生物那笔"只在必要处花能量"的账做尽职调查:芯片敢不敢把"平时烧多少、空转烧多少"摊开,最能说明它是不是真按三条原则在造,还是在拿一个常规芯片贴一张神经形态的标签。
再补一句关于"三条原则会不会互相打架"的提醒。 你会看到教材把三者讲得井水不犯河水,但真实芯片里它们往往互有拉扯:极端事件驱动(几乎总在休眠)会和"总在线的存算引擎"抢功耗预算;全异步并行又会让"要精确时间窗"的编码方案难落地。所以一款成熟芯片常常不是"三条全做满",而是在三条原则围成的三角形里选一个具体的工作点——先定任务(实时还是离线、稀疏还是稠密),再决定把哪条原则做深、哪条让位给代价。这个"从任务反推工作点"的思路,是你在第 4.5 节读懂各大芯片为何如此不同的钥匙:它们不是设计得差,而是为不同的总账选了不同的落点。
六、拿一张规格表走一遍"验真"
前面讲的是原则,这里把它落到一张真的产品规格上,你就能掌握"动手验",而不只是"听着像"。随便挑一款号称神经形态的芯片,把它的数据手册按下面五栏打勾:
- 事件驱动栏:它提到"事件/异步/稀疏调度"了吗?还是一整页都在讲"TOPS 峰值、低功耗 AI"这类通用词?前者是自证,后者是疑似贴牌。
- 存算一体栏:权重明确说"存储在计算核内/靠近计算单元"吗?还是依赖一大块片外或片上 SRAM 搬运?物理上"算与存在一处"是硬指标。
- 功耗透明栏:它给"静态/空闲功耗、不同稀疏率功耗"这种分项表,还是只甩一个峰值 FLOPS?负责任的神经形态厂商会主动摊开这一行。
- 基准任务栏:评测跑的是"稀疏、实时、低功耗"类任务(唤醒、事件流),还是拿普通稠密大模型跑分?后者多半在拿传统加速器话术借鸡下蛋。
- 可编程栏:能不能自定义神经元模型、学习规则、路由?还是只能搬预设模板?决定它能否当"通用神经形态"用,还是只是颗专用加速器。
五栏打勾走完,一颗芯片是不是"真按三条原则造",成色一目了然。这套手法的价值在于:你不需要认识每个电路名,只要死盯"省账来源是否摊在明处、代价是否肯公开"这两句话,就已经比多数只会背书名的读者更能识破挂着神经形态招牌的常规硅片。真正的好芯片不怕你查,敢把"平时烧多少、空转烧多少"的底裤翻出来的,才当得起"按原则设计"四个字。
本节要点回顾
- 存算一体灭搬运、事件驱动灭空耗、异步并行灭时钟开销。
- 三者咬合成总路线:平时不烧、烧在刀刃、刀刃齐开。
- 代价:存算→精度退化,事件→稠密差,异步→验证难。
- 识破假货:看事件驱动占比与静态功耗是否愿意公开。