4.2 存储器内计算与交叉开关阵列
4.2 存储器内计算与交叉开关阵列
本节摘要:本节讲"把权重压进计算格"的硬件——存储器内计算的动机、交叉开关阵列怎么让一次乘加在一个交叠节点就地完成,以及它的能力边界。读完你能画出一个最小的交叉开关做一次矩阵向量乘。
这是全册"硬件省账"的明星招式。第 4.1 节立了存算一体的原则,本节给它的具体身形——交叉开关阵列。你要算的是"权重矩阵 × 输入向量",传统要搬权重到寄存器再算,这里干脆让权重直接躺在每根横纵线的交叠点上,一次过电就出结果。读它前最好懂向量-矩阵乘(第 3 章 SNN 的累积就是干这个),读懂后你会明白第 4 章这么多芯片为它兴师动众的原因。
一、动机:把"搬运"从账单上删掉
一次"加权求和"(SNN 里每个神经元都在做)本质是向量点积:把输入乘上对应权重再累加。传统做法要先把权重从内存搬到计算单元,算完再写回——前面讲过的"搬运"在这一步反复发生。存储器内计算反着来:权重值本身就是存储器的状态(如一个电阻的电导),输入电流一带,欧姆定律就地产出"权重乘输入"的积,再沿竖线电流累加就是"求和"。 一次乘加,物理上就发生在存储那个交叠点,全程不搬权重。
二、交叉开关怎么算一次乘加
下图是一个 4×4 的迷你交叉开关:每根横线(字线)送一个输入电压,每根竖线(位线)收集一个输出电流。交点处是"权重存储单元"——其电导值就是权重 w。输入 v_i 流经权重单元,产生电流 v_i * w_ij,在同一根竖线上按基尔霍夫电流定律相加,就是该输出神经元本次的累积输入。
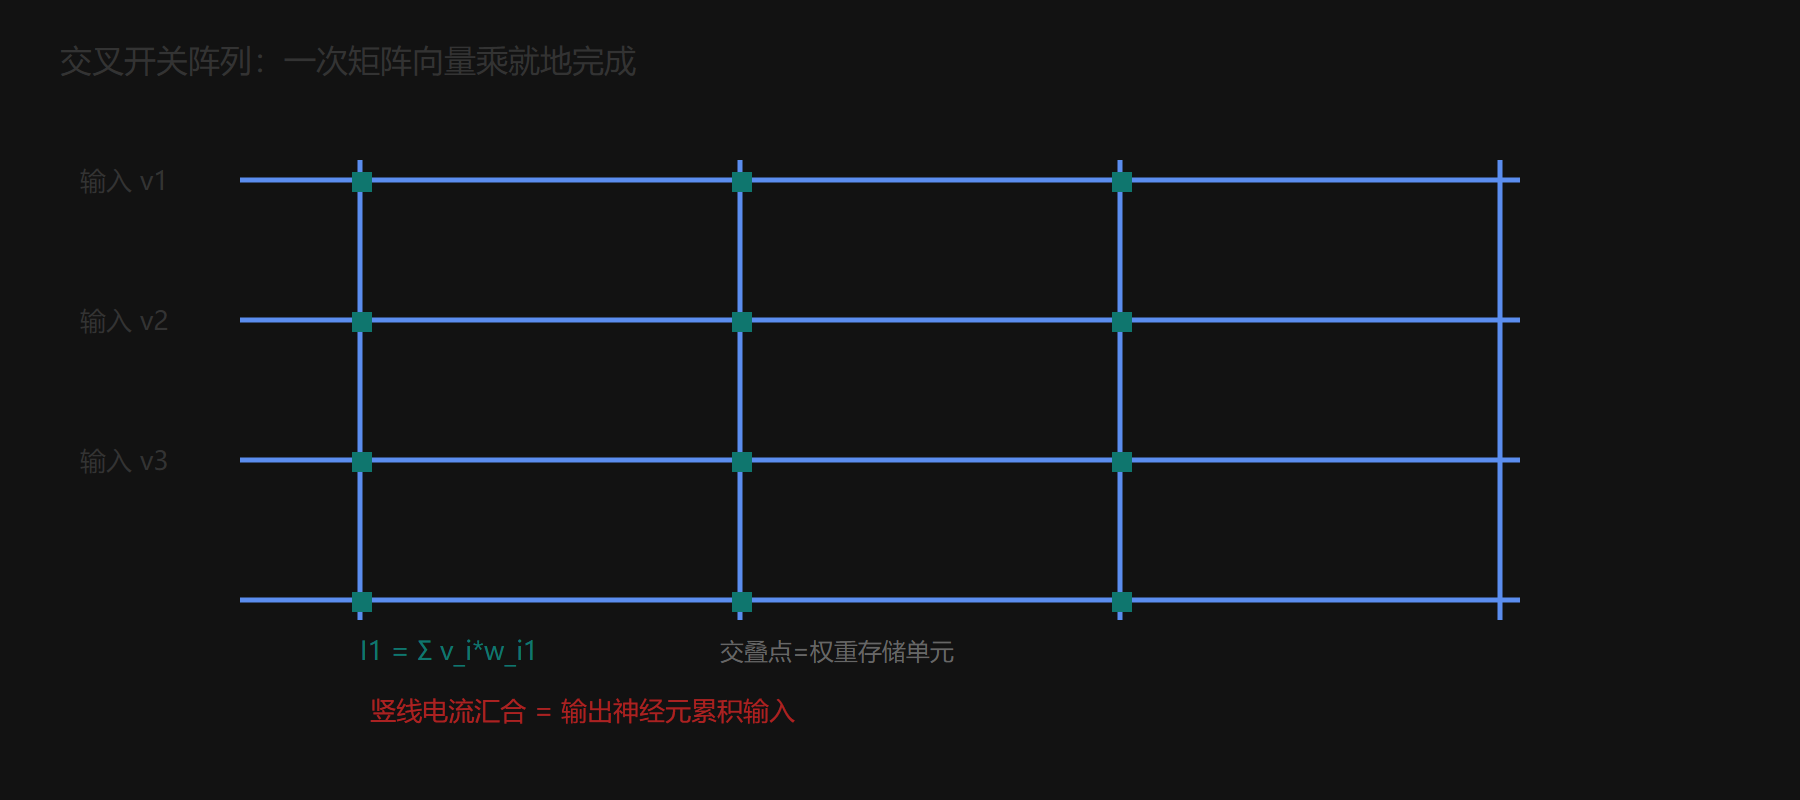
一件事:这就是 SNN 里那个神经元"累积输入脉冲"的硬件化身。 你不再需要"先把权重搬来再逐项乘",交叉开关把"乘 + 加"压缩进一次过电——旧账(搬运)从账单上被撕掉。
三、为什么这招这么香,又这么难
香的账:矩阵向量乘一次并行完成 O(N) 次输出,吞吐高,且能量高度集中在真实计算上,对训练/推理稀疏场景收益巨大。难在好几处:
- 权重存在"电阻/电导"等模拟值里,模拟乘加的精度受器件漂移与噪声限制,只能做到低精度(常是 4-8 bit),高精度任务吃亏;
- 交叉开关的多条竖线电流互相串扰(IR drop),规模一大幅射又差;
- 器件本身的"改写寿命"有限(见下节非易失器件)。
这三条难点正好解释了一个现象:为什么存算一体在"推理"(权重烧死、只读不改)上比在"训练"(要反复改写权重,精读精写)上成熟得多。推理时器件只需被动提供稳定的电导值,工程上容错空间大;训练则要求同一批器件经受大量改写还能保持精度,这对器件一致性、寿命和写入算法都提出高得多的要求——所以你会发现多数存算芯片先主打推理,训练是更远的攻坚目标。读这节时记住"推理易、训练难"这个分化,你对接后续部署和器件章节时会更有预判。
四、和普通存储账放在一起
| 方案 | 乘加怎么发生 | 搬运成本 | 精度 |
|---|---|---|---|
| 冯诺依曼+普通存储 | 先搬权重再算 | 高 | 高(浮点) |
| 交叉开关阵列 | 权重电导原位乘加 | 极低 | 中低(4-8 bit) |
| 数字神经形态核心 | SRAM 存权重,近存算 | 中 | 中高 |
⚠️ 注意一个惯用伎俩:有的宣传把"交叉开关"和"成品芯片"混为一谈。交叉开关是"计算引擎的一种",还差控制、路由、学习、输入输出交付才成芯片。看宣传时要分清它说的是"引擎"还是"整机"。
💡 关键直觉:交叉开关是把"乘法表"刻在电路电阻里。你在训练时算好的权重,最终就是烧录成这些电阻/电导值——读取、改写、漂移,全都在这张表上。
五、用手笔算一遍 2×2 交叉开关
别让"交叉开关"停在抽象名词上,拿最小的 2×2 走一遍你就有手感。设输入向量是 (v1=2, v2=3),两根横线各送一个电压;权重矩阵写进四个交点,比如 w11=0.5、w12=1、w21=−0.2、w22=0.8。现在沿左起竖线看:v1 流过 w11 产生 2×0.5=1,v2 流过 w21 产生 3×(−0.2)=−0.6,两者在同一根竖线上按电流定律相加,得到该输出神经元本次累积输入 = 0.4。再看右一路竖线:v1×w12=2×1=2,v2×w22=3×0.8=2.4,相加得 4.4。于是这次"输入 × 2×2 权重矩阵"的向量乘,在两根竖线上**同时**产出两个结果,整个过程没有把任何一个权重搬去别处——乘积由元件本性的欧姆定律就地给出。
把这个例子放大到神经网络的真实尺度,逻辑完全一样:一个全连接层有 N 个输入、M 个输出,就对应一个 N×M 的交叉开关——N 根横线送输入,M 根竖线收输出,M 个神经元的累积输入在同一次过电里集体算完。所以交叉开关的威力不只是"省一笔搬运",更是把一整个矩阵乘法压成单次批量过电,吞吐高得惊人。这也解释了为什么部署神经形态时,最常优化的就是"怎么把一个训练好的网络,按行列映射成若干块交叉开关"——映射得好,一次过电能算大半个网络;映射得差,就得多次切分、反复过电,省账就打折扣。
再点一句你能带走的判读:下次看到某款存算芯片的概要,先看它"一根交叉开关做多大块、多少 bit 精度、用什么器件当交点权重"。三个数字一报,你立刻能估它单次过电能并行的规模、能接受的精度、以及耐久性如何——这比一味的"亿级神经形态"商标可靠得多。
但交叉开关只做完了"累积"半步。 别忘了第 3.1 节那个 LIF 神经元完整的流水是"累积—越阈—放电—复位"。交叉开关高效完成了"累积"(把输入加权求和算出),可它本身并不负责后面"判阈、放电、复位、向下一层发尖峰"这几步——那些由交叉开关竖线出口外挂的"外围神经元电路"(比较器、法理模块、事件打包)来完成。于是你会看到真实芯片里,存算阵列是被一圈"外围电路"包围的:阵列负责海量乘加,外周负责把每次累积结果判越阈、决定要不要发尖峰、再把尖峰路由给下一层对应的横线。理解这个"阵列管算、外挂管神经时序"的分工,你就明白了为什么交叉开关必须和下一节要讲的控制、路由、学习一起谈——它只是神经形态引擎的心脏,不是整台机器。
存算账结清
- 存算一体=搬账离开账单:权重存在交点,乘加就地完成。
- 交叉开关=横输入纵输出:电压×电导、同行电流加总得输出累积。
- 质优三问:吞吐高、能量集中、适配稀疏;精度受器件限制。
- 交叉开关≠整芯片:还缺控制、路由、学习与交付。