4.5 代表芯片:TrueNorth Loihi 天机 Akida
4.5 代表芯片:TrueNorth / Loihi / 天机 / Akida
本节摘要:本节把前几节的账本印到真芯片上,用一张对比表对照 TrueNorth、Loihi、天机芯、Akida、SpiNNaker 的神经元数、尖峰能耗、片上学习与能效。读完你能说清"哪颗芯片替哪类任务省了账"。
前面四节你掌握了硬件设计的零件与原则,本节做一次总检验——把这几张零件拼成真实跑分的芯片,对着账本查。读它前最好把第 4.1 节三条原则和第 3.2 节 LIF 熟记,因为下面每颗芯片都是一个"按应用场景挑了哪条原则、愿意付出什么代价"的活例子。
一、四颗芯片的账本速写
IBM TrueNorth(2014):数字路线,超低功耗的里程碑。4096 个神经核、每核 256 个神经元,共 100 万神经元、2.56 亿突触,28nm 工艺、整片约 70 mW 功耗──比手电筒还省。它的设计哲学是"确定性 + 事件驱动":数字电路保证结果可复现,常规推理能力整便装进嵌入式场景。代价:不倾向于片上学习,编程要专门语言,神经元只做很浅的功能。
Intel Loihi(2018):异步尖峰 + 片上学习。128 神经核、每核 1024 神经元,约 13 万神经元、1.3 亿突触,LIF 基神经元,把 STDP 和各种常规学习规则放进芯片指令里──这是它的招牌:不用把权重拉出去,在片内"改账"即可。适合自适应、机器人学习。
天机芯(Tianjic,清华,2019):混合 ANN+SNN 的军用级样板。把连续值网络(S-CNN)和脉冲网络放在同一颗芯片一起跑,约 4 万核心、10 万余神经元、千万级突触,支持两类网络灵活切换。2019 Nature 封面放在自动驾驶示意的无监督学习场景里演了一出让两类网络并肩协作的戏。它的价值在"打通两种账本之间的墙"。
BrainChip Akida(商用):事件驱动、面向边缘量产。主打 low power、数据只在变化时入账,宣称"十亿级突触运算每秒每瓦"量级的能效目标,直接卖给物联网摄像头与边缘推理。它是"神经形态能不能商用"这门课的尖子生,但容量比前几颗原型小。
二、摆到一张对比账
| 芯片 | 神经元规模 | 突触 | 片上学习 | 路数/重点 | 代表 |
|---|---|---|---|---|---|
| TrueNorth | 百万级 | 2.56 亿 | 弱 | 数字事件驱动、极省电 | 嵌入式推理 |
| Loihi | 十余万 | 1.3 亿 | 有(STDP等) | 异步 + 片上学习 | 自适应/机器人 |
| 天机芯 | 十万余 | 千万级 | 中 | ANN+SNN 混合 | 两类网络并存 |
| Akida | 百万量级目标 | — | 事件驱动 | 商用内生 | 边缘推理量产 |
| SpiNNaker | 百万核 | — | 软件层 | 通用大规模模拟 | 神经科学仿真 |
三、把规模与能效画成一张柱状账
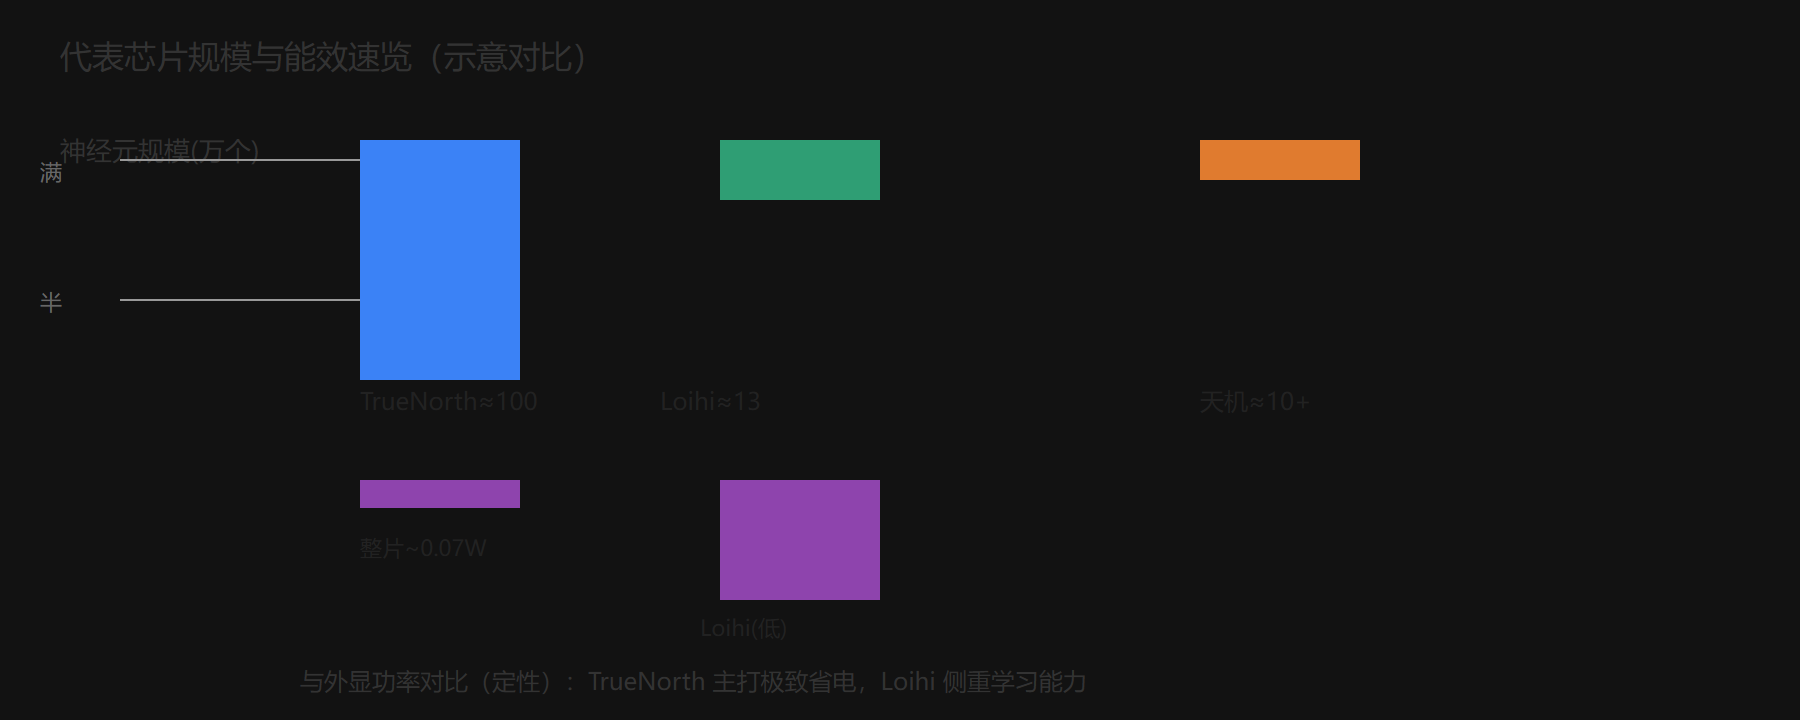
这张图的真实含义不是"谁数字大",而是指标取舍:TrueNorth 用百万神经元却压到零点零几瓦,靠的是数字确定+低静态功耗;Loihi 牺牲规模换来片上学习;天机芯要的是"两类账本并存";Akida 要的是"能卖"。选芯片 = 先想你的任务要哪笔账。
四、用账本视角读芯片
读 datasheet 时,别只看 "多少神经元""多少 TOPS",多看重三列:单次尖峰能耗(每一笔尖峰几个皮焦坡,越省越适合大规模)、静态功耗/事件驱动占比(闲置时烧多少电)、片上学习能力(要不要外部搬权重)。对低功耗边缘任务,"静态功耗 vs 计算功耗"的比例往往比峰值 FLOPS 更能决定这单生意成不成。
再补一句关于这些数字通常会怎么"被包装"。 神经形态芯片的白皮书爱堆"神经元数""能效优于 GPU 若干倍",但这些数字往往来自不同的口径:有的按稀疏、低精度、固定任务测,有的干脆只给理论手算上限。所以比起空口放大,你更该做一件小事——把它的功耗除以它真实跑的并行规模,估一下"单次尖峰折合多少钱",再拿那个单位数去和其他芯片比。单位成本一旦对齐,很多"领先 N 倍"的营销话术就自动缩水成"其实差不多"。这张用一个除法就够用的防忽悠账,是本节想留给你比任何型号清单都管用的工具。
⚠️ 常见坑:用 GPU 的 "每秒浮点次数"去脑神经形态芯片的 "神经形态 inference"。两者计算语义不同、能量账不同口径,硬比会得出荒谬结论(比如"我 GPU 跑得比它'快'")。要比就比"同一任务、同一精度、一手交能一手交货"。
💡 关键直觉:神经形态芯片的基本粒一贯在"单次尖峰多少钱 + 静态成本重不重",而不是"快不快"。记住这句话,你读任何神经形态芯片的规格都不吃亏。
五、给一台具体设备挑一颗芯
把上面四颗芯片落进真实场景,你才发现选型的逻辑彻底不一样。一台永远挂机的门锁,要毫瓦级待机、只在有事件时分辨——TrueNorth 那套"极低静态功耗 + 事件驱动"正中靶心,尽管它的神经元功能浅、编程难也没关系,因为锁上只跑一种固定检测。一台需要边用边学的机器人,环境在变、不能回机房改权重——Loihi 的片上学习是刚需,哪怕规模小、牺牲点猛,也值得。一台要在车上看两类网络协同的研究样车——天机芯的混合能力是独一份,代价是它更像科研样板而非货架产品。一台要量产贴进摄像头卖掉的商用件——成本、稳定性、生态压倒一切,Akida 那条"事件驱动 + 商用封装"的路才走得通。
看得出规律了吗?没有"最好的一颗芯片",只有"最贴我这个设备工作负载的一颗"。 选型第一问永远是"这设备断电多不多、任务靠不靠时序、要不要在线改权重、预算是能耗还是出货量",把这四个答案对上表里的四列,芯片自己就挑出来了。很多团队翻车,不是纸面参数不够,而是拿"规模最大的那颗"硬塞进一个"只要毫瓦待机"的位置——账本不对,跑分再高也没用。
芯片账的收结
- TrueNorth:百万神经元、整片 ~70mW,数字事件驱动,嵌入式。
- Loihi:片上 STDP/学习,异步,适合自适应与机器人。
- 天机芯:ANN+SNN 混合,打破两类账本的墙。
- Akida:商用级边缘量产,事件驱动低功耗。
- 选型看三相:单 spike 能耗、静态功耗占比、片上学习。