5.1 把账本变成代码:编程模型与抽象
5.1 把账本变成代码:编程模型与抽象
本节摘要:本节讲神经形态软件的抽象层级——从硬件原语到高层 API 各层吞掉什么复杂度、付出什么代价。读完你能画出抽象层级,并用"抽象到哪一层"去评判一个框架省不省账。
前面四章里,神经元、突触、时间步是硬邦邦的物理与数学;到了软件,我们要问怎么把它们变成你顺手能写的代码。这一节在知识地图上开软件章的头,给后面 5.2(仿真)与 5.3(部署)定好"抽象"这把尺子。读它前最好知道一件事:神经形态硬件没有通用 CPU 那套"加载-存储-指令",网络只能用"累积-放电-事件"的窄语言表白——这决定了它软件栈要另起炉灶。
一、抽象层级:把硬骨头逐层藏起来
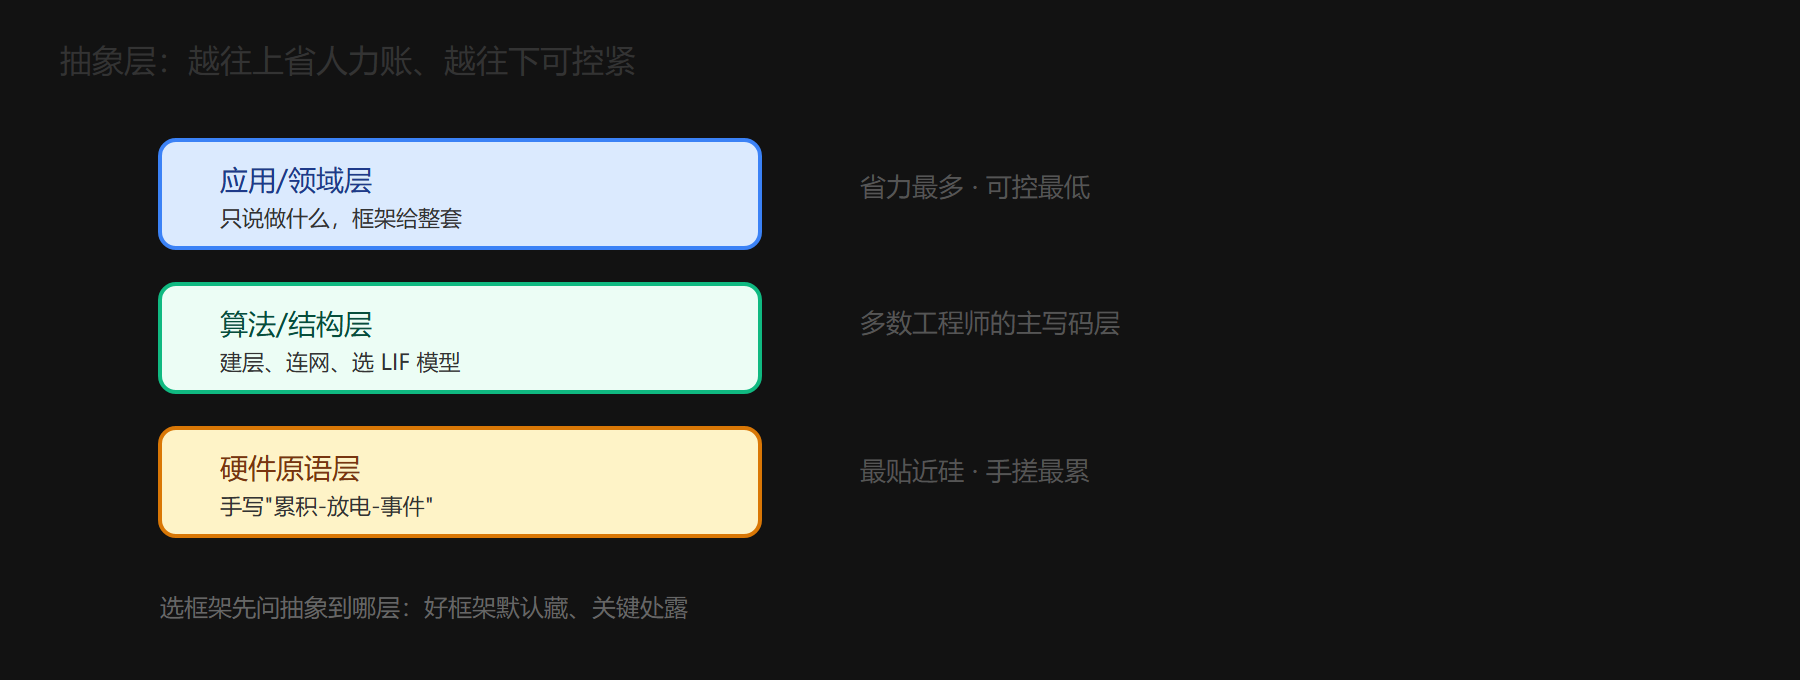
神经形态软件从底到顶,大致分三层,每层都在替上一层吞掉一部分复杂度:
①硬件原语层:直接面对芯片寄存器的"累积-放电-事件"指令,以及神经元的参数(膜时间常数、阈值、学习规则开关)。这一层什么都可控,但写任何一个模型都要和硬件细节搏斗,是"手搓账本"级待遇。
②算法/结构层:把神经元模型、突触连接、网络拓扑抽象成概念积木——你只说"建一个 18 神经元的层、全连接、LIF",它在背后生成一堆硬件原语。这一层是绝大多数工程师真正写代码的地方。
③应用/领域层:连 SNN 都不必懂,只描述"识别猫"或"跟踪手势",框架自动选点模型、编码、解码等整套账。省事至极,但灵活度低、黑盒,遇上你不理解的性能问题没法调。
层级拉得越高,"程序员省多少账"越明显,但"可调可控的账"越暗。这就是抽象的老故事,在神经形态这里更痛——因为它和通用编程范式差得太远,连"把权重存进去"都得翻译成它认得的语言。
二、不同抽象层的适用账
| 抽象层向下看 | 你控制的账 | 你要付的账 | 适用 |
|---|---|---|---|
| 硬件原语 | 一切 | 一切明细 | 极特殊、性能为王 |
| 算法结构层 | 模型与拓扑 | 硬件细节 | 大多数学者/工程师 |
| 应用层 | 用不用得上 | 性能黑盒 | 接近产品化的用法 |
三、神经形态为什么特别依赖抽象
归根到底,神经形态的"难用"不是工具少,而是它的计算原语和通用范式根本不同。通用深度学习中"一个张量在内存里,一次乘加更新"的心智模型,在事件驱动的尖峰硬件上并不自然成立——那里到处都是"谁,什么时候,发了什么脉冲"。于是设计者做不到"把 PyTorch 原样搬来",只能在三层抽象里造一层"把脉冲编成更像张量的假象"。第 5.3 节讲的具体部署映射,本质就是在这一层假象和真硬件之间搭桥。
用一句大白话把"另起炉灶"说清:你让一个通用程序员去写"这段尖峰该在什么时候发给哪个核",他得先弄懂膜电位、阈值、路由表这一整套——这在传统编程里根本不是他要想的事。所以神经形态软件栈在做的,其实是把"神经元思维"翻译成"程序员思维"的翻译层。衡量一个栈好不好用,技术指标反而不是关键,关键看它把多少"神经元思维"替你译掉了、又留了多少给你做关键决策。这正是后面 5.2 讲平台、5.3 讲部署时反复要拿抽象尺子来量每套工具成色的原因——工具好不好,先看它在哪一层、能往下钻多深。
四、实践的直觉
⚠️ 选框架别只看"支不支持 SNN"。要问它抽象在哪一层:是帮你免了硬件原语的手搓,还是连模型结构都替你定死?抽象缺层,等你写了一半发现不再能调神经元的漏电参数,回头成本巨大。
💡 关键直觉:抽象层级就是"把硬骨头藏多深"的刻度尺。藏得深你省力,但藏到你双眼一抹黑就该拉回来。好的神经形态框架是"默认藏、关键处露"——让你在要精度时能伸手到硬件原语。
五、把三层画成一张梯子
先给你一张抽象层的纵向剖面图,把"省人力账"和"可控紧"这对矛盾摊在同一张图上:
六、一层抽象到底省多少账
"抽象藏复杂度"听着像套话,落到神经形态却有可衡量的分量。作对比:在算法结构层写一个 LIF 网络,你只需要声明"多少层、全连接、用 LIF、输入怎么编码",剩下的是框架一批批生成"累积-放电-事件"的原语;若退到硬件原语层,同样的网络,你要自己手写每个时间步的膜电位更新、阈值判断、放电复位、以及核与核之间的脉冲路由。同一个模型,两端工作量能差出几个数量级的"学时账"——这也解释了为什么神经形态生态"好用"的框架值钱到能单独成产品。
但高度的有偿,它的代价没有逃出经典规律:复用度越高,表达力就越受限。应用层的框架把你锁进它预设的模型集合里,你想要的自定义神经元、自定义学习规则,往往得往下钻到算法层甚至原语层手写。于是"选抽象层"真正要做的一笔账是:你 80% 的日常复用在哪里,那 20% 需要把控制权拿出来下钻的特例,代价你能不能接。
一个实操提醒:好框架从来不是"全藏",而是"默认藏、关键处露"。理想的神经形态框架允许你从上往下按需下钻——平时写高层积木,真要调漏电参数或路由时能一路戳到底层。选型时与其看它"支持不支持 SNN",不如看它"下钻的缝留得够不够宽"。
顺带把这条和本册主线对上:所谓"关键处露",本质就是"把省人力账交给框架,把决定功能成败的那几笔账握在自己手里"——它和第 4 章"模拟做累加大货、数字守精确底线"是同一个分账哲学在不同层的重演。你在任何软件栈里感到"名不副实",多半就是它把缝缝死了,逼你为一次小改动付出整套重写成本。
七、同一个模型,三种写法长什么样
抽象不是嘴上说说,落到"同一句话怎么写"差别立现。以"造一个 3 层全连接、LIF"为例,三种抽象层的大白话是三种画风:
- 硬件原语层:你得手写"第 0 层每个神经元的状态机、每个时间步更新膜电位、判阈、放电、复位,再把尖峰路由到下一层的指定核、按权重累加"。一行行全是电路细节,写一个 LIF 层无异于写一个迷你驱动。
- 算法结构层:你只需要说"Layer(3, 'full', 'LIF'),输入按速率编码",剩下的网络怎么展开、原语怎么生成,统统交给框架。这是大多数研究者真正敲代码的地方。
- 应用层:你连 SNN 都未必认识,只丢一句"帮我识别两个手势",它连模型选型、编码、解码、超参数整套替你定好,交给产品同事直接用。
这段对比的作用不是劝你永远停在哪层,而是让你看懂"抽象的每一级都在替你把一句大白话翻译成下一层的一堆小动作"——于是调试时你该往哪钻,也就有了定位。报错出来听不懂?多半是你停的抽象层太"上",需要往下钻一层看它到底做了什么。反过来,老是手忙脚乱写驱动,也许是你在该用算法层的场景里硬待在了原语层。会判断"此刻该在哪层拦问题",是调试神经形态程序最重要的软技能之一,比背任何框架 API 都管用。
抽象账小结
- 三层抽象:硬件原语 → 算法结构 → 应用层,各吞各的复杂度。
- 抽象越上省人力账、越下可控紧:要在省与可控之间挑平衡。
- 神经形态抽象的根:计算原语与通用范式不同,软件栈必须另起炉灶。
- 选框架问抽象在哪层,防止写一半不能调参的返工。