5.2 仿真平台与工具链
5.2 仿真平台与工具链
本节摘要:本节介绍在通用计算机上模拟 SNN 的成套工具——NEST、Brian、SpiNNaker 软件栈、Lava 等,读完你能为不同规模与场景选对仿真平台,并看懂"仿真跑通 ≠ 芯片能跑"之间的账差。
第 5.1 节讲了抽象层级,本节落进现实工具:想在真芯片花大价钱之前,先在通用计算机上把模型跑通、出波形、做 debug,全靠仿真平台。 每个平台的侧账不同——有的大规模高效,有的齐耳好学,有的天生接特定芯片。本节这些工具就像账房的试算表和模拟器,是"能不能靠谱落地"的第一道关。读它前只要记着"仿真≠实机"这句账。
一、仿真平台各干各的账
NEST:面向神经科学的大规模 SNN 仿真器,C++ 底层 + 可扩展命令,能跑到百万级神经元,是脑科学模拟的主力。缺点是偏科研、上手门槛高,偏重"忠实反映神经元群体电生理",而非"尽快出应用结果"。
Brian(Brian2):Python 优先、上手极快,能用几行代码定义神经元微分方程并仿真,特别适合学习和原型验证。代价是规模有限,跑不了超大网络。
SpiNNaker / 其软件栈:不只芯片——它的配套工具可以让你在一片"通用软件"里建网络、再映射到硬件并行模拟,兼顾仿真与实机。曼彻斯特的方案基本就是"把大脑想怎么连,这件事先建模再搬上百万核"。
Intel Lava(及 NxSDK/Loihi 工具链):面向 Loihi 的现代化 Python 框架,把"仿真与硬件统一在一个 API"作为卖点,你写一次模型,可先在软件仿真、再切到真片跑。Lava 也是抽象层教学的好教材——它在"算法层"上帮 Multi 藏好了硬件。
二、怎么选仿真平台
选型看三笔账:你要模拟多大网络、你要多快上手/应试、你最终要不要接某颗芯片。
- 科研、百万级、复杂神经元 → NEST;
- 想搞懂机制、快速验证、规模小 → Brian(Brian2);
- 最终目标是 Loihi → 直接从 Lava 或 NxSDK 起步,免中间层;
- 目标是 SpiNNaker 大规模并行 → 用它的配套软件栈。
给新手一条顺路的建议:先用 Brian 学会神经元模型与 STDP 的怎么落地(人少又直观),再搬到 Lava/SpiNNaker 看大规模与硬件联调——既赚理解又避坑。
三、一个最小 Brian 样例的"账感"
给一段几乎是最小可跑的 Brain 风格伪码,不是让你拷去跑,而是让你体会"仿真平台帮你把 LIF 藏起来"这件事:
from brian2 import * start_scope() tau = 10*ms; Vr=-70*mV; Vt=-55*mV # LIF 参数 G = NeuronGroup(100,'dV/dt = (Vr - V)/tau + I : volt', threshold='V>Vt', reset='V=Vr') G.I = 5 # 给点输入 run(100*ms) # 跑 100ms
你不需要懂 Brian 语法,只需看到:神经元模型(LIF)、阈值、复位、时间参数都成了声明性参数,你写的是"网络长什么样",而不是"每个时间步怎么手工累加"。这正是第 5.1 节"抽象藏复杂度"的活证。
四、仿真与实机的落差
仿真平台再顺手,也得牢记那句行军账:仿真跑通,绝不等于芯片能跑。 仿真里你是全精度浮点、内存无限、时序精确;真芯片上神经网络只能做低精度算术、内存有限、时序受路由与噪声限制。这一段落差,正是第 5.3 节"部署映射"要处理的全部内容。所以平台选得好,只能说第一关过了,后面还有硬仗。
⚠️ 常见坑:仿真里测出的"功耗/能效"数字别当成真芯片成绩。仿真算的是理想组合下理论值,真片还要扣路由、静态功耗、器件漂移——相差可能一个量级。
💡 关键直觉:仿真平台与真芯片的比例,约等于"CAD 图纸"与"施工实物"——先出图(仿真)看结构,真动工(实机)才有每砖的账。缺哪一关都容易返工。
补一句给多平台折腾者的宽心话:仿真工具不必一次到齐,往往是"先哪个适合眼前任务就用哪个",等规模或目标硬件变了再换——多平台衔接本身也是工具链能力的一部分,别为"统一栈"而统一。
五、一条完整工具链长什么样
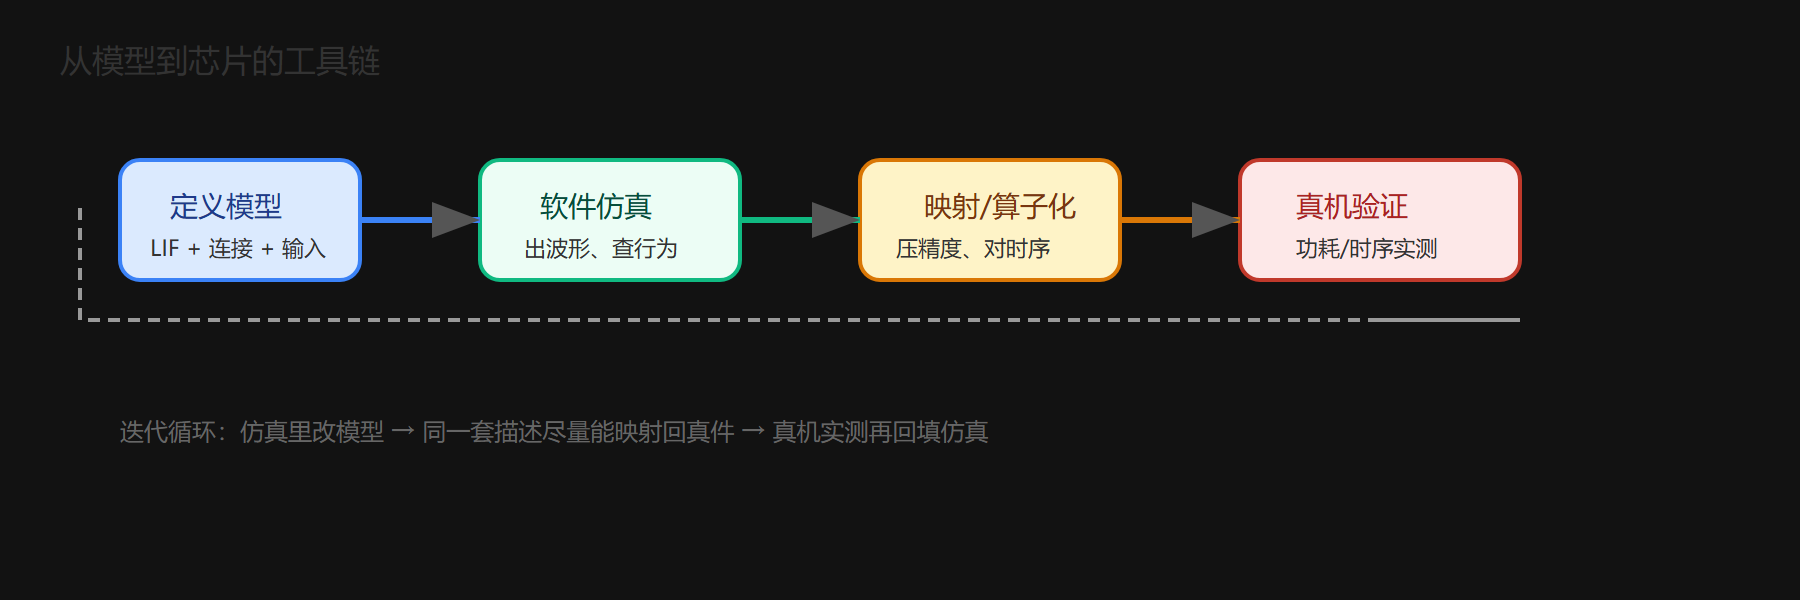
把"定义模型→仿真验证→映射上片"串起来,是一条流水线,先给你一张全貌图:
六、为什么偏要在仿真里 debug
听完"仿真 ≠ 实机",不妨倒过来问一句:既然真机才是落地,为什么还要花力气建仿真?答案藏在成本账里:在真芯片上试错一次,往往比在仿真里试错贵一个数量级。 造芯片或是调度集群要排队、要烧电、还要承受"测一次就多一份器件损耗与风险";而仿真里你随意改参数、注debug探针、跑上千次破坏性实验,都不用付这个成本。所以神经形态开发的标准流程是"先在仿真里把行为调对,再上真机做终验",这正是工具链环形反馈存在的意义。
但要注意仿真 debug 的一个反向陷阱:仿真太理想,会把"现实不会出现的完美"当成常态。比如你在仿真里设了全精度浮点,真件只能 8 bit 定点——仿真里性能好用,上片立刻垮。所以负责任的仿真工作流,会主动在仿真里加入数位化、噪声、时序抖动等"污染",让仿真和实机的差距提前暴露。这一点和一个老道理吻合:图纸越早引入真实约束,施工返工越少。
给你的实操顺序:先用 Brian 这类快速原型把机制与波形搞懂,再在更接近硬件的 Lava 或平台栈里把映射与数值域调顺,最后才轮到真机验证。每一层都比上一层更"真",也投入更贵——把便宜的仿真当试错主力,贵的真机只做终检,这套节奏最能守住你的时间账和钱包账。
试算账的结尾
- NEST 大规模科研仿真、Brian 快速原型、Lava 接 Loihi、SpiNNaker栈 接并行硬件。
- 选平台三问:规模、上手难度、最终要接哪颗芯片。
- 最小样例悟抽象:神经元模型成了声明式参数,你写"网络长什么样"。
- 仿真≠实机:精度、内存、时序三处落差是部署的硬骨头。