8.2 压缩、缓存与部署扩展
8.2 压缩、缓存与部署扩展
单机剖析优化到头之后,规模问题要靠架构接:压缩省的是带宽,缓存省的是计算,集群扩的是并发。本节把三件事放进同一张部署拓扑里讲——压缩与 HTTP 缓存在前几章已有伏笔,这里补进程内缓存与 Redis 的分层决策,再把 PM2 集群与容器化部署的配置一次配齐。
压缩的取舍账
第 3.2 节装配了 koa-compress,参数取舍在这里算账。压缩是拿 CPU 换带宽:JSON 文本压完通常只剩三成体积,代价是每请求一毫秒上下的压缩耗时。这笔账在两种场景下明显划算——响应体大(几十 KB 以上的列表接口)、带宽按量计费或跨公网传输;在两种场景下不划算——响应体小(1KB 以下,压缩后可能反而更大,threshold 参数挡掉)、CPU 已经吃满(此时压缩是火上浇油)。
app.use(compress({ threshold: 2048, // 2KB 以下不压 filter: (type) => /json|text|javascript/.test(type), br: { params: { [require('zlib').constants.BROTLI_PARAM_QUALITY]: 4 } }, // Brotli 压得比 gzip 更小,quality 4 是性能与压缩比的常用平衡点 }));
还有一个"免压缩"的高级形态:构建期预压缩。静态资源在流水线里提前生成 .gz 与 .br 文件,运行时直接吐文件(5.3 节 koa-static 的 gzip 选项),把运行时 CPU 开销挪到构建期——对高流量静态内容,这是标准的省法。
多级缓存:进程内、Redis、HTTP 各管一段
缓存决策的核心是回答两个问题:数据多久变一次与多实例间要不要共享。三个层级各答不同场景:
| 层级 | 延迟 | 共享性 | 适用数据 | 失效方式 |
|---|---|---|---|---|
| 进程内(Map 或 LRU) | 纳秒级 | 单实例私有 | 配置、热点字典、鉴权公钥 | 上限加 TTL |
| Redis | 毫秒级 | 全实例共享 | 会话、限流计数、热点业务数据 | TTL 加主动删除 |
| HTTP 缓存 | 零请求 | 客户端与中间层 | 静态资源、可缓存 API 响应 | Cache-Control 加 ETag |
一个典型读接口的三级装配:
// L1:进程内 LRU,挡住同一实例内的重复查询 const LRU = require('lru-cache'); const local = new LRU({ max: 500, ttl: 1000 * 30 }); // 半分钟级新鲜度 // L2:Redis,跨实例共享,分钟级新鲜度 async function getProduct(id) { const localHit = local.get(id); if (localHit) return localHit; const cacheKey = `product:${id}`; const redisHit = await redis.get(cacheKey); if (redisHit) { local.set(id, redisHit); return JSON.parse(redisHit); } const fresh = await productRepo.find(id); // L3:数据库 await redis.set(cacheKey, JSON.stringify(fresh), 'EX', 300); local.set(id, fresh); return fresh; }
缓存最难的部分从来不是读,是失效。三条纪律:其一,TTL 一律要设——"永久缓存"是事故的委婉说法;其二,写操作主动删相关 key(更新商品时删 product:id),把新鲜度从"赌 TTL 到期"变成"写后即失效";其三,进程内缓存在多实例下天然不一致——同一份数据各实例各缓各的,能接受秒级不一致(字典、配置)才放 L1,强一致的别放。
失效之外还有两个缓存时代的经典并发症要防。热点 key:某个爆款商品的缓存过期瞬间,成千上万并发同时未命中、同时落库(缓存击穿),数据库瞬间被打穿。解法是给热 key 的回源加互斥——同一时刻只放一个请求去查库,其余请求短暂等待后读新缓存;再加一层"逻辑过期"(缓存里存过期时间而非靠 Redis TTL,过期后异步刷新、期间返回旧值),把击穿窗口彻底抹掉。缓存雪崩:大批 key 设了相同 TTL,同一时刻集体过期。解法简单有效——TTL 加随机抖动(300 秒上下浮动半分钟),把过期时间点摊开。
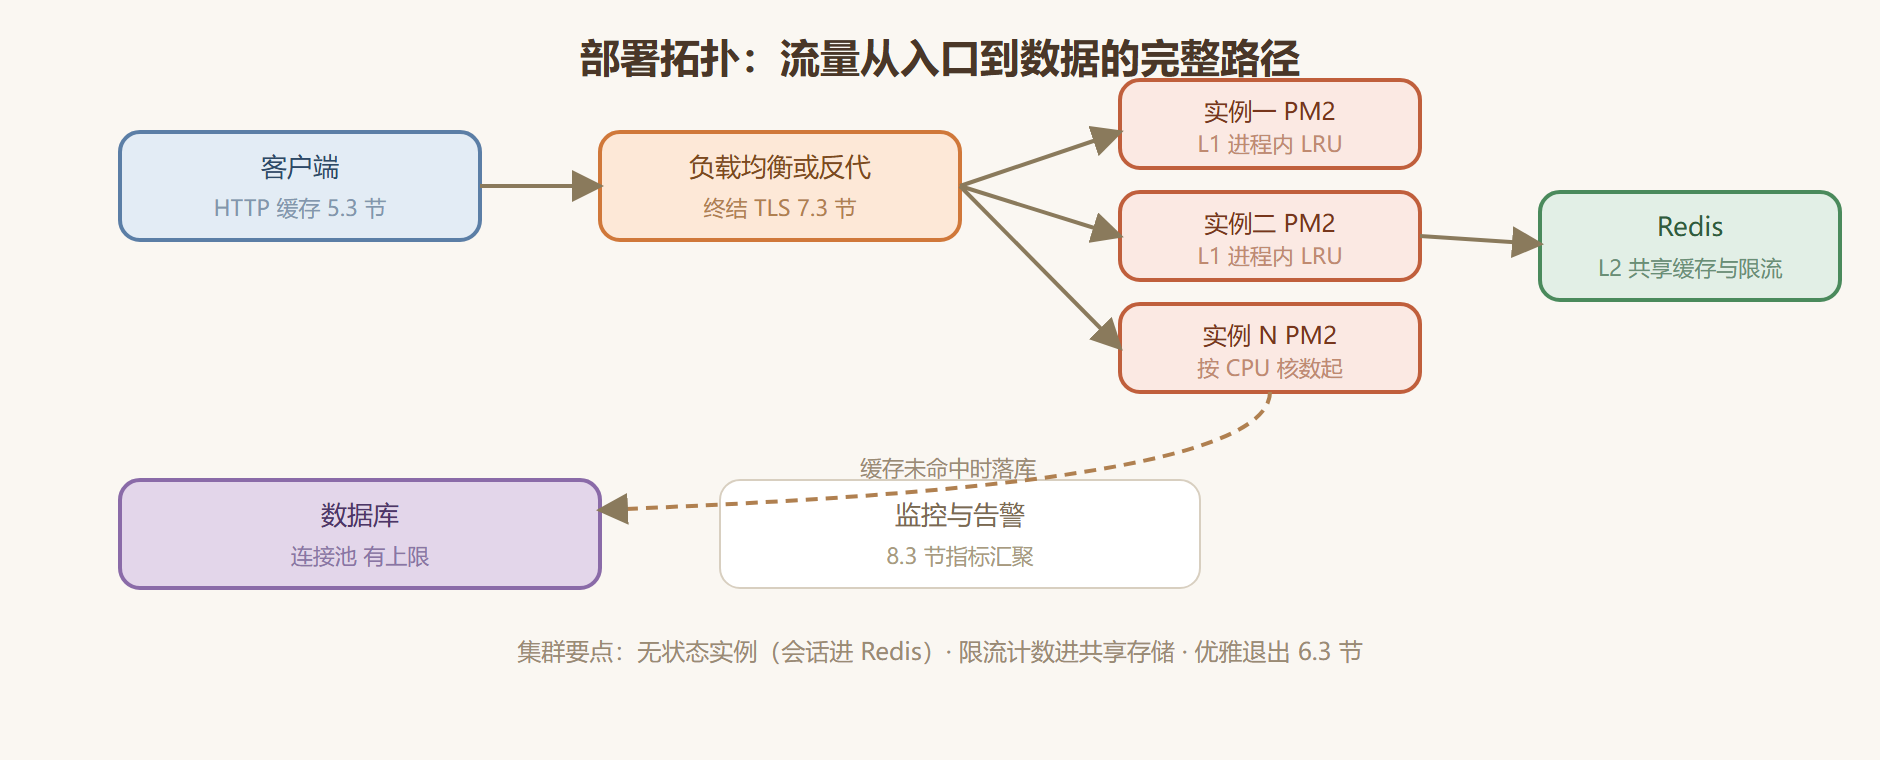
图 8-2:集群化部署拓扑全景
部署扩展:从单进程到集群
Node 单进程只能吃一个核,多核机器的第一步扩展是 PM2 集群模式:
npm install -g pm2 pm2 start app.js -i max --name koa-api # -i max:按 CPU 核数起等量实例 pm2 reload koa-api # 滚动重启:逐个替换实例,配合 6.3 优雅退出不掐请求 pm2 logs koa-api
集群模式的两个配套改造在前面章节都埋好了。实例必须无状态:会话数据进 Redis(7.2 的 JWT 本身无状态,最省心)、进程内限流计数(3.3 节提过)换成 Redis 实现——否则每实例各算各的,限流形同虚设。滚动重启依赖优雅退出:pm2 reload 发 SIGTERM,6.3 节的编排保证在途请求收尾后才退。
容器化部署时 PM2 的角色由编排器接手:Kubernetes 的副本数对应实例数,liveness 探针对应健康检查接口,滚动更新对应 pm2 reload——原理不变,名字不同。两种形态的共同纪律只有一条:实例无状态 + 优雅退出,做到这两条,扩缩容与发版就都是无损操作。
⚠️ 常见坑:扩容前先确认瓶颈不在数据库。加实例解决的是应用层并发不足;如果剖析显示瓶颈在数据库连接池或慢查询,加实例等于让更多连接去挤同一个更窄的门——先看 8.1 的分层账目,再决定横向还是纵向。
本节要点回顾
- 压缩是 CPU 换带宽:大响应划算、小响应赔本,threshold 挡住亏本单;预压缩把开销挪到构建期;
- 三级缓存各管一段:进程内管热点与配置、Redis 管共享与一致、HTTP 缓存管客户端;
- 失效三纪律:TTL 必设、写后主动删、进程内缓存只放容忍不一致的数据;
- 集群两件套:无状态实例加优雅退出,扩缩容与发版才无损;
- 先确认瓶颈再扩容:数据库打满时加实例是帮倒忙。
服务稳住了,凭什么保证它一直稳?下一节把质量与可观测的底盘建起来——测试锁住行为,调试定位问题,监控盯着趋势。