8.1 中间件性能剖析与优化
8.1 中间件性能剖析与优化
优化之前先测量——这一节的全部内容都建立在第 6 章的计时层之上。目标是把"接口慢"这个模糊的抱怨,拆解成"第几层、哪个函数、为什么慢"的精确诊断。三段内容:怎么拆层计时、三类反模式怎么识别与清除、剖析工具怎么用。
拆层计时:让每一层的开销现形
第 3 章的 accessLogger 只算了全程耗时,定位瓶颈需要分段账目。做法是给计时中间件加一个分段器,各层在关键点打点:
function profiler() { return async (ctx, next) => { ctx.state.marks = []; ctx.state.mark = (name) => ctx.state.marks.push([name, process.hrtime.bigint()]); const start = process.hrtime.bigint(); await next(); const total = Number(process.hrtime.bigint() - start) / 1e6; const marks = ctx.state.marks.map(([n, t], i) => { const prev = i === 0 ? start : ctx.state.marks[i - 1][1]; return `${n}:${(Number(t - prev) / 1e6).toFixed(1)}ms`; }); ctx.set('X-Profile', `${total.toFixed(1)}ms [${marks.join(', ')}]`); }; } // 业务层打点:解析、查询、序列化各记一笔 router.get('/orders', async (ctx) => { ctx.state.mark('query-start'); const items = await repo.list(ctx.query); ctx.state.mark('query-done'); ctx.body = items; });
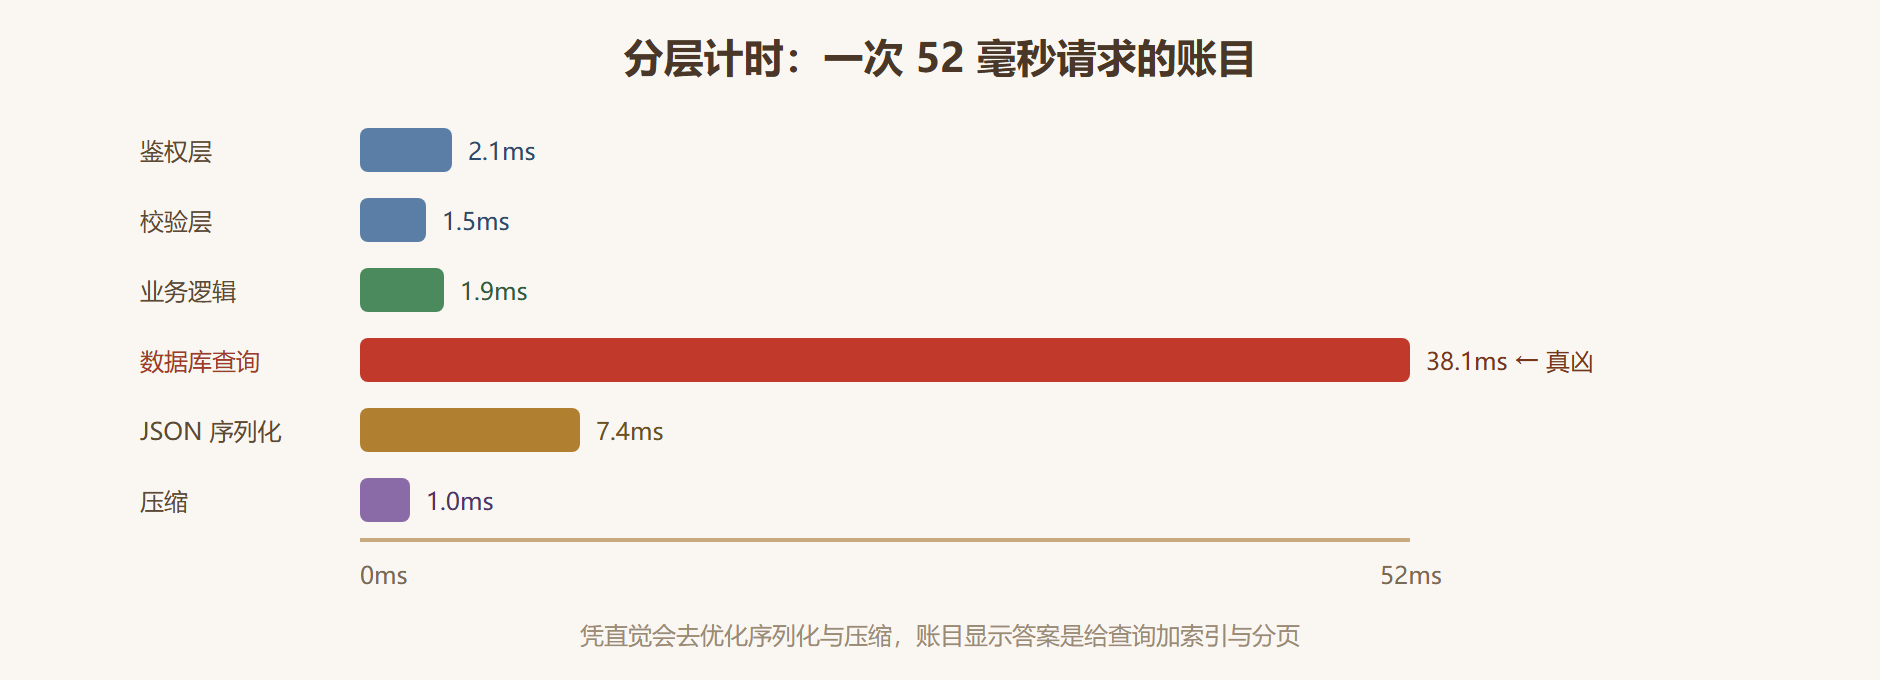
响应头 X-Profile 里就是一份分层耗时账。只对自己好奇的接口临时开启、监控环境关闭,避免头本身的泄漏。多数"接口慢"在这一步就现形了——账目通常长这样:42.3ms [query-start: 38.1ms, query-done: 0.2ms]——瓶颈一目了然在数据库查询,而不是你怀疑的中间件。
图 8-1:一次请求的耗时分层剖析
三类反模式:清除它们的优先级高于一切微优化
第 3 章预告过,这里给出完整的识别特征与修复手法。
反模式一:每请求同步 IO。 特征是中间件或热路径里出现 fs 的 Sync 系列、同步的 crypto 随机数、每请求读写配置文件。同步调用阻塞整个事件循环——并发 1000 时,一处 5 毫秒的同步读盘让所有排队请求各等 5 毫秒,吞吐直接掉一个量级。修复:配置启动时加载加监听变更;随机数用 crypto 的异步接口或进程启动时预生成;文件操作一律异步加缓存。
反模式二:每请求重计算。 特征是每请求执行可预计算的转换——权限矩阵展开、正则构造、模板编译。正则尤其隐蔽:new RegExp(userInput) 不仅慢,还是 ReDoS(正则回溯攻击)的入口。修复:预计算放工厂层(3.3 节的工厂闭包就是干这个的位置);动态正则改白名单或做长度与字符集限制。
反模式三:无上限集合。 第 6.3 节的守则一已展开,量化补充:无上限 Map 在每天百万请求的服务里,数天就能吃光堆内存,GC 停顿随之拉长——开篇"曲线缓慢爬升"最常见的原因就是它。修复:LRU 上限、定时清理、或干脆用 Redis 把容量问题移出进程。
剖析工具:从采样火焰图到堆快照
分段计时回答"哪一层慢",工具回答"那一行慢"。
CPU 剖析:node --cpu-prof app.js 运行压测,生成 .cpuprofile 文件,拖进 Chrome DevTools 的 Performance 面板看火焰图——横向是时间、纵向是调用栈,最宽的那块就是 CPU 大头。Koa 服务的火焰图里,正常形态是事件循环与各 async 函数窄窄地排开;如果出现一根又宽又平的柱子(常见的是 JSON.stringify、正则、bcrypt),那就是要动手的地方。
堆快照:排查内存增长(6.3 节守则三的展开):node --inspect app.js 后用 Chrome DevTools 的 Memory 面板拍两份快照(间隔一段压测),Comparison 视图按增量排序,顺着 retainers 链找是谁攥着对象不放——十有八九通向某个全局集合或被闭包捕获的 ctx。
压测基准:剖析前先建立可复现的压力,autocannon 一条命令:
npx autocannon -c 50 -d 30 http://localhost:3000/api/v1/orders # -c 50:50 并发;-d 30:持续 30 秒 # 输出的延迟分位数(P50 P99)与吞吐是优化的前后对照基准
优化流程因此固定成循环:压测取基线 → 分段计时定位层 → 火焰图定位函数 → 修改 → 压测对比 → 回归测试(8.3 节)确认行为未变。每一轮只改一处,否则性能变化归因不清。
💡 关键直觉:性能优化的第一原则是"不优化"。在剖析数据指认真凶之前,一切优化都是拿复杂性赌运气——赌错了白付复杂性,赌对了收益也常常与直觉相反。让 X-Profile 和火焰图说话,是这一节真正要养成的习惯。
本节要点回顾
- 分段计时先于一切:X-Profile 式的分层账目让瓶颈自己现形;
- 三类反模式优先清除:同步 IO 阻塞事件循环、每请求重计算、无上限集合,共性都是微观常数宏观放大;
- CPU 看火焰图、内存看堆快照对比:工具给出函数级证据,定位到行;
- 压测建立基线:autocannon 的分位数是优化前后的对照基准;
- 一轮只改一处:剖析、修改、对比、回归的闭环里,归因清晰比改得快重要。
单机账算清了,流量继续涨怎么办?下一节把镜头拉到部署层——压缩、多级缓存与集群扩展,让架构而不是单机扛起规模。