5.1 编解码器:流水线上的车床
5.1 编解码器:流水线上的车床
本节摘要:编解码器是流水线上的成型工位——解码器把字节原料加工成消息对象(入站方向),编码器把消息对象还原成字节(出站方向)。本节讲清两大基类的工作机制、累积缓冲的原理、ReplayingDecoder 的便利与代价,并动手造一台完整的车床。
一、车床的本质:两道对称的工序
业务代码想处理的从来不是字节,而是"一条登录请求""一个心跳包"这样的对象。编解码器就是字节世界与对象世界之间的翻译工位:
- 解码器 Decoder:入站工位,基类
ByteToMessageDecoder。它维护一块累积缓冲,每有字节到达就追加,然后反复尝试"切出一帧 → 转成对象 → 向下游发射"。 - 编码器 Encoder:出站工位,基类
MessageToByteEncoder。只处理指定类型的出站消息,把对象字段依次写入 ByteBuf。
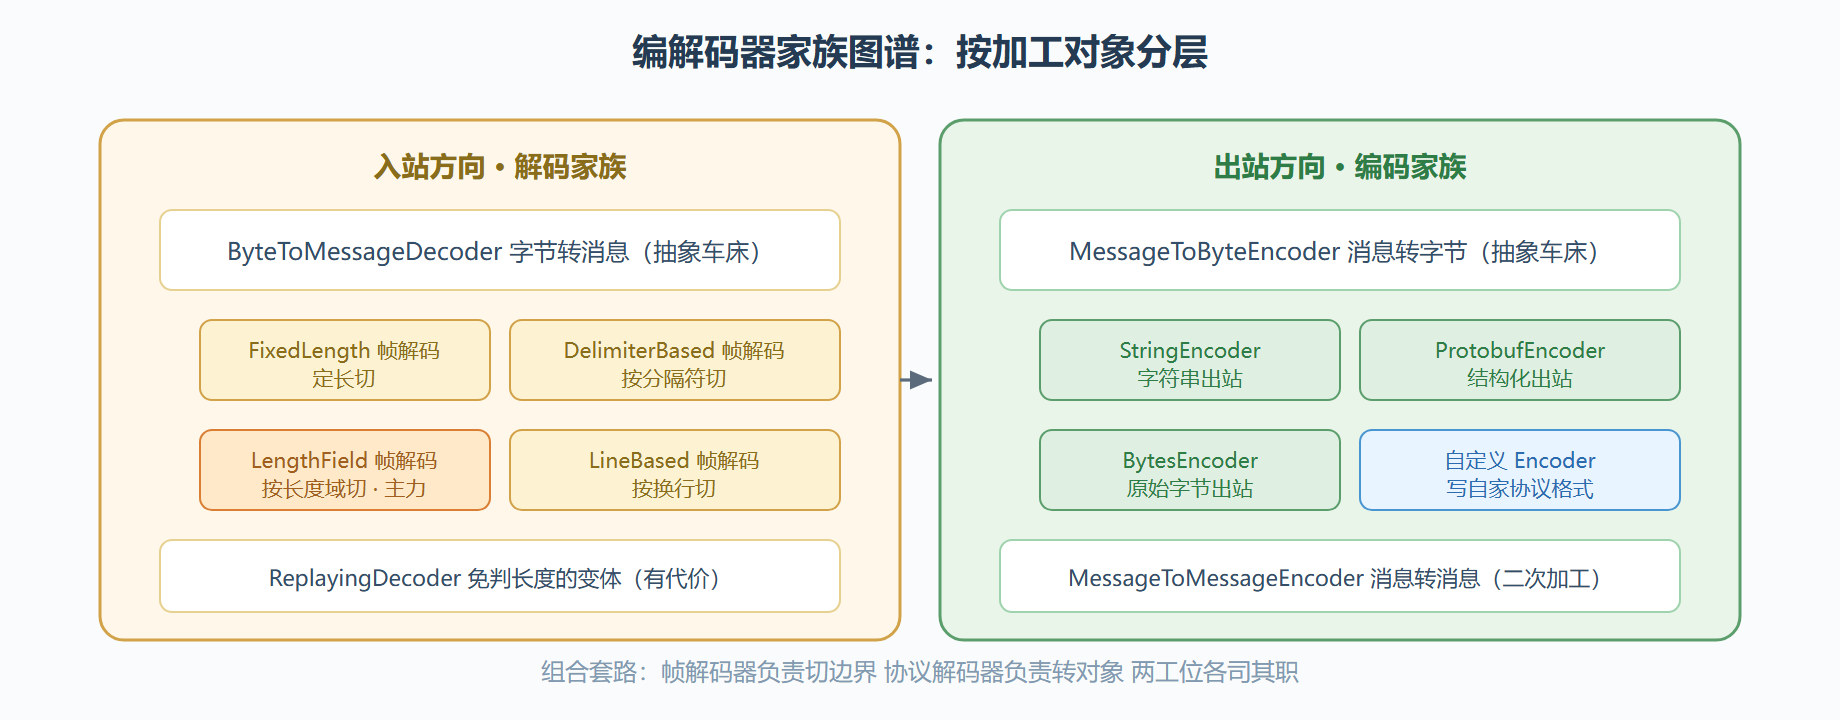
二、解码基类的累积机制
ByteToMessageDecoder 内部有一块 cumulation 累积缓冲。看它的骨架逻辑(简化):
// 简化的工作循环:每次有字节到达 cumulator.cumulate(alloc, cumulation, in); // 新字节追加到累积缓冲 callDecode(ctx, cumulation, out); // 尝试切出零或多条消息 // callDecode 内部反复调你的 decode,直到 decode 不再产出不饱和
也就是说你只需要实现"够不够切、怎么切"的判断,攒数据、扩容、丢弃已读部分全部由基类包办。这是设计模式里典型的模板方法:稳定的攒料流程 + 可变的切料规则。
与之对称,MessageToByteEncoder 只要求你实现 encode(ctx, msg, out),把对象写进 out,基类负责类型过滤(不匹配泛型的消息直接透传)、缓冲分配与异常兜底。
三、动手造一台完整车床
定义一个极简协议:帧 = 1 字节类型 + 4 字节长度 + 载荷。配对的车床如下:
// 解码工位:字节 → 消息对象(与 LengthFieldBasedFrameDecoder 搭配,见 5.2/5.3) public class MyDecoder extends ByteToMessageDecoder { @Override protected void decode(ChannelHandlerContext ctx, ByteBuf in, List<Object> out) { if (in.readableBytes() < 5) return; // 长度域都不够,等下一批原料 in.markReaderIndex(); // 记住起点,切不动要回退 byte type = in.readByte(); int len = in.readInt(); if (in.readableBytes() < len) { in.resetReaderIndex(); // 原料不足,回退等待 return; } byte[] payload = new byte[len]; in.readBytes(payload); out.add(new MyMessage(type, payload)); // 产出一个对象,基层自动向下游发射 } } // 编码工位:消息对象 → 字节 public class MyEncoder extends MessageToByteEncoder<MyMessage> { @Override protected void encode(ChannelHandlerContext ctx, MyMessage msg, ByteBuf out) { out.writeByte(msg.getType()); out.writeInt(msg.getPayload().length); out.writeBytes(msg.getPayload()); } } // 装配:解码器在前,编码器在后(顺序原因见第三章出站传播规则) ch.pipeline().addLast(new MyDecoder(), new MyEncoder(), new BizHandler());
两个易错点值得盯住。其一,decode 里的回退:长度域读完后发现载荷不足,必须 resetReaderIndex,否则下次进入时指针已错位,消息边界彻底乱掉。其二,编码器的泛型过滤:MessageToByteEncoder<MyMessage> 只处理 MyMessage 类型,其他出站消息原样透传——所以一条流水线可以叠多个编码器各管各的类型。
四、ReplayingDecoder:便利与代价
ReplayingDecoder 让你免写"够不够"的判断:读取不够时它自动抛出信号、回滚、等下次再试,decode 写起来像顺序读文件:
public class EasyDecoder extends ReplayingDecoder<Void> { @Override protected void decode(ChannelHandlerContext ctx, ByteBuf in, List<Object> out) { byte type = in.readByte(); // 不够读?自动回滚等下次 int len = in.readInt(); // 同上 byte[] payload = new byte[len]; in.readBytes(payload); out.add(new MyMessage(type, payload)); } }
代价藏在实现里:ReplayingDecoder 基于自定义的 ReplayingDecoderBuffer 包装,某些操作(如 discardSomeReadBytes 以外的批量丢弃)不支持,且慢路径上性能低于手写判断版。经验法则:快速原型与简单协议用 ReplayingDecoder,性能敏感与复杂状态机用手写版。
⚠️ 常见坑:在 decode 里做耗时操作(解压大包、查库)会占住 EventLoop 线程,整条流水线排队——解码只做"形状加工",重业务放后面的工位或业务线程池(第六章)。
💡 关键直觉:车床设计的两个核心问题永远是"料够不够"(边界判断)与"刀从哪下"(字段顺序)。前者交给累积机制与帧解码器,后者就是你协议格式的定义。
车床操作守则速记
- 对称双工位:ByteToMessageDecoder 入站加工,MessageToByteEncoder 出站还原。
- 累积缓冲:基类自动攒料,你只写切料规则(模板方法)。
- 回退纪律:读了一半发现不够,必须 resetReaderIndex。
- 编码器泛型过滤:类型不匹配自动透传,多编码器可叠放。
- ReplayingDecoder:免判断但慢路径有代价,按场景选。
- 解码器不干活:只做形状加工,重业务后移。