5.2 粘包与半包:字节流的切分工序
5.2 粘包与半包:字节流的切分工序
本节摘要:TCP 是字节流协议,发送端的多次 write 在接收端可能合并成一次 read(粘包),也可能一条消息被拆成多次(半包)。本节用字节流示意图讲透成因,给出 Netty 四种帧解码器的代码与选型表,并演示一个复现与修复粘包的完整实验。
一、先复现一次事故
不装任何帧解码器,直接在服务端打印每次 channelRead 收到的内容:
ch.pipeline().addLast(new ChannelInboundHandlerAdapter() { @Override public void channelRead(ChannelHandlerContext ctx, Object msg) { ByteBuf b = (ByteBuf) msg; System.out.println("收到 " + b.readableBytes() + " 字节"); b.release(); } }); // 客户端连发十条 100 字节消息,服务端输出可能长这样: // 收到 256 字节 ← 三条消息粘在一起 // 收到 244 字节 // 收到 300 字节 // 也可能某次只有 28 字节 ← 半包
十条消息变成三四个"大小不一的包裹",业务如果按"一次收到一条"的假设写,直接解析出错。这不是网络故障,而是 TCP 的工作方式。
二、成因:字节流没有消息的概念
同一条 TCP 流上的切分乱象
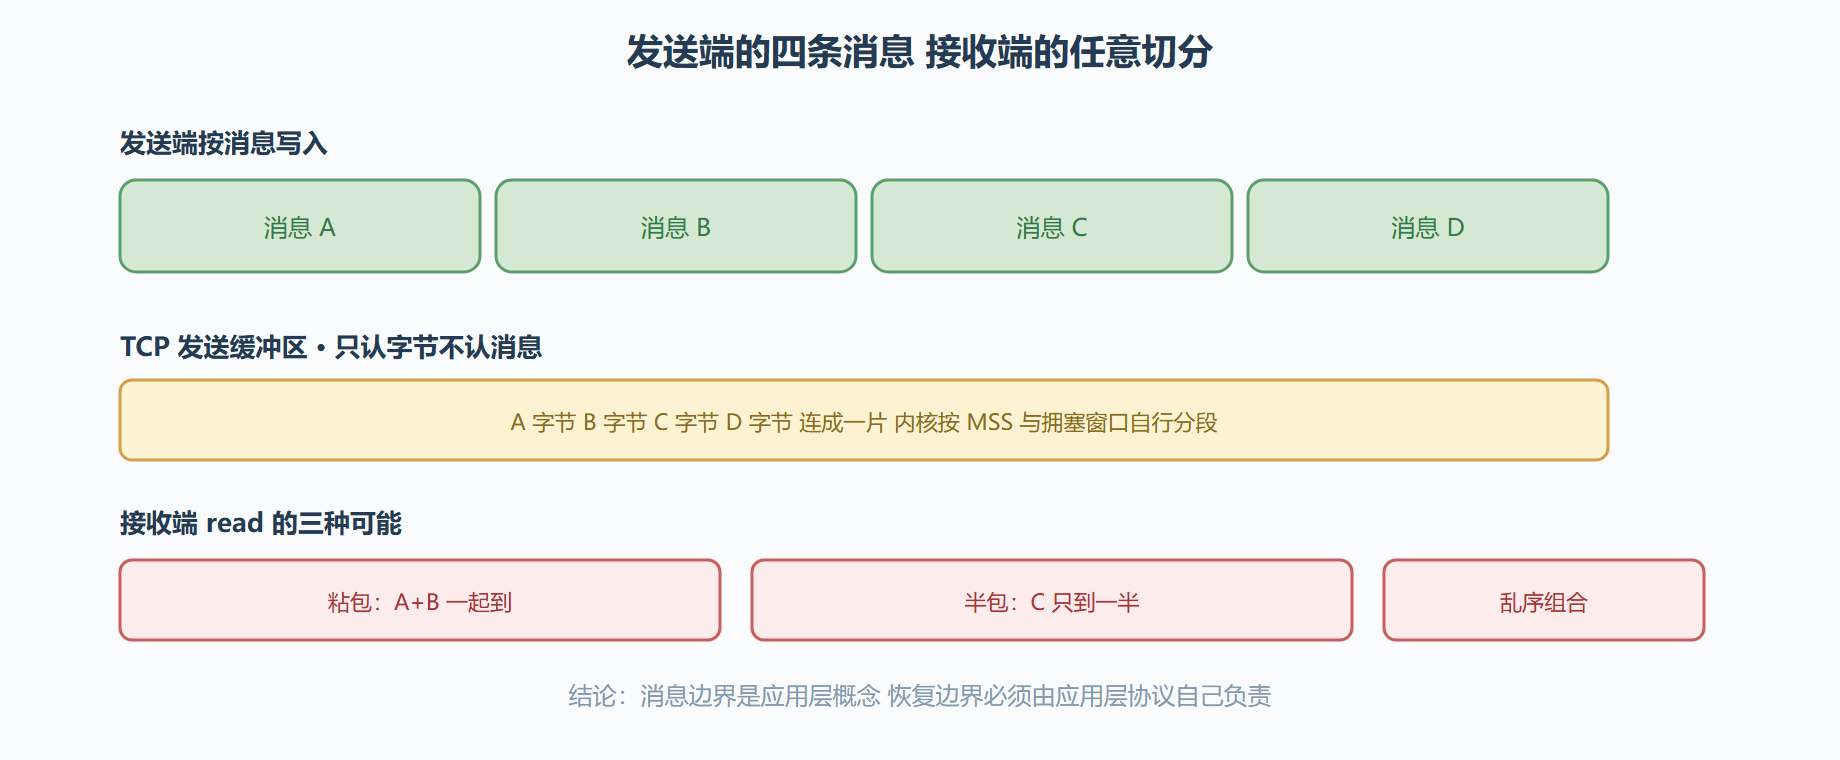
推到根上有三个物理原因:发送端 Nagle 算法与 MSS 分段会把小消息合并、大消息拆开;网络路径上路由器按 MTU 再切;接收端内核缓冲与 read 时机决定一次能拿到多少。TCP 承诺的只有字节按序到达,从不承诺按消息到达。所以 UDP 反而"没有粘包"(它保留报文边界),代价是不可靠——这也解释了为什么自定义协议几乎都建在 TCP 上再自己补边界。
三、四种切分方案与代码
Netty 把"从字节流里切帧"这件重复劳动做成了标准件——四个帧解码器,对应四种边界约定:
// 方案一:定长帧。每条消息固定 N 字节,不足补齐 —— 简单但浪费 p.addLast(new FixedLengthFrameDecoder(100)); // 方案二:分隔符。以特殊字节序列结尾 —— 文本协议常用 p.addLast(new DelimiterBasedFrameDecoder(8192, Delimiters.lineDelimiter())); // 换行作为边界,telnet 风格 // 方案三:长度域。帧头带长度字段 —— 二进制协议主力,参数见 5.3 p.addLast(new LengthFieldBasedFrameDecoder(1024, 0, 4, 0, 4)); // 方案四:换行符。LineBasedFrameDecoder 是方案二的特化 p.addLast(new LineBasedFrameDecoder(8192));
| 方案 | 边界约定 | 优点 | 缺点 | 典型用户 |
|---|---|---|---|---|
| FixedLength | 定长 | 实现最简 | 定长难凑、浪费带宽 | 老式金融报文、固定卡口 |
| Delimiter | 特殊分隔符结尾 | 文本友好、可流式读 | 载荷需转义分隔符 | 聊天行协议、Redis 早期RESP |
| LengthField | 帧头长度域 | 紧凑、载荷无约束、解析快 | 需要定义帧头 | 绝大多数 RPC 与 MQ |
| LineBased | 换行结尾 | 调试直观 | 二进制不适用 | 文本调试协议 |
四、完整实验:复现、修复、验证
用一个可跑的对照实验把方案三钉牢(客户端故意每 2ms 发一条 100 字节消息制造粘包):
// 客户端:消息 = 4 字节长度 + 载荷(与 LengthField 参数对应) void sendMsg(Channel ch, byte[] payload) { ByteBuf buf = ch.alloc().buffer(4 + payload.length); buf.writeInt(payload.length); buf.writeBytes(payload); ch.writeAndFlush(buf); } // 服务端:装上帧解码器,channelRead 收到的必然是完整一条 ch.pipeline() .addLast(new LengthFieldBasedFrameDecoder(1024, 0, 4, 0, 4)) .addLast(new ChannelInboundHandlerAdapter() { @Override public void channelRead(ChannelHandlerContext ctx, Object msg) { ByteBuf frame = (ByteBuf) msg; // 保证是完整一帧 byte[] payload = new byte[frame.readableBytes()]; frame.readBytes(payload); System.out.println("完整消息 " + payload.length + " 字节"); // 恒为 100 frame.release(); } });
修复前后各跑一次:修复前输出杂乱的字节数,修复后每行都是"完整消息 100 字节"。这就是边界恢复的全部魔法。
⚠️ 三个高频坑:其一,长度域被恶意或异常写成超大值,帧解码器会攒内存直到上限抛 TooLongFrameException——生产必须设 maxFrameLength(示例中的 1024)并把它当成协议契约的一部分;其二,编码端写长度时用了"总长"而解码端按"载荷长"解释,差 4 字节全线错位,联调时先用字节级日志核对;其三,一台服务里新旧客户端协议混用,帧解码器只能配一种,协议升级要设计版本协商位。
💡 关键直觉:粘包半包不是"要解决的问题",而是"要接受的现实"。设计任何 TCP 协议的第一件事,永远是先回答边界怎么表达——定长、分隔符、长度域三选一,其余设计都排在它后面。
本节要点回顾
- 成因:TCP 面向字节流,Nagle/MSS/缓冲时机共同制造任意切分,UDP 反而无此问题。
- 修复原则:边界是应用层协议的事,与 Netty 无关;Netty 只是把常见约定做成了标准件。
- 四个标准件:FixedLength 定长、Delimiter 分隔符、LineBased 换行、LengthField 长度域。
- 首选长度域:紧凑、无转义、解析 O(1),是 RPC/MQ 的事实标准。
- maxFrameLength 是安全阀:必须设置并校验,防异常长度撑爆内存。
- 验证方法:EmbeddedChannel 或字节级日志,先看切分再谈解析。