4.2 内存池:Arena、Chunk 与 Page 的仓储设计
4.2 内存池:Arena、Chunk 与 Page 的仓储设计
本节摘要:PooledByteBufAllocator 借鉴 jemalloc 的分级仓储思想:线程绑定的 Arena 切成 16MB 的 Chunk,Chunk 再切成 8KB 的 Page 与更细的 SubPage,用"规格化尺寸 + 位图"把分配从系统调用变成查表。本节拆解这条分配路径与关键参数。
一、为什么需要仓储:malloc 太贵
没有池化时,每条消息都要向 JVM 或操作系统要内存:堆内靠 GC 事后回收,堆外靠 malloc 系列调用。消息量到每秒几十万时,两条路都很痛——GC 停顿随分配速率上涨,malloc/free 的系统调用与锁竞争吃掉吞吐。工程界的通用解法是内存池:一次批发,长期零售。Netty 4 的默认分配器 PooledByteBufAllocator 就是这个思路,设计蓝本是久经考验的 jemalloc。
二、仓库的货架结构:Arena → Chunk → Page → SubPage
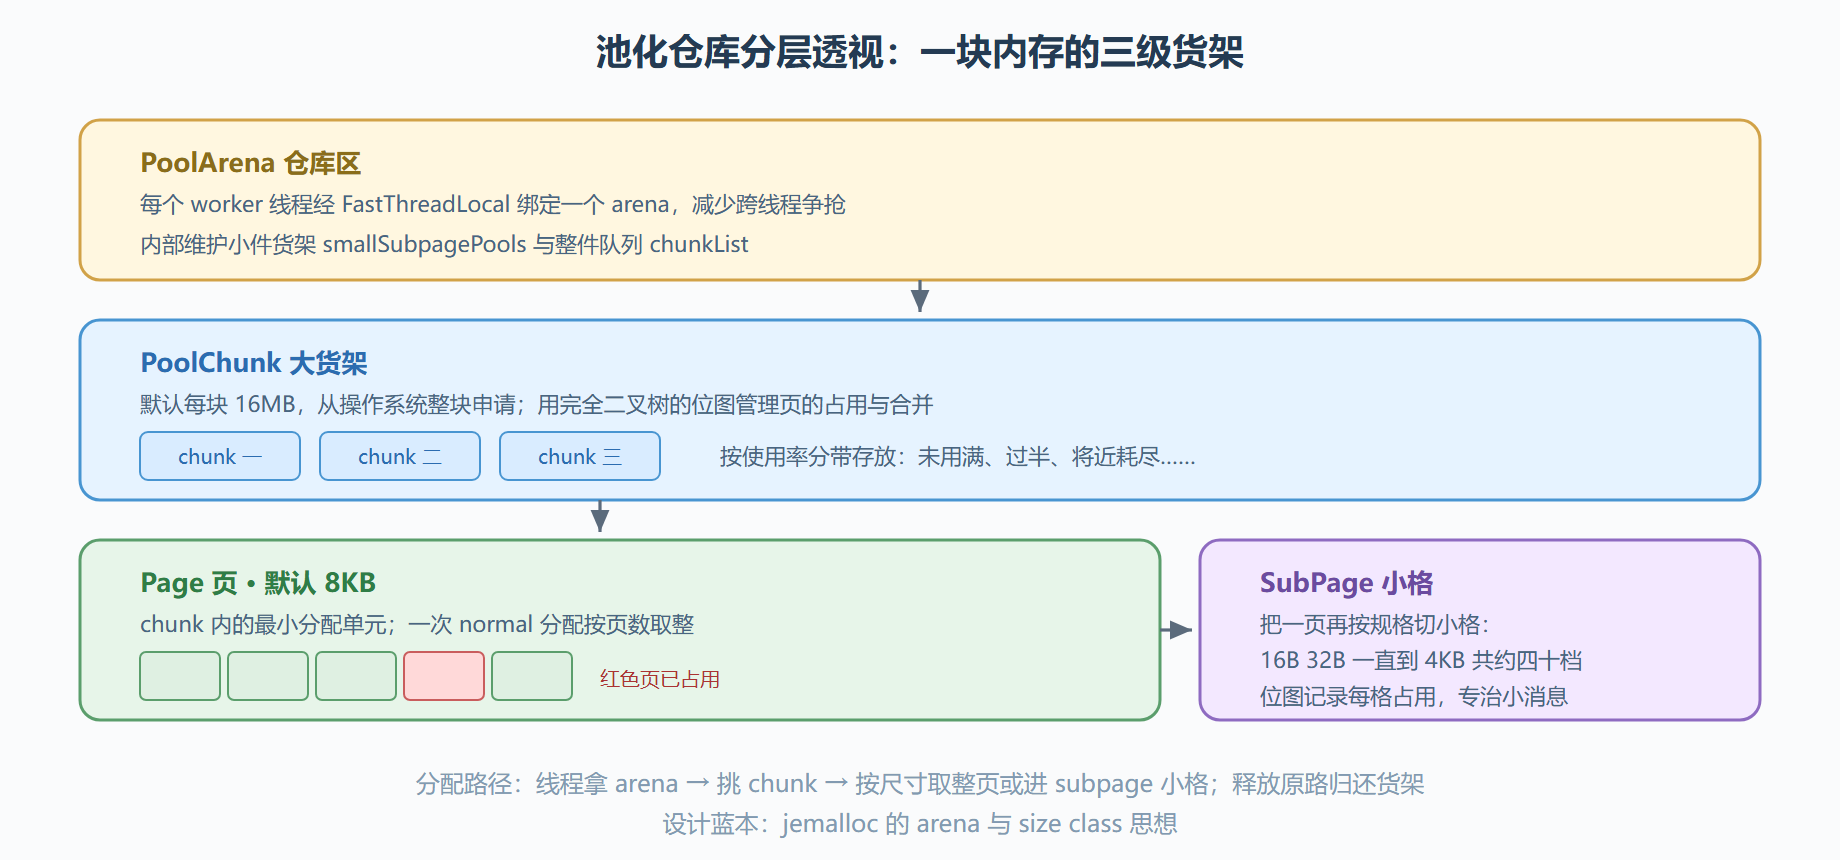
四层结构各自的职责:
- PoolArena:仓库区。数量默认是核数的两倍(堆内堆外各算一组),worker 线程通过 FastThreadLocal 认领自己的仓库区,零售几乎无争抢。
- PoolChunk:大货架,默认 16MB,从操作系统整块批发进来。内部用一棵完全二叉树(深度 11)管理 2048 页的占用情况,分配与合并都是位运算级别的速度。
- Page:货架上的标准托盘,默认 8KB。申请 9KB 会占两页——按页向上取整。
- SubPage:小格抽屉。消息不足一页时,把某页按规格(16B、32B……4KB,共约四十档)切成小格,位图记录每格去留。网络消息大多落在 16B 到 1KB 档位,SubPage 是实际主力。
规格化是池化的灵魂:申请 33B 实际给 48B 档,浪费一点空间,换来"归还后能立刻被下一个同规格请求复用"。这是典型的空间换时间。
三、三种请求的走法
// 手动体验池化分配(服务端默认已是池化,这里为了看清路径) ByteBuf small = PooledByteBufAllocator.DEFAULT.directBuffer(64); // → subpage 小格 ByteBuf normal = PooledByteBufAllocator.DEFAULT.directBuffer(16 * 1024); // → 整页取整 ByteBuf huge = PooledByteBufAllocator.DEFAULT.directBuffer(32 * 1024 * 1024); // → 不进池,直接要 System.out.println(small.maxFastWritableBytes()); // 观察实际拿到的规格 ReferenceCountUtil.release(small); // 归还小格,立刻可复用
- small(小于一页):查本 arena 的 smallSubpagePools 有没有现成同规格抽屉,有则拿一格;没有则找 chunk 开新抽屉。
- normal(一页到 chunk 上限):在 chunk 的二叉树上找一段连续空闲页。
- huge(超过 chunk):不进池,直接向系统申请,用完即还——池化对它没有意义。
释放则原路返回:release 归零后,小格回抽屉、页段回二叉树、相邻空闲页自动合并。归还是池化生效的前提——这也是 4.1 那套账本纪律存在的根本原因。
四、参数与验证
常用开关集中在启动参数与分配器配置上:
-Dio.netty.allocator.numDirectArenas=8 堆外仓库区数量,默认核数 -Dio.netty.allocator.pageSize=8192 页大小,默认 8KB -Dio.netty.allocator.maxOrder=11 决定 chunk 大小(页 × 2 的 maxOrder 次方 = 16MB) -Dio.netty.allocator.smallCacheSize=256 线程本地小件缓存 -Dio.netty.allocator.useCacheForAllThreads=false 是否所有线程都享受线程本地缓存
验证池化是否生效,最直接的办法是看指标(第七章的仪表盘会讲全局统计),此处先给个轻量版:
PooledByteBufAllocator alloc = PooledByteBufAllocator.DEFAULT; ByteBuf buf = alloc.directBuffer(256); System.out.println(alloc.metric().numDirectArenas()); // 堆外仓库区数量 buf.release();
⚠️ 常见坑:单元测试里频繁 new 服务器又不停机,池子越建越多,直观数据结构上看着像泄漏。测试环境可以
-Dio.netty.allocator.type=unpooled临时切非池化,排查时少一个变量;生产保持默认池化。
💡 关键直觉:池化把"每次申请内存"变成"从自家货架取货":线程认领仓库区(arena)免争抢,大货架(chunk)批量进货免系统调用,规格化小格(subpage)免碎片。代价只有一条——必须记账归还。
五、柜台抽屉:线程本地缓存
四级结构之外还有一层容易被漏看的加速器:PoolThreadCache。每个线程在仓库区之外自带一组小抽屉,release 归还的内存先入抽屉,下次同规格请求直接从抽屉里取,连仓库区的定位开销都省了;抽屉装满才真正归还货架,线程退出时抽屉整体上缴。前面参数清单里的 smallCacheSize、normalCacheSize 调的就是抽屉大小——读写频繁的推送类服务适当调大有可测收益。
理解抽屉之后,一个经典谜题也顺带解开:为什么流量平稳时 Netty 的堆外曲线几乎是平的?因为请求与归还在用户态的自家货架间循环,极少真正向操作系统批发内存。分配器指标里的 arena 命中率,说的就是这件事。
离开原料仓前带走这几条
- 设计蓝本:jemalloc 的 arena 与 size class 思想,Netty 4 起默认启用。
- 四级结构:Arena 仓库区(线程绑定)→ Chunk 16MB 大货架 → Page 8KB 托盘 → SubPage 规格小格。
- 三种请求路径:small 进小格、normal 整页取整、huge 不进池。
- 规格化换复用:按档位分配,空间略浪费,归还即可复用。
- 归还是前提:release 不归零,池化反而是泄漏放大器。
- 关键参数:numDirectArenas、pageSize、maxOrder,改前先看指标再动手。