4.3 防漏与止损:泄漏检测、直接内存与回收
4.3 防漏与止损:泄漏检测、直接内存与回收
本节摘要:引用计数漏销账不会立刻报错,只会让堆外内存慢慢见顶。ResourceLeakDetector 用采样与引用追踪在开发期抓现行;直接内存与堆内存的取舍决定拷贝次数与 GC 压力;对象级的 Recycler 则把"周转箱"思想推广到普通对象。本节给出完整的排查与配置套路。
一、泄漏是怎么溜进去的
回顾 4.1 的账本:ByteBuf 的释放靠 release() 归零。忘掉一次 release,非池化容器就永远占着堆外内存;池化容器则占着货架上一格。它不像普通 Java 对象有 GC 兜底——引用计数是纯手工账本,GC 根本看不见"这格还没还"。
更阴险的是症状滞后:泄漏初期一切正常,堆外内存曲线以每天几百 MB 的速度爬坡,几周后在流量高峰处爆发 OutOfDirectMemoryError,此时距离肇事代码上线已久。所以纪律是:开发期就打开检测,别等线上报警。
二、ResourceLeakDetector:四个档位的抓漏灵敏度
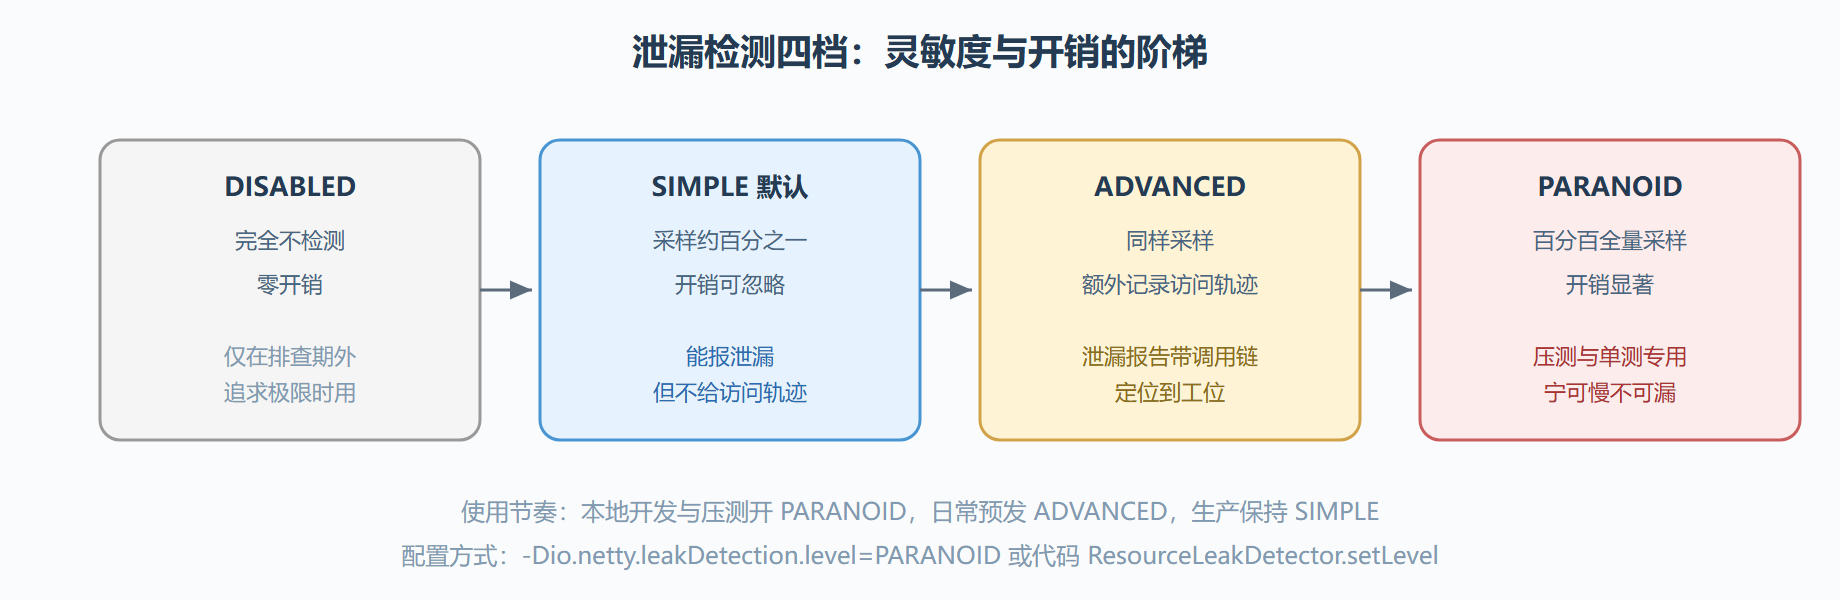
亲手制造并抓一次泄漏,比读十遍文档有效:
// 开场先拉满灵敏度 ResourceLeakDetector.setLevel(ResourceLeakDetector.Level.PARANOID); EventLoopGroup group = new NioEventLoopGroup(); Bootstrap b = new Bootstrap(); /* 略去装配,处理器故意不释放 */ b.handler(new ChannelInboundHandlerAdapter() { @Override public void channelRead(ChannelHandlerContext ctx, Object msg) { // 正确写法应释放或继续传播;这里什么都不做 → 每条消息泄漏一只箱子 } }); // 跑一小段流量后,控制台将出现: // ERROR io.netty.util.ResourceLeakDetector - LEAK: ByteBuf.release() was not called // before it's garbage-collected. Recent access records: ... // #1 - ...Handler.channelRead(...) ← 肇事工位直接点名
报告里的 Recent access records 就是引用被创建、读写、传递的调用轨迹,最后一条通常就是"拿了不还"的工位。把 PARANOID 挂进持续集成跑一轮全量用例,泄漏在合并前就现形。
三、直接内存与堆内存:装哪种料箱
| 维度 | 堆内 heap buffer | 堆外 direct buffer |
|---|---|---|
| 分配与回收 | new 便宜,GC 兜底 | 进制下更贵,靠池化摊薄 |
| 网络发送路径 | 堆 → 内核,多一次拷贝 | 直接写内核,省一次拷贝 |
| GC 压力 | 占堆,影响停顿 | 不占堆,元数据仅小对象 |
| 越界风险 | JVM 层报错友好 | 越界即致命信号,排查更难 |
| 适用 | 测试、解析后的小对象、需长期驻留 | 网络读写缓冲(Netty 默认) |
Netty 默认走堆外是有道理的:socket 读写的是堆外地址,堆内缓冲发送时必须先拷到临时堆外缓冲,大流量下这次拷贝积少成多。代价是堆外不能超发——上限由 JVM 参数控制:
-XX:MaxDirectMemorySize=2g # 堆外上限,默认约等于堆大小 -Dio.netty.maxDirectMemory=0 # 特殊场景交给 JDK 自管,一般不动
⚠️ 常见坑:容器里堆设 4G、堆外上限也默认跟到 4G,而容器整体内存限额 6G——某天堆外用到 2.5G 时容器被 OOMKill。容器部署要把堆 + 堆外 + 元空间 + 线程栈的总和压在限额内,堆外上限显式写死。
四、把箱子思想推广:对象回收与 GC 减负
除了字节容器,Netty 内部还大量使用 Recycler 对象池回收普通对象(如早期的 PoolThreadCache 元素、各种 Event 对象),思想与内存池同源:高频创建销毁的对象改成"取用—归还"。业务层如果也有高频小对象(比如每条消息一个上下文对象),可以参考同样的思路,但先量后改——对象池本身也有账本开销与缓存伪共享风险,没有 profiling 数据支撑的池化是过早优化。
GC 侧的常规减负手段在 Netty 服务上同样有效:堆外缓冲不进老年代,天然给 GC 减了最肥的一块;FastThreadLocal 用数组下标代替哈希表探查,减少垃圾;4.1 的账本纪律让"该还的都还了",堆外曲线平稳。把这些合起来,第七章调优清单里的"内存篇"就有了全部前置知识。
💡 关键直觉:防泄漏三板斧——开发期 PARANOID 抓现行、部署时显式设堆外上限、代码里守住"谁最后用谁释放"。三板斧之外的所有花招都是补救。
五、高频追问两则
泄漏报告在测试环境复现不了怎么办? 采样与触发时机都依赖 GC——报告是在 ByteBuf 被 GC 回收时才打印"没 release 就被丢了"。压测用例要跑到对应对象真正发生 GC 才会现形;给 JVM 加 -Dio.netty.leakDetection.targetRecords=4 提高轨迹保留数,配合 jmap 或 jcmd 手动触发 full GC,能让报告更早出现。复现三要素:PARANOID 档、足够吞吐、一次手动 GC。
堆内存就一定更安全吗? 不释放的堆内 ByteBuf 至少还有 GC 兜底,但兜底也有边界:池化的堆内缓冲同样挂在引用计数账本上,GC 只能回收 Java 对象壳子,池里的格子仍被记为"在用",货架被悄悄占满。结论不变:账本纪律与堆内堆外无关,direct 还是 heap 只影响物理存放位置,不影响谁来记账。
止损手册速记
- 泄漏症状滞后:堆外爬坡数周后爆发,开发期检测是唯一正解。
- 四档灵敏度:SIMPLE 默认、ADVANCED 带轨迹、PARANOID 全量压测用。
- 报告即证据:Recent access records 的最后一条就是肇事工位。
- 堆外是默认:网络缓冲走 direct 省一次拷贝,但必须设显式上限。
- 容器内存账:堆 + 堆外 + 元空间 + 栈,总和压在限额内。
- Recycler 同源思想:高频对象取用归还,先量后改,警惕过早优化。