7.2 吞吐与延迟:车间提速调优清单
7.2 吞吐与延迟:车间提速调优清单
本节摘要:性能问题先分型(延迟型还是吞吐型),再按层排查(应用、线程、内存、内核),一次只动一个参数并压测对照。本节给出决策清单 SVG、四个维度的具体参数与典型病案,覆盖内存分析、线程竞争与 CPU 利用率的联动判断。
一、先分型:延迟病还是吞吐病
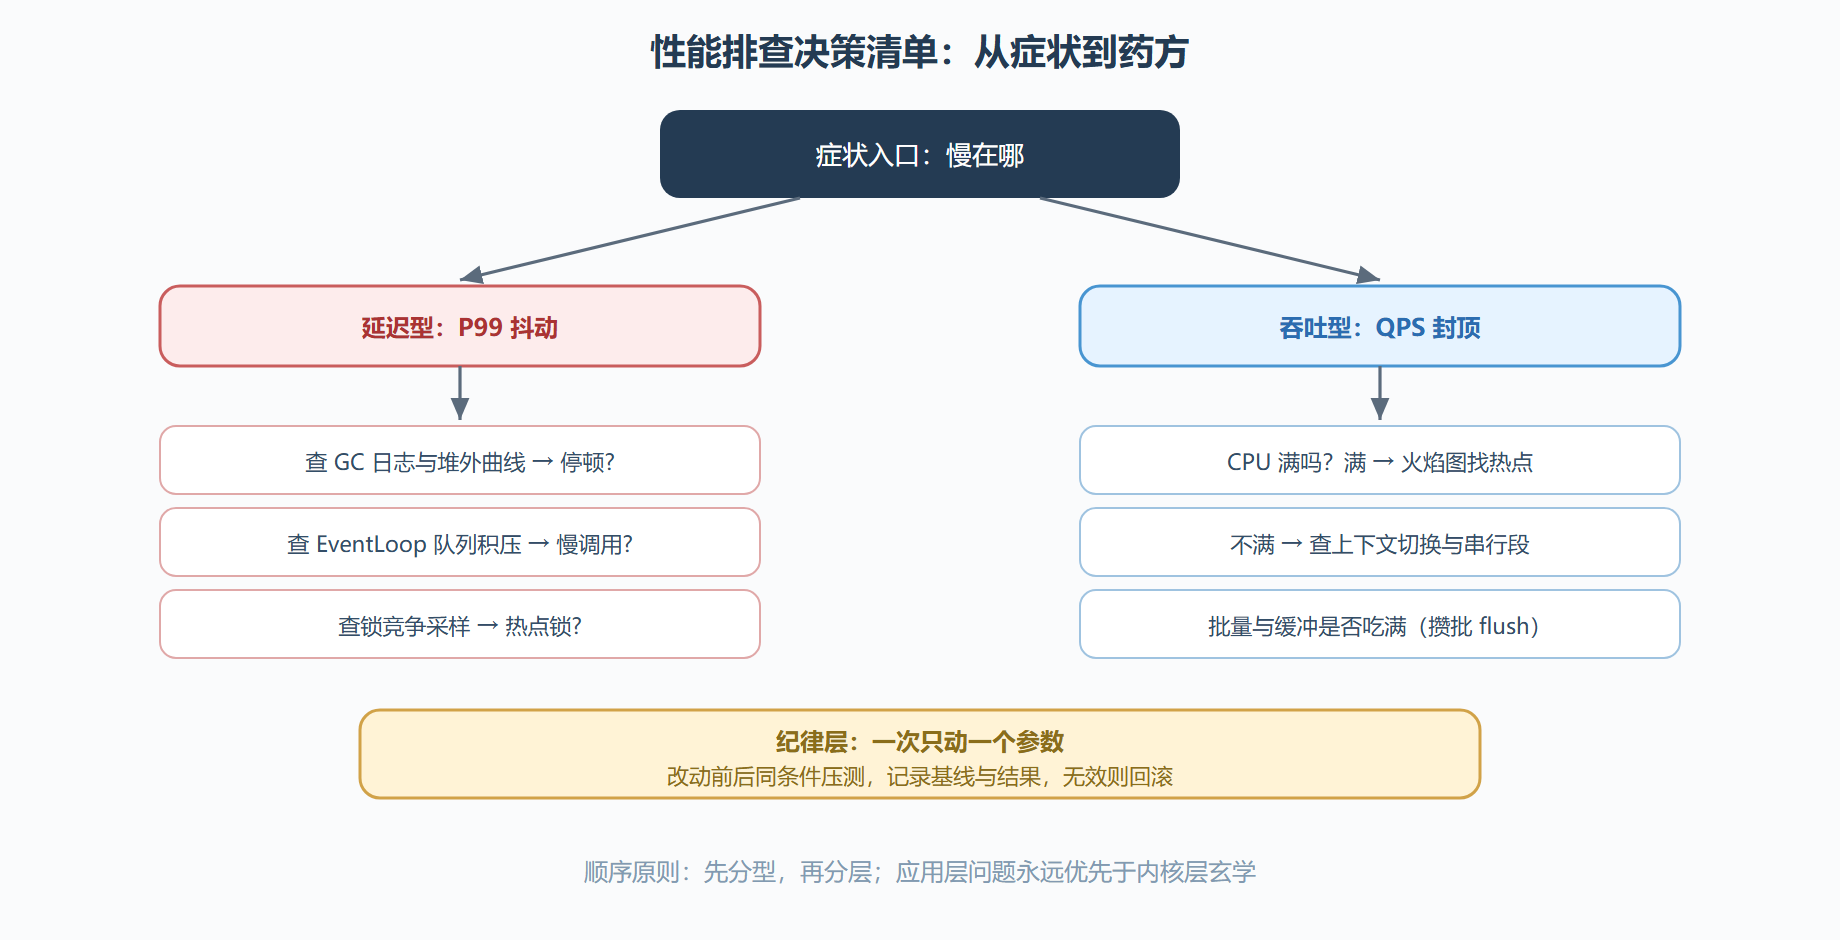
两种病的表征相反,用药也相反。延迟型:P99 抖动、个别请求超时,平均却很好;吞吐型:整体 QPS 上不去、CPU 可能没满。混淆分型是调优最大的弯路——给延迟病开吞吐药(加线程),常常越治越糟。
| 症状 | 常见根因 | 首查指标 |
|---|---|---|
| P99 尖刺、偶发超时 | GC 停顿、慢调用占用 EventLoop、锁竞争 | GC 日志、EventLoop 任务队列延迟 |
| 吞吐封顶、CPU 未满 | 锁争用、串行化瓶颈、批量不足、内核参数 | 线程状态采样、上下文切换次数 |
| 吞吐封顶、CPU 已满 | 解码效率低、拷贝过多、算法问题 | 火焰图热点 |
| 内存缓慢上涨 | ByteBuf 泄漏、队列无界积压 | 4.3 泄漏检测、堆外曲线 |
排查决策清单
二、四个维度的具体参数
应用层:解码后的业务对象复用(对象池见 4.3 的先量后改原则);日志异步化——同步日志在 20 万 QPS 下就是最大串行段;攒批发送(writeN 次 + flush 一次)对吞吐提升立竿见影。
线程层:worker 数按 6.1 的计算密度原则;业务线程池与 IO 线程隔离(6.2);上下文切换次数(pidstat -w)异常高时,优先怀疑锁竞争而不是线程数不够。
内存层:池化保持默认;PooledByteBufAllocator metric() 观察小格命中率;GC 选型上,大堆低延迟场景 G1/ZGC 的停顿优势远大于任何 Netty 参数微调。
内核层(Linux 常用项,改动需压测验证):
net.core.somaxconn=65535 与 SO_BACKLOG 取小者生效,两处要同步调 net.ipv4.tcp_max_syn_backlog=65535 半连接队列,抗连接风暴 net.core.netdev_max_backlog=65535 网卡到内核的收包队列 net.ipv4.tcp_tw_reuse=1 短连接场景复用 TIME_WAIT 端口 ulimit -n 1000000 文件描述符上限,第八章资源耗尽的主角
三、两个真实病案
病案一:P99 每隔几分钟跳一次。 GC 日志显示老年代回收停顿 300ms,与尖刺时间吻合;进一步看是解码后的大对象频繁晋升老年代。处方:消息对象瘦身(字段裁剪)+ 晋升阈值调整,尖刺消失。教训:延迟问题先看 GC,再看 Netty。
病案二:QPS 压到八万就上不去,CPU 才六成。 jstack 采样发现 worker 线程大量时间在 BLOCKED,等一把业务全局锁。处方:锁粒度从"全局 Map"缩到"分片 Map",QPS 上到二十万。教训:CPU 不满的吞吐瓶颈,八成在等待而非计算。
四、压测方法论的最低标准
- 用固定负载模型(消息大小分布、连接数、思考时间)建立基线,任何改动与基线同条件对比。
- 观察窗口足够长,至少覆盖几轮 GC 周期与定时任务周期。
- 分位数看 P99/P999 而不是平均值——平均数会撒谎。
- 每次改动做记录:参数、版本、结果,防止"调回去"时失忆。
五、压测实操:二十行代码的自制负载端
对自定义协议来说,现成压测工具(面向 HTTP 的居多)经常对不上口径,自写一个 Netty 负载客户端反而最快——顺带把前六章的知识全部用上:
public class LoadClient { public static void main(String[] args) throws Exception { int conns = 200, perConn = 5; // 200 连接 × 每连接 5 并发 EventLoopGroup group = new NioEventLoopGroup(); Bootstrap b = new Bootstrap(); b.group(group).channel(NioSocketChannel.class) .handler(new ChannelInitializer<SocketChannel>() { @Override protected void initChannel(SocketChannel ch) { ch.pipeline().addLast( new LengthFieldBasedFrameDecoder(1 << 20, 0, 4, 0, 4), new LoadHandler()); // 记延迟的工位 } }); for (int i = 0; i < conns; i++) b.connect("127.0.0.1", 8080).sync(); Thread.sleep(60_000); // 压 60 秒 group.shutdownGracefully(); } } class LoadHandler extends ChannelInboundHandlerAdapter { static final Histogram LAT = new Histogram(3600_000_000L, 3); // 纳秒直方图 @Override public void channelActive(ChannelHandlerContext ctx) { send(ctx); } @Override public void channelRead(ChannelHandlerContext ctx, Object msg) { LAT.recordValue(System.nanoTime() - start); // 记录一来一回的耗时 ReferenceCountUtil.release(msg); send(ctx); // 立刻发下一发,管道压满 } void send(ChannelHandlerContext ctx) { ByteBuf out = ctx.alloc().buffer(8); out.writeInt(4).writeInt(1); ctx.writeAndFlush(out); start = System.nanoTime(); } long start; }
跑完后取分位数:LAT.getValueAtPercentile(99) / 1_000_000 即 P99 毫秒数。三个使用要点:负载端与服务端必须在不同机器(否则压的是自己);负载端自身也要观察(客户端 EventLoop 打满时测得的是负载端上限);每连接"收到即发下一发"的管道式模型,比固定速率模型更能暴露队列积压问题——速率恒定时积压被掩盖,管道压满时积压无处可藏。
⚠️ 常见坑:在开发机上压测找"最优线程数"。开发机的 CPU、网卡、内核参数与生产完全不同,得出的数值没有迁移性;容量结论必须在同规格环境得出。
💡 关键直觉:调优清单的价值不在"照着做",而在"不漏项、不跳步"。症状分型 → 分层定位 → 单变量改动 → 压测对照,这个循环本身就是方法论,参数只是循环里的耗材。
调优清单快照
- 先分型:延迟病与吞吐病用药相反,混治必糟。
- 四层清单:应用(日志/批量/复用)、线程(隔离/切换数)、内存(GC/池化)、内核(队列/描述符)。
- GC 是延迟第一嫌疑:P99 尖刺先对 GC 日志时间轴。
- CPU 不满的吞吐瓶颈在等待:锁竞争、串行段是重点怀疑对象。
- 单变量纪律:一次一个参数,基线对照,无效回滚。
- 环境同规格:容量结论只在生产同规格环境有效。