7.3 仪表盘:指标暴露与诊断工具
7.3 仪表盘:指标暴露与诊断工具
本节摘要:车间的状态要变成看得见的数字——连接数、队列积压、内存命中率、流量字节,用 ChannelMetrics 与分配器 metric 定期采集;故障下钻靠 Arthas 的线程与调用观测、Async-Profiler 的火焰图。本节给出可落地的采集代码与两个工具的实操会话。
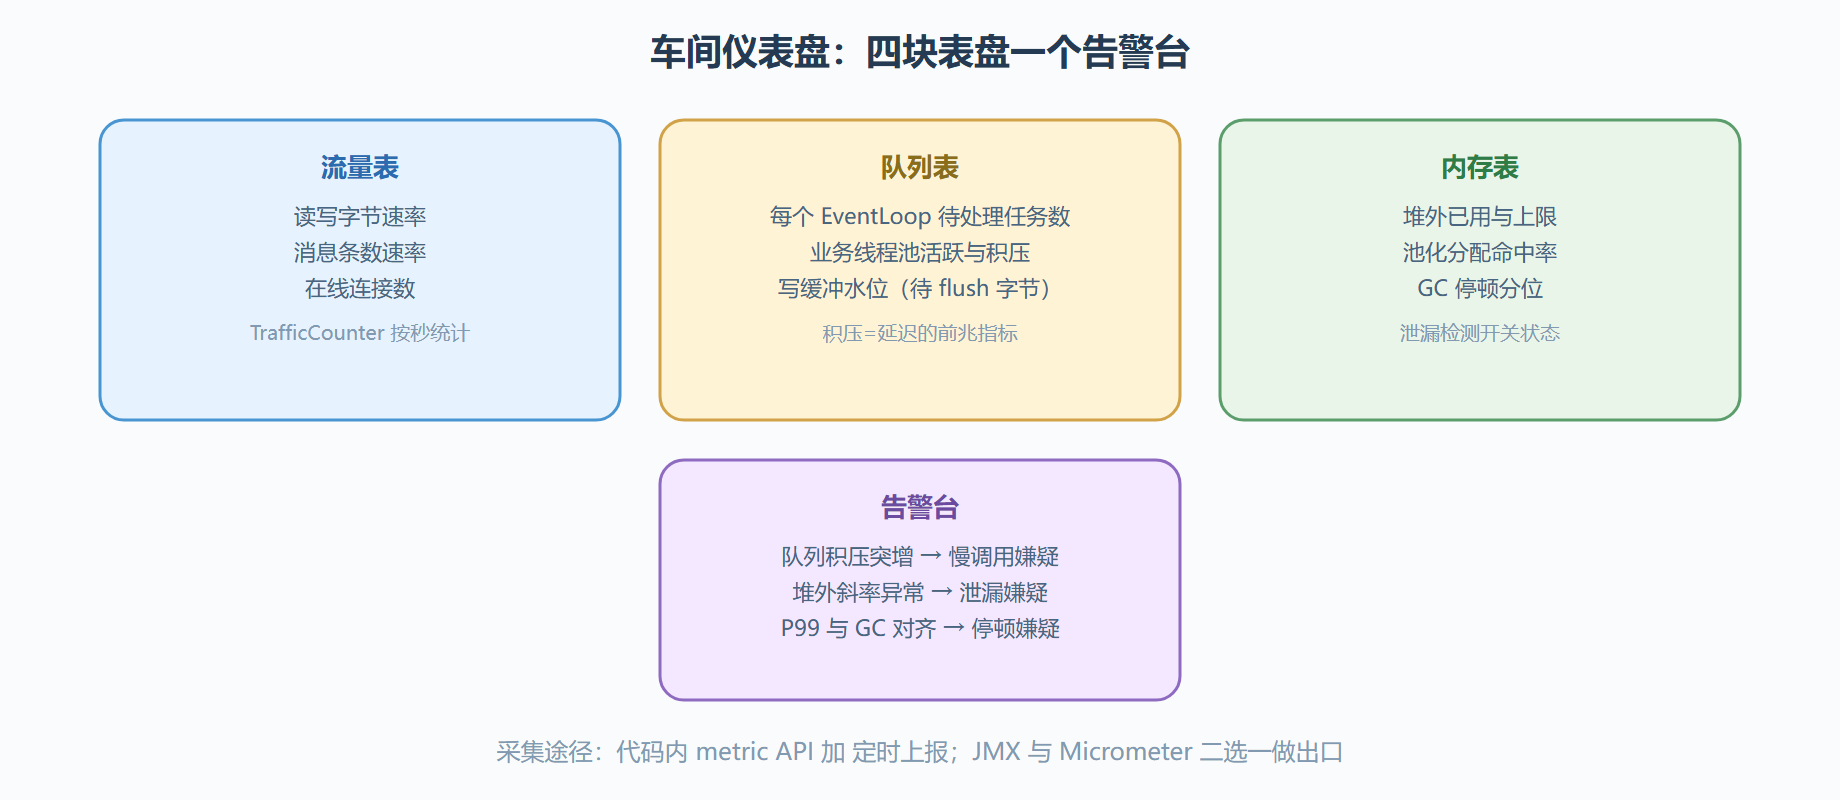
一、仪表盘上该有哪些表
二、代码内采集:三组关键数字
// 1. EventLoop 队列积压——延迟前兆,最值得盯的数字 for (EventExecutor ex : eventLoopGroup) { SingleThreadEventExecutor st = (SingleThreadEventExecutor) ex; System.out.printf("loop=%s pendingTasks=%d%n", st.threadProperties().name(), st.pendingTasks()); } // 2. 池化分配器健康度 PooledByteBufAllocator.Metric m = PooledByteBufAllocator.DEFAULT.metric(); System.out.printf("arenas=%d chunkSize=%d%n", m.numDirectArenas(), m.chunkSize()); // 3. 写缓冲水位:超过高水位会触发 channelWritabilityChanged ch.config().setWriteBufferWaterMark(new WriteBufferWaterMark(32 * 1024, 64 * 1024)); // 在 Handler 里监听背压信号 public void channelWritabilityChanged(ChannelHandlerContext ctx) { if (!ctx.channel().isWritable()) { // 对端消费慢,暂停读取或降速生产,防止内存被写缓冲吃爆 ctx.channel().config().setAutoRead(false); } else { ctx.channel().config().setAutoRead(true); } }
第三组是最容易被忽略的自保机制:TCP 对端不收数据时,内核缓冲写满会回灌到 Netty 写缓冲;不监听水位并关掉 autoRead,内存就被慢客户端悄悄吃光。这套"背压"是网关类服务的必修课。
指标出口按技术栈选:Spring 体系用 Micrometer(内建 Netty 相关 binder,接 Prometheus/Grafana 生态);传统部署开 JMX,用 Netty 自带的 MBean 注册或自己包装上述数字;最小可行方案是定时任务每十秒把三组数字打进日志,用日志平台画曲线——先有数字,再谈告警。
三、Arthas:线上下钻的瑞士军刀
Arthas 是阿里开源的 Java 诊断器,attach 到进程即可用,Netty 服务排查的常用命令组合:
$ java -jar arthas-boot.jar # 选择目标进程 [arthas]$ dashboard # 总览:线程、内存、CPU 一屏 [arthas]$ thread -n 3 # 最忙的三根线程,看是不是 worker 卡在业务 [arthas]$ thread --state BLOCKED # 锁竞争直接点名 [arthas]$ watch com.x.BizHandler handle '#cost>200' # 只打印耗时超 200ms 的调用 [arthas]$ trace com.x.BizHandler handle -n 5 # 方法内部耗时分解 [arthas]$ vmtool --action getInstances --className \ io.netty.channel.SingleThreadEventExecutor # 直接摸到 EventLoop 实例查队列
典型会话:dashboard 看到 worker 线程 CPU 高 → thread -n 3 定位具体线程 → trace 分解出热点在某个同步调用 → watch 确认耗时分布 → 回到代码修复。全程不用重启、不用改代码,这对"不敢乱动"的生产服务是降维打击。
四、Async-Profiler:把 CPU 画成火焰图
Arthas 看"点",火焰图看"面"——整个进程的热点分布一眼扫出宽窄:
$ asprof -d 30 -f flame.html <pid> # 采 30 秒 CPU 火焰图 $ asprof -e alloc -d 30 -f alloc.html <pid> # 也可以采分配热点
读图要领:横向宽度是 CPU 占比,纵向是调用栈深度;Netty 服务里先找两样东西——业务栈里异常宽的解码/序列化段(算法问题)与不该出现的等待段(锁或 IO)。alloc 模式则直指 4.3 的内存问题:哪个工位在疯狂申请对象,图上一目了然。
⚠️ 常见坑:生产环境开全量 trace 类诊断(watch 范围过大、profiler 采太长),自身开销把服务拖垮。诊断动作要限时限范围,采完即撤。
💡 关键直觉:监控与诊断是同一件事的两半——仪表盘告诉你"哪里不对",工具告诉你"为什么不对"。先用低成本常驻指标圈定范围,再用一次性重工具下钻,顺序别反。
给指标出口补一个最容易起步的落点:定时任务每十秒把三组数字(连接数、各 EventLoop 的 pendingTasks、堆外已用)打成一行结构化日志,日志平台按字段画三条曲线。这个方案没有引入任何新组件,却能覆盖七成日常巡检——先让它跑一周,你自然会知道第二个该接的指标是什么。告警阈值也从曲线里来:取平稳期峰值的 1.5 倍起步,再按误报率微调,拍脑袋定的阈值只会训练大家忽略告警。
仪表盘速记
- 四块表盘:流量、队列、内存加告警台,先有数字再谈告警。
- 队列积压是延迟前兆:pendingTasks 突增先于用户可感知的变慢。
- 背压三件套:写水位、isWritable、autoRead 开关,防慢客户端吃爆内存。
- 指标出口:Micrometer、JMX、日志三档,按技术栈选最小可行方案。
- Arthas 组合拳:dashboard 圈范围、thread 定线程、watch/trace 定耗时。
- 火焰图看宽窄:宽栈是 CPU 热点,等待段是锁与 IO 嫌疑;生产诊断限时限范围。