2.2 Broker:无状态的调度台
2.2 Broker:无状态的调度台
本节摘要:Broker 是 Pulsar 里最像"服务员"的组件:点单都经过它,菜却出自后厨。本节拆开它保持无状态的手段——主题所有权与 Bundle 分片机制,看负载如何自动均衡、宕机如何秒级接管,并用一次手动的流量迁移演练验证这些机制真的可控。
无状态是个动词,不是形容词
说 Broker 无状态,不是说它内存里什么都没有——它有缓存、有连接、有正在处理的请求。这句话的准确含义是:Broker 不持有任何"离了它就找不回来"的信息。消息字节在 Bookie 上,主题归属在元数据存储里,消费进度(游标)也由存储层保管。Broker 本地的一切,丢了就丢了,换台机器照常营业。
这带来一个反直觉的推论:Pulsar 里"某台 Broker 负责某个主题"不是部署时写死的配置,而是运行时争来的临时差事。Broker 启动时向名册官报到,从元数据里认领属于自己的主题分片;它宕机时,别的 Broker 会发现名册上这些分片没了主人,重新竞领。主题所有权是流动的,这正是整个集群弹性的发动机。
一、Bundle:把命名空间切成负载的调度单元
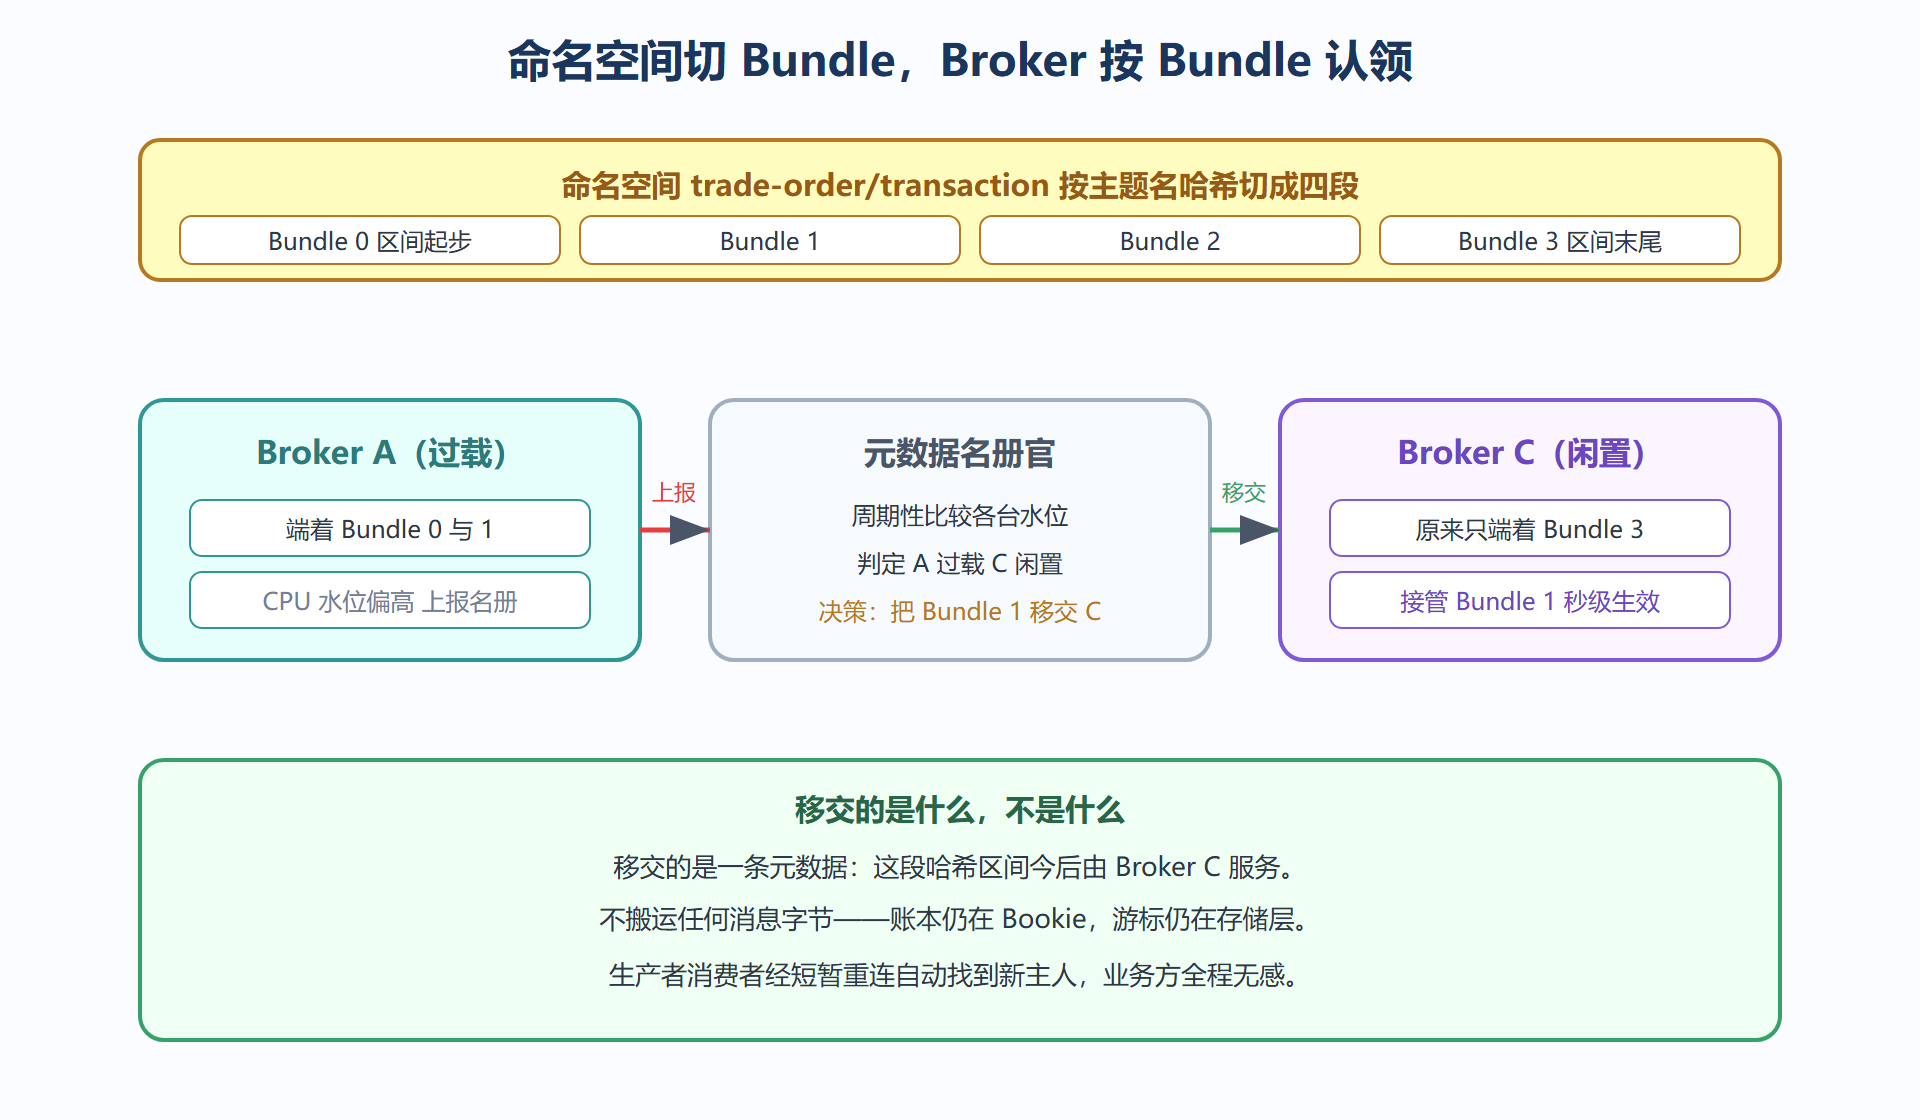
如果以"主题"为单位调度,超大集群里几百万个主题的归属信息会压垮元数据,粒度也太碎。Pulsar 的办法是把每个命名空间预先切成若干 Bundle( bundles,归属分片)——一个命名空间按主题名的哈希范围切成一簇 Bundle,比如切成四片,每片覆盖一段哈希区间。Broker 认领的最小单位不是主题,而是 Bundle:一个 Bundle 同一时刻只归一台 Broker 服务,一台 Broker 可以同时端着很多 Bundle。
这个设计的妙处在于把"负载均衡"变成了可计算的搬运问题:Broker 周期性上报自己的 CPU、流量、内存水位,名册官看到某台机器过载、某台闲置,就把几个 Bundle 从前者卸载(unload)、移交给后者。移交的只是"这段哈希区间归你了"的一条元数据,消息字节原地不动。生产者按消息键哈希找到 Bundle,重新查到新的服务 Broker,连接切过去,整个过程秒级完成。
图 2-2 Bundle 归属与 Broker 负载均衡
二、宕机接管:一次可以自己做的演练
机制听得再多,不如亲手按一次。单机或测试集群上做这个演练:先看当前 Bundle 归属,然后手动把某个 Bundle 卸载,观察它落到另一台 Broker——本地演练时虽然只有一台 Broker,卸载重挂的日志同样能看到完整流程。
# 查看命名空间的 Bundle 分布:谁服务哪些分片 $ pulsar-admin namespaces bundle-dump trade-order/transaction --sorted # 输出示意: # Bundle 0x00000000-0x40000000 -> broker-1:6650 (topics: 3) # Bundle 0x40000000-0x80000000 -> broker-1:6650 (topics: 5) # 手动卸载一个 Bundle:模拟一次"驱逐",Broker 会重新分配它 $ pulsar-admin namespaces unload trade-order/transaction \ --bundle 0x40000000-0x80000000 # 再次查看:该 Bundle 已被重新挂载(单机是重挂回本机,集群则可能换台机器) $ pulsar-admin namespaces bundle-dump trade-order/transaction --sorted
演练里能观察到的细节值得回味:卸载期间发往该 Bundle 的生产请求会短暂收到查找重定向,客户端 SDK 自动重试后恢复;已写入的消息一条不少——因为字节从来没在 Broker 身上。真实故障场景(进程崩溃、机器失联)与这个演练的差异只在"谁发起移交":演练是你手动,故障是其他 Broker 通过名册官的存活探测自动触发。
三、调度台上的日常事务
除了认领与移交,Broker 还处理这些日常:查找服务——客户端首次访问主题时,Broker 告诉它"这个主题归哪台机器",必要时返回重定向;流量整形——按命名空间的发布与消费限速策略对请求限流,防止一个租户冲垮共享集群;游标管理代理——消费者的确认最终由 Broker 转记到存储层,第 3 章确认机制里会展开。把这些事务连起来看,Broker 的一天就是:接客、查表、转发、报水位,偶尔搬家。
💡 关键直觉:判断一个消息系统扩容时的痛感,就问它"搬什么"。搬数据的系统,扩容是工程;搬元数据的系统,扩容是事务。Pulsar 把扩容做成了事务。
热点时刻:调度台也会手忙脚乱
无状态不等于无烦恼,调度台最经典的麻烦是热点主题:某个明星主题的流量是其他主题的成百上千倍,而 Bundle 是哈希区间——热点主题无论落在谁的辖区,那台 Broker 都要独自扛下这股洪峰。负载均衡器看到的是"这台机器水位高",它只能把别的 Bundle 从这台机器挪走,却挪不动热点本身——机器被腾空了,洪峰还在。
工程上处理热点有明确套路。第一优先是分区分洪:把热点主题改成多分区,流量摊到多个 Bundle 辖区,多个 Broker 一起扛——这也是大促前把核心订单主题提前扩分区的机制依据。第二是读写隔离:热点主题的读写走专属的 Broker 配置标签,普通主题不让与明星混台。第三才是扩 Bundle:调大命名空间的 Bundle 数,让哈希区间更细,负载分散更均匀。顺序不能反——先想分洪,再想搬家,最后才是加机器。
这套套路的底层认知值得留一句:负载均衡解决"均匀",分区解决"扛量",两者是不同维度的问题。看到某台 Broker CPU 飙高就盲目加机器的团队,往往加完发现瓶颈跟着主题走,机器加了洪峰没散——先看流量分布,再动资源,这条纪律在第 6 章的排错套路里还会再强调。
本节要点回顾
- Broker 无状态的准确含义:不持有"离了它找不回来"的信息;
- Bundle 是负载调度的最小单元,命名空间按哈希区间切分,Broker 按 Bundle 认领;
- 负载均衡 = 名册官根据水位改写 Bundle 归属,字节零搬运;
- 宕机接管是 Bundle 移交的自动化版本,客户端靠重试无感恢复;
- unload 命令让你能手动演练这套机制,值得在测试集群做一遍。
下一站进货仓:字节最终住进 BookKeeper 的账本里,那个账本如何摊到多台机器、如何容错,是本站要拆的机械表。