5.1 取指与译码:从字节到微操作
5.1 取指与译码:从字节到微操作
本节摘要:解码车间的大门工序。本节沿硬件视角重走 3.4 节你手工走过的路:取指工位如何按程序计数器捞字节、变长指令流如何断句、字段如何并行抽取,以及现代 x86 前端的杀手锏——把复杂指令翻译成类 RISC 微操作、再用微操作缓存绕过重复译码。读完你应当能解释"x86 内瓤是 RISC"这句话的硬件含义。
字节的接收流程
取指工位的工作看起来平凡:拿着程序计数器里的地址,去一级指令缓存里捞一块字节回来。平凡之下有两件事决定了整个前端的形态。
第一件是抓多少。流水线要持续有料,取指必须一次抓一把(典型 16 到 32 字节的取指窗口)。定长指令流(如无压缩扩展的 RISC-V)抓起来心旷神怡:窗口边界永远对齐指令边界,一把就是固定条数。变长指令流(x86)则连"这一把有几条指令"都要算——窗口可能切在某条指令中间,头部半条、尾部半条都得妥善处理。第二件是从哪抓。顺序执行时程序计数器自动推进,遇到跳转则听 5.3 节的预测器指挥;预测器给出候选地址,取指照单抓取,抓错了再推倒重来。
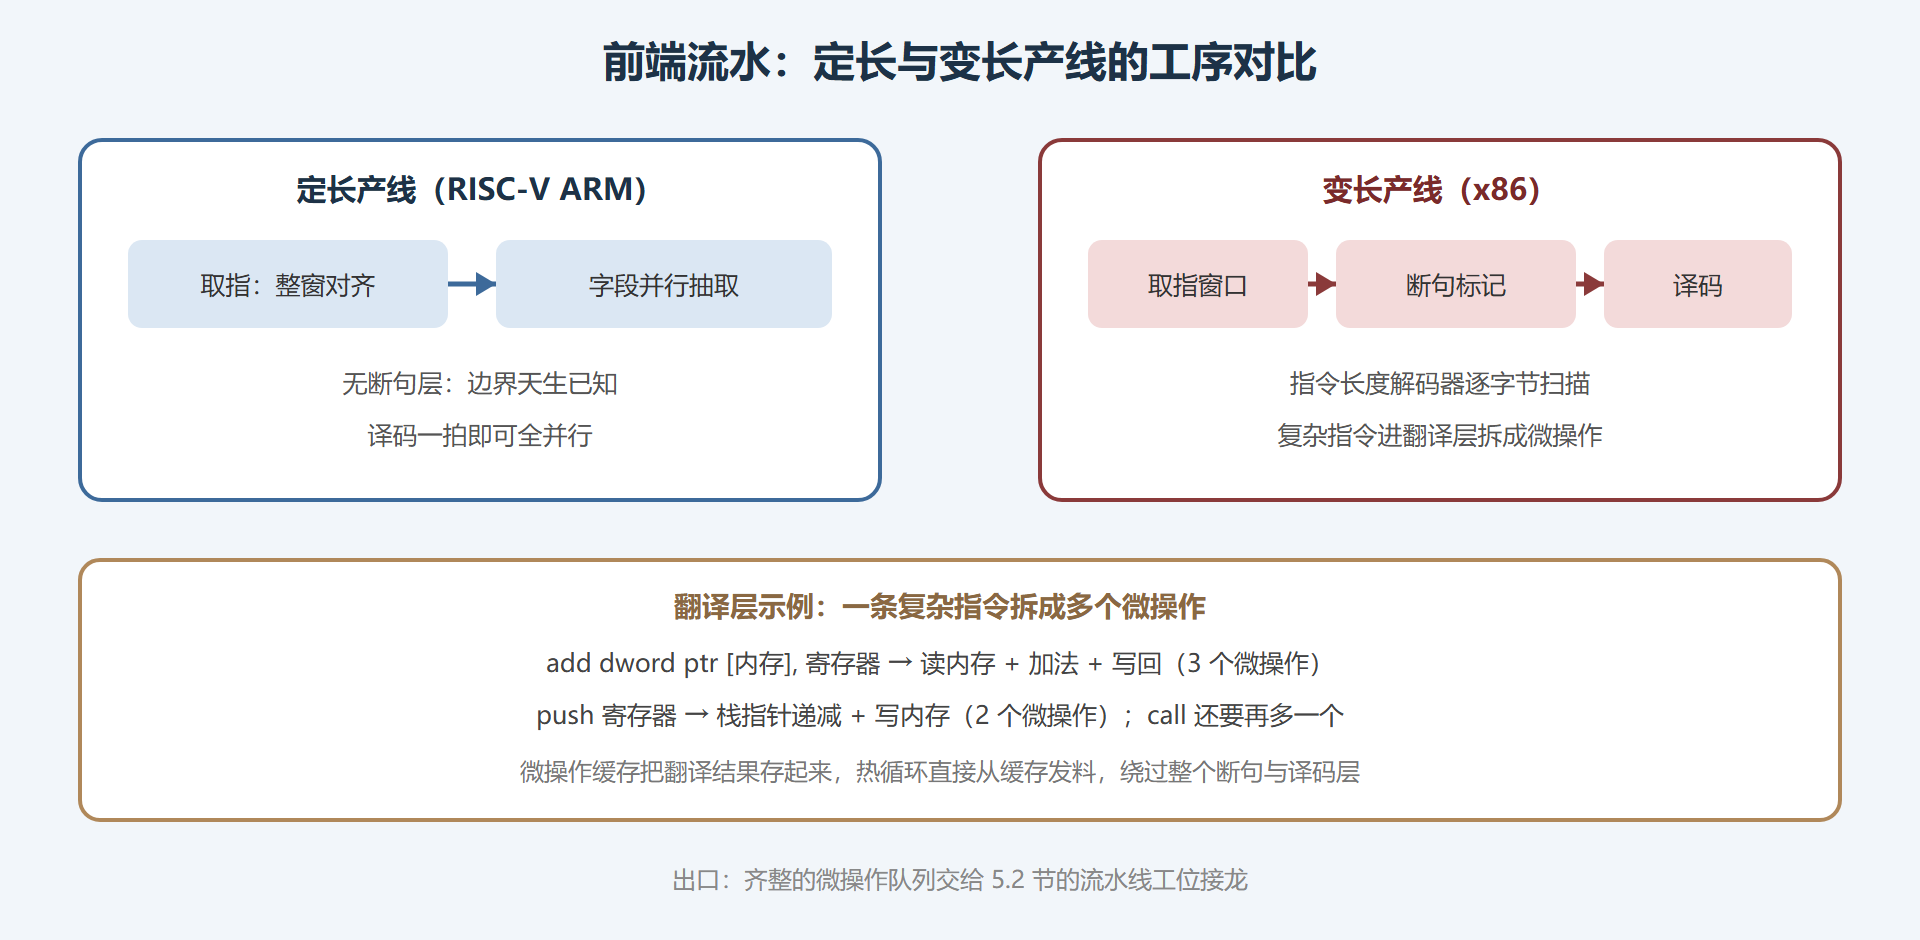
**断句是变长产线的独有负担。**x86 前端里专门有一级叫指令长度解码器(predecode),逐字节扫描取指窗口,给每个字节打上"指令起始"标记。这一步是纯串行的苦活:当前指令的长度要等它的前缀与操作码读完才知道(3.1 节的断句问题在此兑现成硬件电路)。工程界试过各种提速手段——按可疑切点并行试探、用历史信息辅助猜测——但断句始终是 x86 前端最深的护城河,也是它高频下不去的主要原因之一。定长产线完全跳过这一层,字段抽取可以与取指同时展开。
**拆字段是解码车间的装配逆向。**拿到边界清晰的指令,译码器按格式表并行切出操作码、寄存器号、立即数——你在 3.4 节手工做的五步(拆语义、选格式、清点字段、拼接、定稿),硬件用并行的位切片电路一步完成,因为格式表就是按"字段位置固定"设计的。这也是第 3 章反复强调正交性的回报:格式规整,解码电路就便宜。
图 5-1:从前端到微操作队列的两条产线
翻译层:复杂指令的减负车间
译码的真正重头戏是微操作翻译。现代 x86 核心后端只执行一种齐整的类 RISC 微操作(μop),前端的职责就是把千姿百态的 x86 指令统一翻译过来。简单指令(寄存器加法、立即数传送)一对一通过;复杂指令则一对多拆解——带内存操作数的加法拆成读、算、写三个微操作;push 拆成栈指针递减加写内存;字符串扫描这类老古董甚至要拆成一串微序列。这套翻译正是 1.4 节"Pentium Pro 自赎"与 1.3 节"契约外自由发挥"的交汇点:对软件,指令语义分毫不变;对后端,拿到的是规整的 RISC 式工单。
两个由此而生的工程装置值得记住。一是宏融合:把"比较 + 条件跳转"这对黄金搭档在译码时合成一个微操作,省一次发射——它证明前端的 fusion 空间同样宝贵。二是微操作缓存:翻译结果按指令地址存进一个小缓存,热循环第二次进门就直接从缓存发料,整个断句与译码层被绕开。性能分析工具里看到的"前端受限"与"后端受限"的分野(第 8 章工具链话题会用到),分界线就画在微操作缓存的出口上。
容易踩的坑
第一个坑:以为"复杂指令一定慢"。翻译层的存在让"一条 x86 指令拆几个微操作"成为性能的真实量纲——有的看起来朴素的指令(读改写内存型)要拆三个微操作,有的看起来花哨的指令反而一对一。数微操作而非数指令,是读汇编数性能的第一课;具体指令的微操作数随微架构代际变化,权威来源是各家的优化手册。第二个坑:把微操作缓存当成万能护身符——它容量有限,冷代码、大循环体照样要走完整前端;自修改代码(运行中改写指令)还要求架构维护指令缓存与数据缓存的一致性(RISC-V 用 fence.i 显式同步),热路径上这可不是免费的。第三个坑属于内核与工具开发者:断句歧义(同一段字节从中间开始解读出另一套指令)意味着反汇编器的输出取决于起始对齐——线性扫描与递归下降两类反汇编算法的差异、以及逆向工程中的对齐攻击面,全部源于此。语义上这并不可怕(合法程序流只会从真实边界进入),但工具必须按真实边界走才不会自欺。
前端带宽的账本
前端的一切设计都为了回答一个问题:每拍能给后端喂多少条微操作?拿账本算一算。取指窗口每拍 16 到 32 字节;x86 的典型代码平均指令长约 3.5 字节,窗口理论上能装 4 到 8 条;但断句与译码各占一拍,加上翻译层的不可预知性,实际稳态供给往往打折——前端受限的负载(超长依赖链上的短指令流、宏密集的字符串处理)就是在这里卡脖子。定长产线的账本好看得多:RISC-V 无压缩时 16 字节窗口稳定装 4 条,压缩后装 8 条,且字段抽取与取指同拍完成。微操作缓存的作用在账本上看得最清楚:命中时前端的账本整页作废,按缓存的吞吐直接发料——这也是为什么热循环的基准成绩常常远高于冷代码。
给性能分析留一个接口:剖析工具里的前端停顿占比,对应的就是这本账上的缺口。看到"前端受限",对策按序检查——热循环是否超过微操作缓存容量、是否踩进长前缀的罕见指令、取指对齐是否被跳转打碎。前端问题几乎都长着相似的脸,但药方各不相同。
常见疑问
问:同一段代码在两家 ISA 上的"指令数"能直接比吗?不能,得换算成微操作数与供给带宽。x86 的一条读改写指令在后端是三个微操作,RISC-V 是一条加载加一条运算加一条存储三条简单指令——表面 1 比 3,后端负载近似 3 比 3。指令数的观感差异在微架构账本上经常归零,这正是 2.1 节"流派之争退位于实现之争"在解码端的实锤。
问:为什么不定长产线也加个"翻译缓存"一劳永逸?微操作缓存就是它,但容量与功耗的账算不过来:缓存命中率高依赖热代码集中,而通用负载的指令足迹庞大;每拍查询缓存的功耗也不可忽略。它是缓解手段,不是定长产线的等价物——否则 x86 早就没有前端功耗劣势了。
本节要点回顾
- 取指抓整窗、断句定边界:定长产线边界天生已知,变长产线要指令长度解码器逐字节扫描——这是 x86 前端的结构性负担。
- 字段抽取是 3.4 节手工装配的电路化,格式正交与否直接决定解码电路的造价。
- 翻译层把复杂指令拆成类 RISC 微操作,软件语义不变、后端负载齐整;"x86 内瓤是 RISC"说的就是它。
- 宏融合与微操作缓存是前端省力的两大装置,热循环的性能上限由后者托举。
- 数性能要数微操作不数指令;断句歧义是工具与安全领域的真实议题。