5.2 流水线工位与冒险
5.2 流水线工位与冒险
本节摘要:流水线是处理器吞吐的第一台发动机:把一条指令的加工切成工位,让多条指令在不同工位上重叠推进。本节画清五级经典流水线的时空图,然后把三类冒险——工位冲突、数据未备、去向未知——逐一摆上台面,讲透前递网络与停顿的分工。读完你应当能对任何一小段汇编,手工推演它在流水线上的推进与堵点。
工位接龙与排队问题
洗衣店的比喻百试不爽:洗、烘、叠三道工序,一批洗完再烘的串行模式下,三批衣服要九个时段;流水化后每个时段都有衣服在不同工序上,三批只需五个时段。处理器同理:把一条指令的加工切成取指、译码、执行、访存、写回五个工位,理想情况下每个时钟周期都有一条指令完成——虽然单条指令的延迟没变,吞吐却翻了数倍。工位切得越细(超流水线),主频理论上越高,但每个工位的持有时间越短,一旦堵车代价也越大——这就是 2000 年代主频竞赛的流水线逻辑,也是后来转向多核与加宽发射的原因之一。
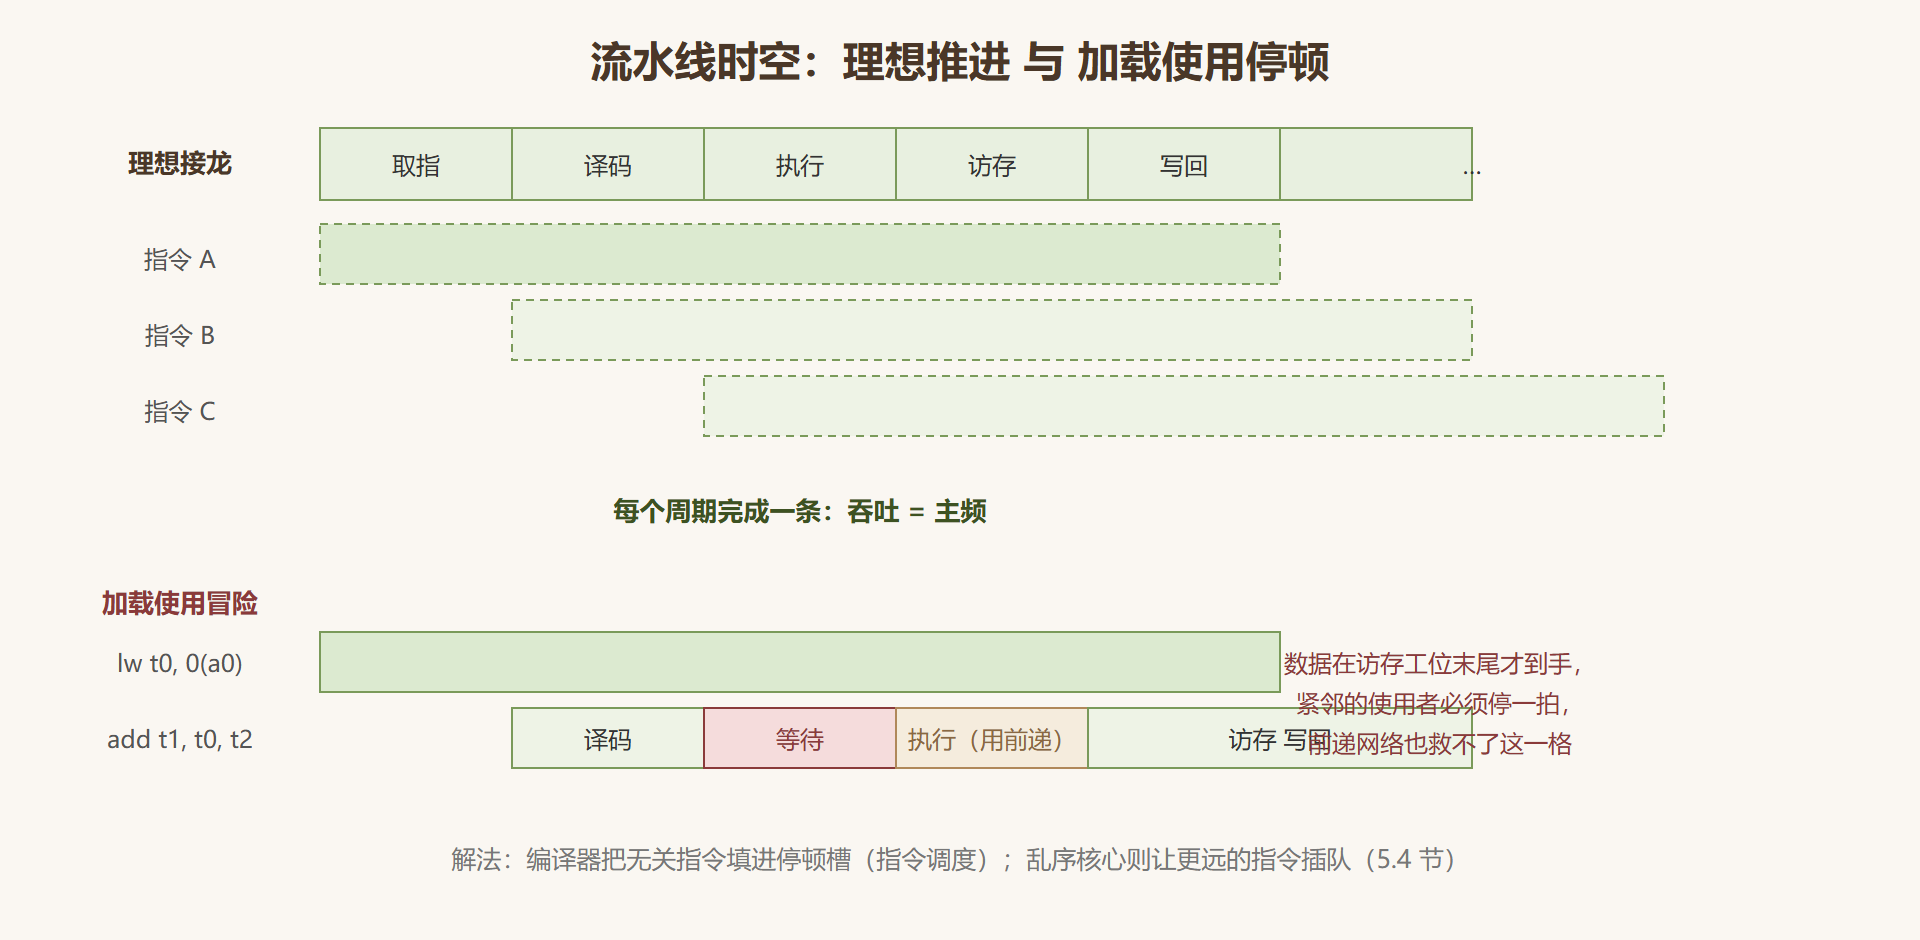
用时空图看接龙。四条互不相关的指令在五级流水线上的理想推进:
周期 → 1 2 3 4 5 6 7 8 指令 A 取 译 执 访 写 指令 B 取 译 执 访 写 指令 C 取 译 执 访 写 指令 D 取 译 执 访 写
从第四周期起,每个周期完成一条。理想的接龙建立在一个脆弱假设上:工位之间互不干扰、后一条不需要前一条的结果、每条指令的去向都已知。三个假设各有塌法,对应三种冒险。
图 5-2:五级流水线时空图与加载停顿
三种冒险与各自的解法
**结构冒险:工位本身冲突。**两条指令要同时用同一个部件——经典案例是取指与访存都抢一个内存口。解法是加资源:指令与数据缓存分开(哈佛化的缓存布置)、执行单元加倍。结构冒险最"物理",钱能解决的都算便宜。
数据冒险:原料没到位。后一条指令要用前一条的结果,而结果还在流水线半空。真正的依赖(写后读)没法消除,只能加速:前递网络(旁路)把执行工位刚出炉的结果直接送到下一条指令的入口,不等写回落账。大多数依赖靠前递零成本化解,唯一的大例外是加载使用冒险——数据要等访存工位结束才到手,紧邻的使用者无论如何要停一拍。编译器的对策是指令调度:把无关指令填进停顿槽;乱序核心的对策更彻底,让后面不相干的指令插队先走(5.4 节)。顺带分清另两种"假依赖":写后读名(WAR)与写后写(WAW)不是真的数据流,只是寄存器名字被复用——它们在乱序核心里被寄存器重命名整个消灭,这正是 5.4 节重命名的第一功。
**控制冒险:去向未知。**分支与跳转让"下一条取哪"成了未知数,流水线前端只能先猜(分支预测),猜错就把已进入流水线的错误路径全部冲掉,重灌正确的——代价正比于流水线深度,深流水线上一次猜错能烧掉十几个周期。控制冒险是三种冒险里最贵的,值得整节细讲,它就是 5.3 节的主题。
加宽:每个周期完成不止一条
五级流水线的理想吞吐是每周期一条,现代核心早已突破:前端每个周期取指并译码 4 到 8 条,多条并行流水线(超标量)让执行工位成排开张。加宽与加深是吞吐的两根轴——加宽吃并行度(程序得有足够多互不相关的指令填满每个周期),加深吃主频(工位更细、周期更短)。乱序执行与超标量天然是一对:乱序负责"找到能并行填空的指令",超标量负责"给它们足够的工位"。本节只需记住这个分工图景,5.4 节再进乱序的内部。
容易踩的坑
第一个坑:把"流水线级数"当性能指标。级数多不等于快——深流水的主频优势要拿分支猜错代价与功耗来换,奔腾四代的深流水教训至今是反面教材;现代设计在深度与宽度间反复权衡,看芯片要结合工艺与负载,不能只数工位。第二个坑:以为停顿槽在乱序核心上不存在。乱序执行确实能把远处指令拉来填空,但填空的前提是"有远处的独立指令可填"——关键路径上全是依赖链时,停顿照样发生,所以手写优化循环时把独立计算交织进依赖链(软件流水)依旧有效。第三个坑属于读反汇编的人:看到"加载后紧跟使用"就断言一定停顿,忽略了乱序核心会用调度窗口里的其他指令遮盖它——静态数周期只在特定微架构模型下才准,精确数据要靠性能计数器实测(第 8 章工具链的话题)。
冒险现场的三段推演
把三类冒险放进同一段代码做一次完整推演,体验硬件调度员视角。设有如下序列(假设五级流水线,加载延迟一拍,无乱序):
lw t0, 0(a0) # ① 加载:延迟一拍 add t1, t0, a1 # ② 依赖 ①:加载使用冒险 mul t2, t1, a2 # ③ 依赖 ②:连续依赖链 xor t3, a3, a4 # ④ 独立 sw t2, 4(a0) # ⑤ 依赖 ③
推演时间线:①在第三周期末出结果,②的前递通道把它直接送进执行工位,看似无缝——但加载的结果要等访存工位结束才可用,②若在④之后才发射,停顿槽就被④填满;③挂在②后面成为关键路径的下一环;⑤等 mul 的结果,多周期乘法的延迟又被 xor 之后的独立指令遮盖。整段代码的完成时间由两条链的较大者决定:lw→add→mul→sw 的依赖链,与 xor 的短支路。推演的结论与本节开头互相印证:优化就是给停顿槽找住户——静态调度找编译器,动态调度找保留站,本节的手工推演让你能预判他们都会怎么排。
常见疑问
问:分支预测失败与数据冒险哪个更贵?量级不同。数据冒险的停顿以拍计(前递后多数一拍以内),分支猜错的冲刷以十几拍计。这也是为什么编译器对"填停顿槽"尽力而为、对"减少分支"不遗余力(循环展开、无分支代码序列、条件传送指令)——贵的优先治理。
问:既然有乱序执行,学静态流水线还有意义吗?有,而且比以前更有意义。乱序核心的保留站大小有限(几十到两百多条目),超出的部分仍然按序排队;关键路径的依赖链无论怎么乱序都在那里。理解静态流水线才能理解乱序的收益边界在哪——它是"填空机制的升级",不是"物理规律的豁免"。
本节要点回顾
- 流水线用重叠换吞吐:单条延迟不变、每周期完成条数上升;加深吃主频、加宽吃并行度。
- 三种冒险:结构冒险加资源,数据冒险靠前递与调度,控制冒险靠预测——最贵的是控制。
- 前递化解绝大多数写后读依赖,唯独加载使用冒险必停一拍,是编译器调度与乱序执行的主战场。
- 假依赖(写后读名、写后写)由寄存器重命名消灭,这是乱序执行的第一步。
- 数性能看微操作与依赖链,不看指令条数;静态推算要指明微架构模型,精确值靠计数器。