8.1 x86 与 x86-64:变长编码的活标本
8.1 x86 与 x86-64:变长编码的活标本
本节摘要:展厅一号展台。x86 是兼容包袱最重、也最成功的指令集:1978 年的编码骨架至今在跑。本节用一条真实指令做逐字节解剖,把 3.2 节的五层地层与 3.3 节的 ModRM 机制收拢成完整画像,再讲 64 位化的惊险一跃与"包袱变护城河"的商业逻辑。读完你应当能独立拆解任何一条中等复杂度的 x86-64 指令。
展台一:变长编码的四十年活标本
x86 的画像用四把尺子量出来是这样:编码格式,变长、前缀叠罗汉;访存立场,CISC 血统、算术指令可直接吃内存操作数(内部拆成微操作,5.1 节);门禁体系,四环模型加 MSR 面板,虚拟化靠根模式加层(7.3 节);扩展方式,前缀借地皮(3.2 节)。四个读数彼此咬合:正因为变长编码有前缀这个"软性伸縮节",四十多年间的新特性才都有地方安放——这是理解 x86 一切的钥匙。
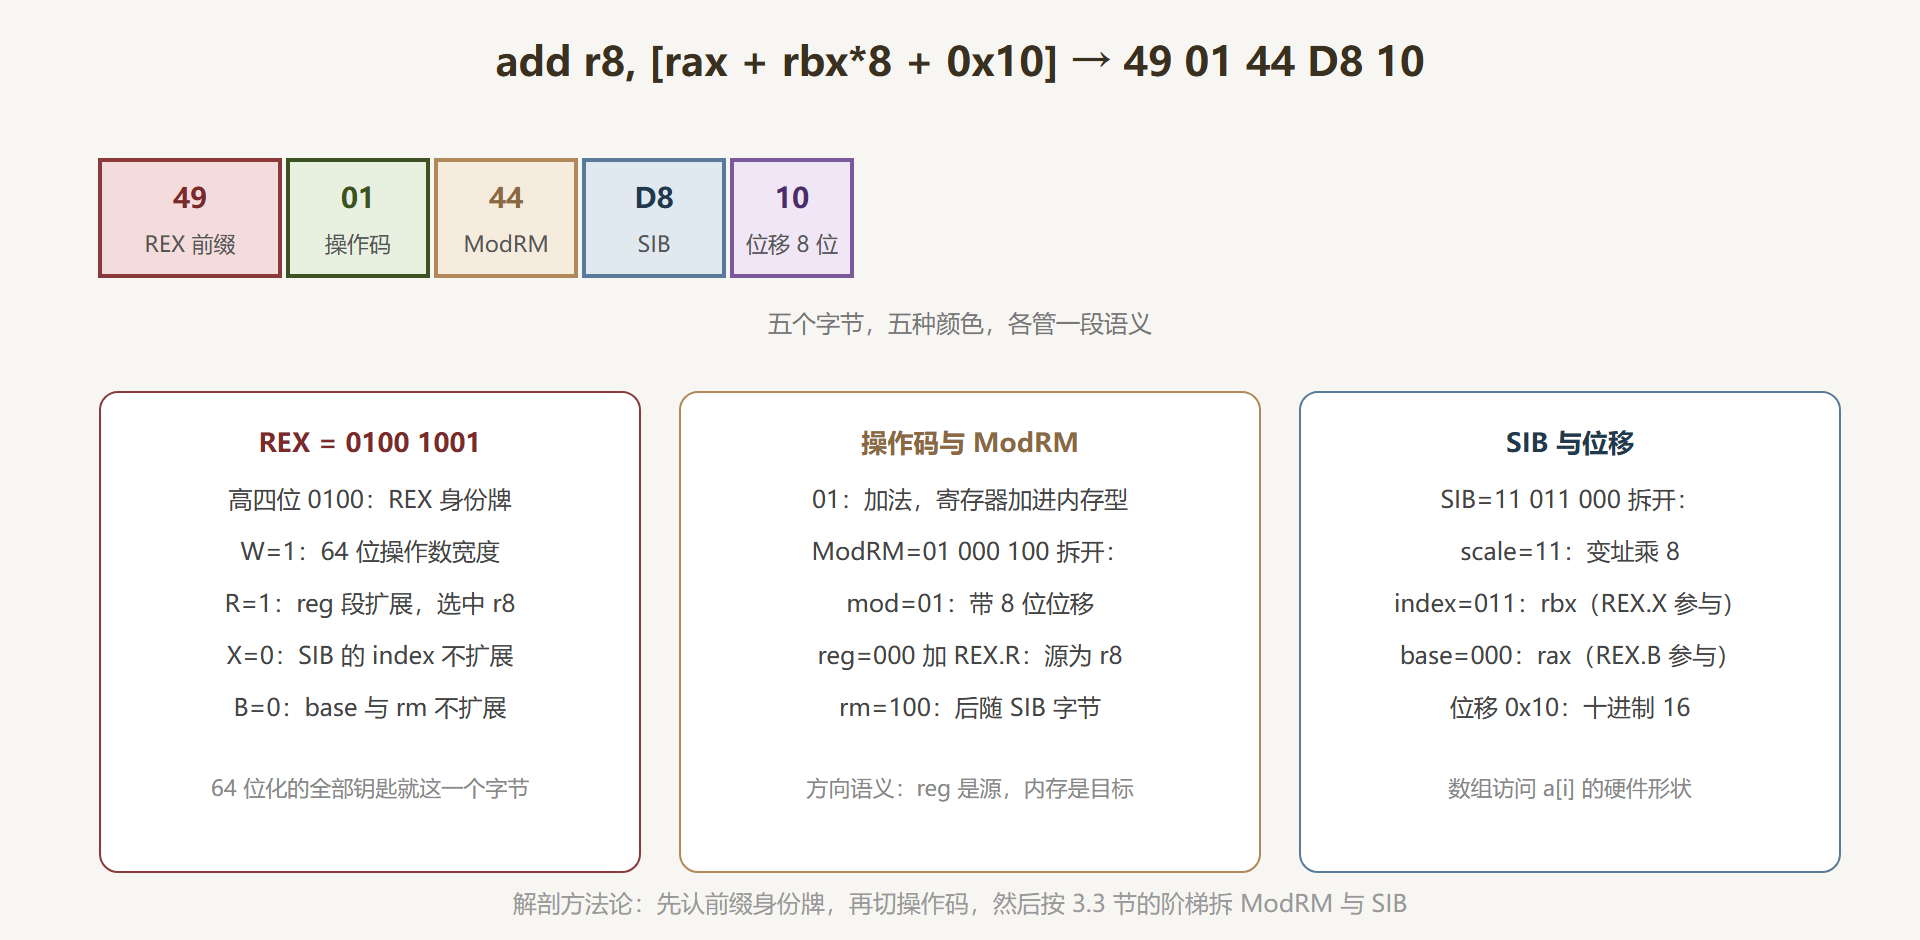
先解剖一条真实指令,把全部零件一次看全。目标语义:add r8, [rax + rbx*8 + 0x10](r8 加上一个内存操作数)。完整编码五个字节:49 01 44 D8 10。
图 8-1:一条五字节指令的字段全景
再练一次:八字节指令的逐位拆解
五字节样本的位移只有 8 位,这次把 32 位位移也用满。目标语义:mov rax, [rcx + rsi*4 + 0x1234](把一个四倍变址寻址的 64 位数搬进 rax)。编码八字节:48 8B 84 B1 34 12 00 00。逐字节断句——48 是 REX(W 置位定下 64 位宽度,R、X、B 全零:reg、index、base 都不扩展);8B 是"寄存器取自内存"方向的 MOV 操作码;84 是 ModRM,二进制 10 000 100:mod=10 声明后随 32 位位移,reg=000 配合 W 位指定目标 rax,rm=100 声明后随 SIB;B1 是 SIB,二进制 10 110 001:scale=10 即乘 4,index=110 选 rsi 作变址,base=001 选 rcx 作基址;末尾的 34 12 00 00 是小端序的 0x1234。与开头的五字节样本对照,这条指令贵在位移从 8 位升到 32 位——寻址模式一动,指令长度跟着动,变长编码的本色在此。建议合上教程先自己把这条指令的字段拆一遍再回来对答案:第 3 章的手艺只有手过一遍才算数。
地层与年轮:兼容包袱的两面
8.1 的画像再叠上 1.4 节的时间轴,年轮就齐了:8086 的十六位骨架(含段式寻址的遗产)、80386 的 32 位保护模式(0F 逃生门开张、四环与分页上岗)、奔腾时代的 MMX 与 SSE(SIMD 货架开张,2.4 节)、AMD 的 x86-64(REX 前缀一 byte 定乾坤,顺手砍掉八个一字节编码腾位置,3.2 节提过)、近年的 AVX-512 与 APX(EVEX 前缀续地皮,寄存器数量再翻倍)。每一年轮都没有推翻前一层——四十年的新增特性全部通过"在旧骨架上找出路"完成。
这份执拗的商业回报史无前例:数十年的二进制存量意味着 x86 软件资产是全球最大的不可迁移资产,兼容性从包袱(解码电路贵、历史设计拖后腿)翻转成护城河(换架构等于换资产)。它同时是真实的工程税:变长断句、前缀叠罗汉让前端功耗居高不下(5.1 节),厂商俱乐部(英特尔、AMD 与少数授权者)让生态单点依赖。近年 ARM 服务器芯片与 RISC-V 的冲击,冲击的不是 x86 的技术,而是这道护城河的租期——本节不预言结局,只提供量尺:看存量的迁移成本与新增负载的归属,比看单点跑分诚实得多。
前缀叠罗汉的账单:取指前端为何贵
变长编码的成本不是平均摊在每条指令上的,它集中砸在取指前端。前端要从字节流里断句——x86 指令没有长度字段,断句器得记住几十条"常见首字节对应的最长长度",先按最坏情况粗切,再由译码逐条修正;一旦撞上跨缓存行的指令,粗切作废重来。更麻烦的是会改长度的指令:历史上有一批指令带不带某位前缀长度不同,早期前端干脆把它们当作断句障碍整体放缓——这就是著名的"改长指令"问题,它在教材里只有一句话,在处理器设计者的性能清单里是一个专用条目。顺带一个实用冷知识:编译器为了把循环头对齐到利于取指的边界,会插入专门的填充空操作——从一字节的 0x90 到九字节的 0F 1F 84 00 00 00 00 00,反汇编时看到成片的长空操作不是浪费,是对齐的艺术。这些账单最终兑现成:同代工艺下,x86 前端的功耗与面积预算天然高于定长对手——这不是缺陷描述,是"兼容性护城河"在工程上的定价单。
前缀家族的层积用一张速查表收拢(从旧到新,每一代都在借地皮):
| 前缀 | 出生年代 | 管什么 |
|---|---|---|
| 66 与 67 | 80386 时代 | 切换操作数与地址宽度 |
| 段覆盖一族(2E 至 3E) | 8086 时代 | 临时改用非默认段寄存器 |
| F2 与 F3 | 80386 时代 | 串指令重复;后被 SSE 借作语义开关 |
| REX(40 至 4F) | x86-64 诞生 | 64 位宽度与寄存器号扩展 |
| VEX 与 EVEX | 2008 与 2013 | SIMD 新空间,顺带接管 REX 职能 |
容易踩的坑
第一个坑:以为 x86-64 的模式是"纯 64 位"。它保留了段机制的大部分外形(现代系统把段基址全设成零或拿 FS 与 GS 段寄存器专做线程局部存储与内核数据寻址)、保留了兼容模式跑 32 位代码、保留了实模式用于开机引导的头几步——一台现代 x86 开机后的头几毫秒,走的全是 1978 年的编码。读底层资料(引导、内核启动)时这些"活化石段"必须认识。第二个坑:拿指令字节数比性能。变长编码下字节数与执行代价严重非线性——一字节的 inc 在部分代际因部分标志位更新反而比三字节的对应指令慢;性能判断回归微操作数与依赖链(5.1、5.2 节的方法)。第三个坑:手工编码时无视指令长度上限。15 字节的硬顶在带齐前缀、SIB、位移、立即数的极端组合下真的会撞上,汇编器会拒绝或改写——写汇编器与做实验时要留神。
本节要点回顾
- 四把尺子的 x86 读数:变长前缀编码、CISC 访存立场、四环加 MSR 门禁、前缀借地皮扩展——彼此咬合、自洽四十年。
- 五字节解剖案例(REX、操作码、ModRM、SIB、位移)把第 3 章全部零件收进一条指令,值得亲手复拆。
- 年轮无推翻、特性全增补:兼容包袱翻转成全球最大的二进制资产护城河,同时支付前端复杂度与生态单点的工程税。
- 现代 x86 仍背着段机制外形、兼容模式与实模式启动——底层资料里全是活化石。
- 性能看微操作与依赖链,不看字节数;15 字节上限是真实约束。