1.1 核心概念与术语体系
1.1 核心概念与术语体系
本节摘要:基因操作与蛋白质工程共用一套以中心法则为骨架的词汇系统。本节把"序列—折叠—功能"的因果链立起来,给出双向施工的概念地图,并清理一批最容易混用的术语。
先把词汇表立起来
上一章末尾我们把领域分成了向下改碱基与向上改折叠两条作业面,本节的任务是在动土之前把词汇表立起来。术语不是行话装饰,它决定了你在读方案、写报告、开会吵架时能不能精确描述问题。生物领域里大量争论其实是同名不同义造成的:两个人都说"这个蛋白不表达",一个指的是裂解液里没有目标条带,另一个指的是有条带但没有活性——前者是表达问题,后者是折叠问题,处方完全不同。
一张图看懂双向施工的词汇骨架
图:从碱基到折叠的双向施工概念图
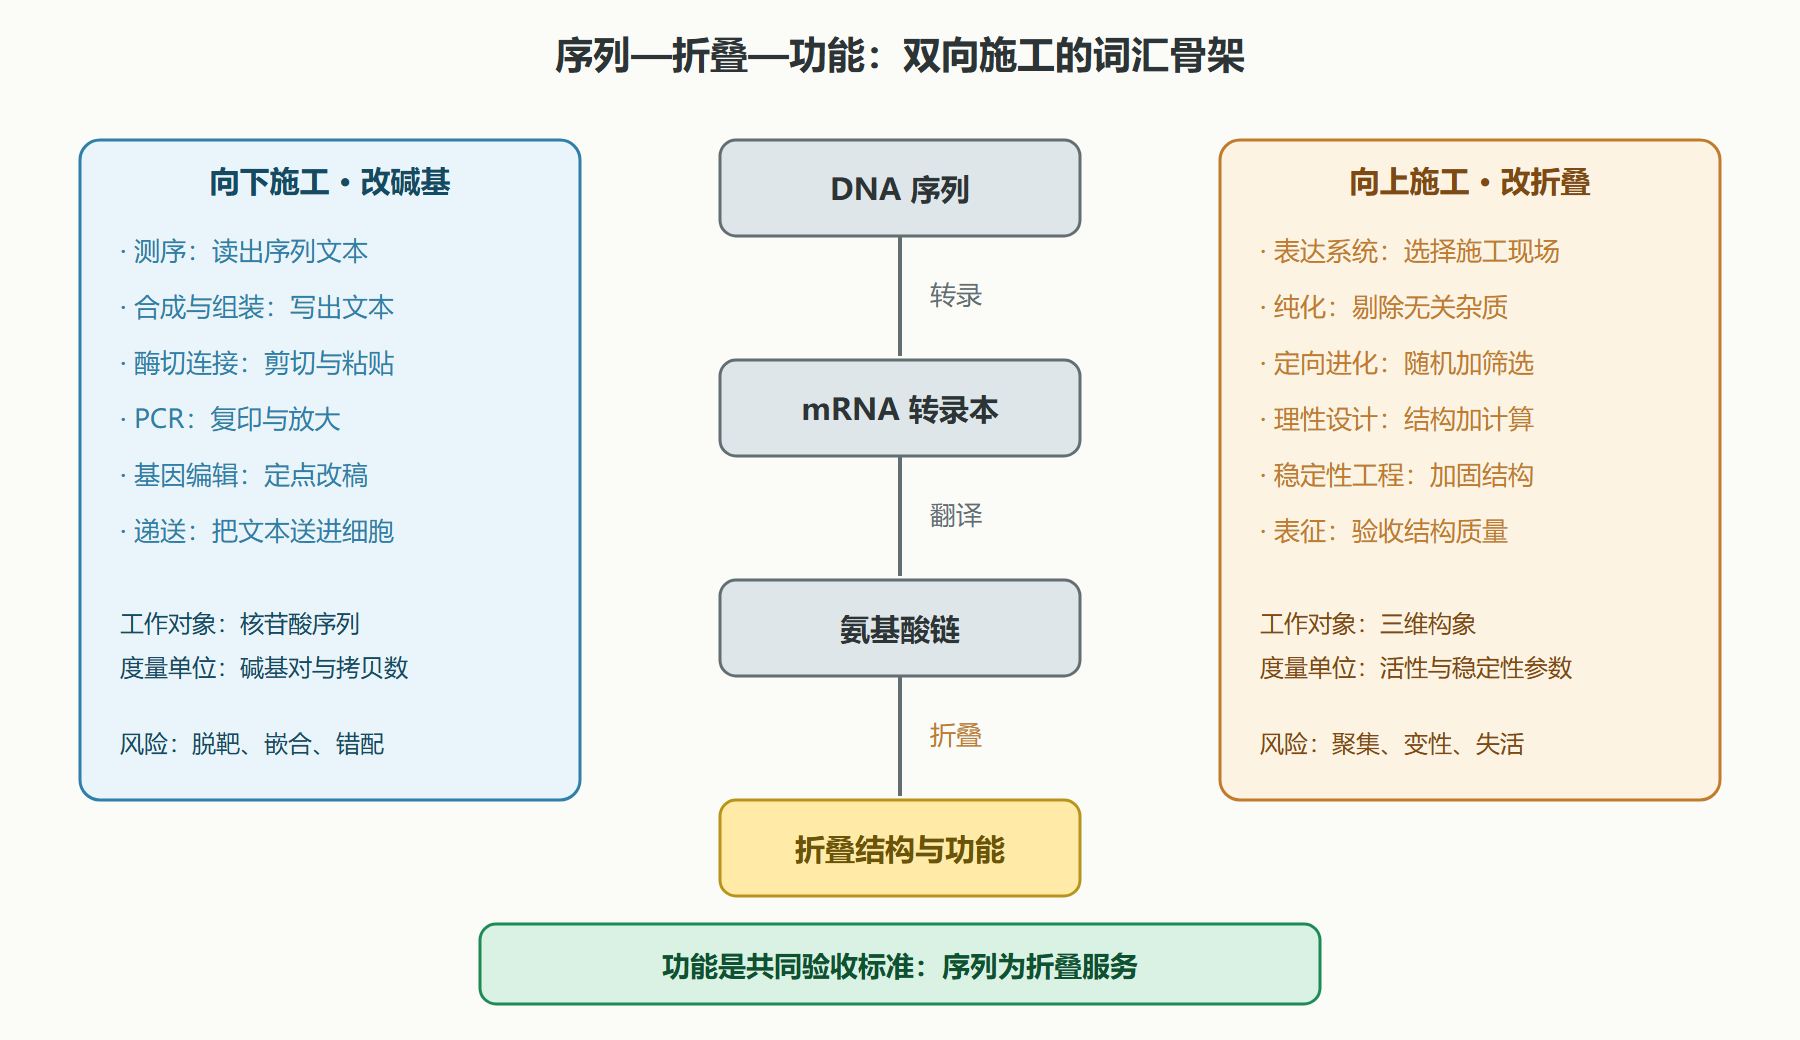
左侧是向下施工的工种清单,右侧是向上施工的。中间那根柱子是中心法则:DNA 转录成 RNA,RNA 翻译成氨基酸链,氨基酸链自发折叠成有功能的三维结构。注意折叠这一步在图上被特意标成了暖色——它不是简单的化学公式推导,而是一个至今没有完全破解的物理过程,这正是"向上施工"比"向下施工"更依赖筛选与经验的原因。
三组最容易混用的术语
基因型与表型。 基因型是你写进细胞的序列文本,表型是文本运行出来的可观察结果。改造成功与否只看表型,但改造动作全部作用在基因型上。新手最常见的失误是把基因型验证当成终点——测序对了,就以为任务完成了。序列正确只说明图纸无误,蛋白有没有折叠、有没有活性,要靠表型实验说话。
克隆与表达。 克隆指把目标序列装进载体并在细胞里复制出足够多的拷贝,关注的是 DNA 的量与纯度;表达指让这段序列被转录翻译成蛋白,关注的是蛋白的量与质量。"克隆对了吗"问的是测序峰图,"表达出来了吗"问的是电泳条带与活性。
构象与折叠。 折叠是链从一维走向三维的过程,构象是折叠后所处的具体三维状态。一个蛋白可以有多个构象状态(活性态、失活态、错误折叠态),变性指的是构象被破坏而共价结构尚在。说"蛋白变性了"和"蛋白降解了"是两回事:前者可以复性或换个条件,后者是肽链被剪断,救不回来。
| 术语对 | 前者关注 | 后者关注 | 混用后果 |
|---|---|---|---|
| 基因型 vs 表型 | 序列是否正确 | 功能是否实现 | 测序对了就收工,漏掉失活 |
| 克隆 vs 表达 | DNA 的量与纯度 | 蛋白的量与质量 | 把电泳空 lane 误判为克隆失败 |
| 折叠 vs 构象 | 过程 | 状态 | 把可逆变性当成不可逆降解 |
| 突变 vs 编辑 | 结果描述 | 操作方式 | 报告里无法追溯操作路径 |
| 拷贝数 vs 滴度 | 质粒 copies 每毫升 | 病毒感染单位每毫升 | 递送剂量算错一个数量级 |
用中心法则串起全部工种
把词汇表挂到中心法则上,每个工种的位置就固定了。提取与质控发生在样本进入系统之前;酶切连接、组装、编辑改变 DNA 文本;PCR 复制文本;测序读出文本;转录翻译发生在宿主细胞里;表达优化调节这一步的效率;纯化把目标蛋白从细胞裂解液中分离;表征与活性测定验收最终产品。定向进化比较特殊,它把"变异—筛选—扩增"整条链循环起来,横跨两个施工方向。
理解位置之后,你可以对任何一项新技术问一个定位问题:它作用在中心法则的哪一段?比如 base editing 作用在 DNA 文本的单个字母上,属于向下施工的精修工具;而专为改善折叠设计的突变库筛选,是向上施工。一个技术如果同时动两端——比如为了改变催化活性而改氨基酸、再回头优化密码子——就是典型的联合施工,第 5 章的主角。
演练:用序列换算验证你对"文本"的感觉
序列就是文本,这一点值得用一个小演算体感一下。下面这段计算把一条 DNA 编码序列翻译成氨基酸,并统计它的碱基组成——这正是你在设计任何构建前都该做的第一步核对:
# 演练:翻译一条编码序列并统计碱基组成 codon_table = { "TTT":"F","TTC":"F","TTA":"L","TTG":"L","TCT":"S","TCC":"S","TCA":"S","TCG":"S", "TAT":"Y","TAC":"Y","TAA":"*","TAG":"*","TGT":"C","TGC":"C","TGA":"*","TGG":"W", "CTT":"L","CTC":"L","CTA":"L","CTG":"L","CCT":"P","CCC":"P","CCA":"P","CCG":"P", "CAT":"H","CAC":"H","CAA":"Q","CAG":"Q","CGT":"R","CGC":"R","CGA":"R","CGG":"R", "ATT":"I","ATC":"I","ATA":"I","ATG":"M","ACT":"T","ACC":"T","ACA":"T","ACG":"T", "AAT":"N","AAC":"N","AAA":"K","AAG":"K","AGT":"S","AGC":"S","AGA":"R","AGG":"R", "GTT":"V","GTC":"V","GTA":"V","GTG":"V","GCT":"A","GCC":"A","GCA":"A","GCG":"A", "GAT":"D","GAC":"D","GAA":"E","GAG":"E","GGT":"G","GGC":"G","GGA":"G","GGG":"G", } seq = "ATGGCATACGGATTCGGCTAC" # 一条 21 个碱基的编码序列示例 # 按第一个 ATG 起始翻译(这里恰好从头开始) peptide = "" for i in range(0, len(seq) - len(seq) % 3, 3): aa = codon_table[seq[i:i+3]] peptide += aa print("翻译产物:", peptide) # 输出: MHGFGY gc = (seq.count("G") + seq.count("C")) / len(seq) print("GC 含量: %.1f%%" % (gc * 100)) # 输出: GC 含量: 52.4%
三个数字都值得咀嚼:翻译产物是 7 个氨基酸的小肽;GC 含量过半,属于大多数温和表达的水平;如果序列里出现终止密码子(表中星号),翻译会提前断掉——这就是为什么载体构建后必须测序验证,肉眼检查会漏掉的点,峰图不会。
易错点清单
- 把"基因合成"与"基因克隆"当成一回事:前者是无中生有地写出序列,后者是把已有片段装进载体。
- 认为 GC 含量越高越稳定所以越好:高 GC 区在 PCR 与测序中都是难点,适度才是美。
- 把密码子简并当成没有意义:同义密码子的使用偏好(密码子适应性)直接影响表达效率,第 3 章会展开。
- 用蛋白质名字指代基因:规范写法里基因名斜体、蛋白名正体,报告里混用会被审稿人圈出来。
本节要点回顾
- 中心法则是全册词汇的骨架,每个工种都能在"序列到折叠"的链条上找到坐标。
- 向下施工动核苷酸文本,向上施工动三维构象,功能是共同验收标准。
- 基因型对不等于表型对,测序通过只是中间验收,活性测定才是终验。
- 术语精确度决定协作效率:说清"不表达"到底是哪一环断了,能省掉整周的误会。
下一节我们把时间轴拉出来,看看这些工种是在什么样的死结与解结中逐代长出来的。