- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
「CRISPR」这个词,如今频繁出现在新闻标题里,却很少有人把它当作工种的名字来理解。本册想交给你的是一套施工队的视角:基因操作向下改写碱基序列,蛋白质工程向上改写折叠与功能,向下与向上彼此成就、互为表里。有了这套视角,零散的名词会自动各就各位——酶切连接好比放线开槽,聚合酶链式反应好比复印图纸,基因编辑是改稿,表达与纯化是浇筑打磨,定向进化靠试错摸索,理性设计靠画图推演。读完本册,你带走的不是名词的堆叠,而是一张能带进实验室、带进产线、带进评审会的施工图。
这本教程解决什么问题
围绕基因操作与蛋白质工程的中文资料不少,但大多分成两类:要么是教科书式的概念罗列,把限制酶、PCR、层析、定向进化平铺成孤立的词条;要么是新闻式的成果报道,把 AlphaFold 与基因治疗讲成魔法。两类材料都回答不了实践者真正的问题:手头的任务该从哪条作业面下手,改动碱基还是改动折叠,成本与风险落在哪里,验收时拿什么指标说话。
本册的做法是把整个领域组织成一座双向施工的现场。向下施工的部分回答"如何精确改写遗传文本":从 DNA 提取质控,到酶切连接与无缝组装,再到 PCR、基因编辑与递送。向上施工的部分回答"如何让序列变成有功能的分子":结构层级决定折叠逻辑,表达系统决定产量与可溶性,纯化策略决定制品质量,定向进化与理性设计则是拿到好蛋白的两只手。流水线平台、交叉作业面、应用验收、质量规范与未来边界,分别对应第 4 章到第 8 章。
全册知识地图
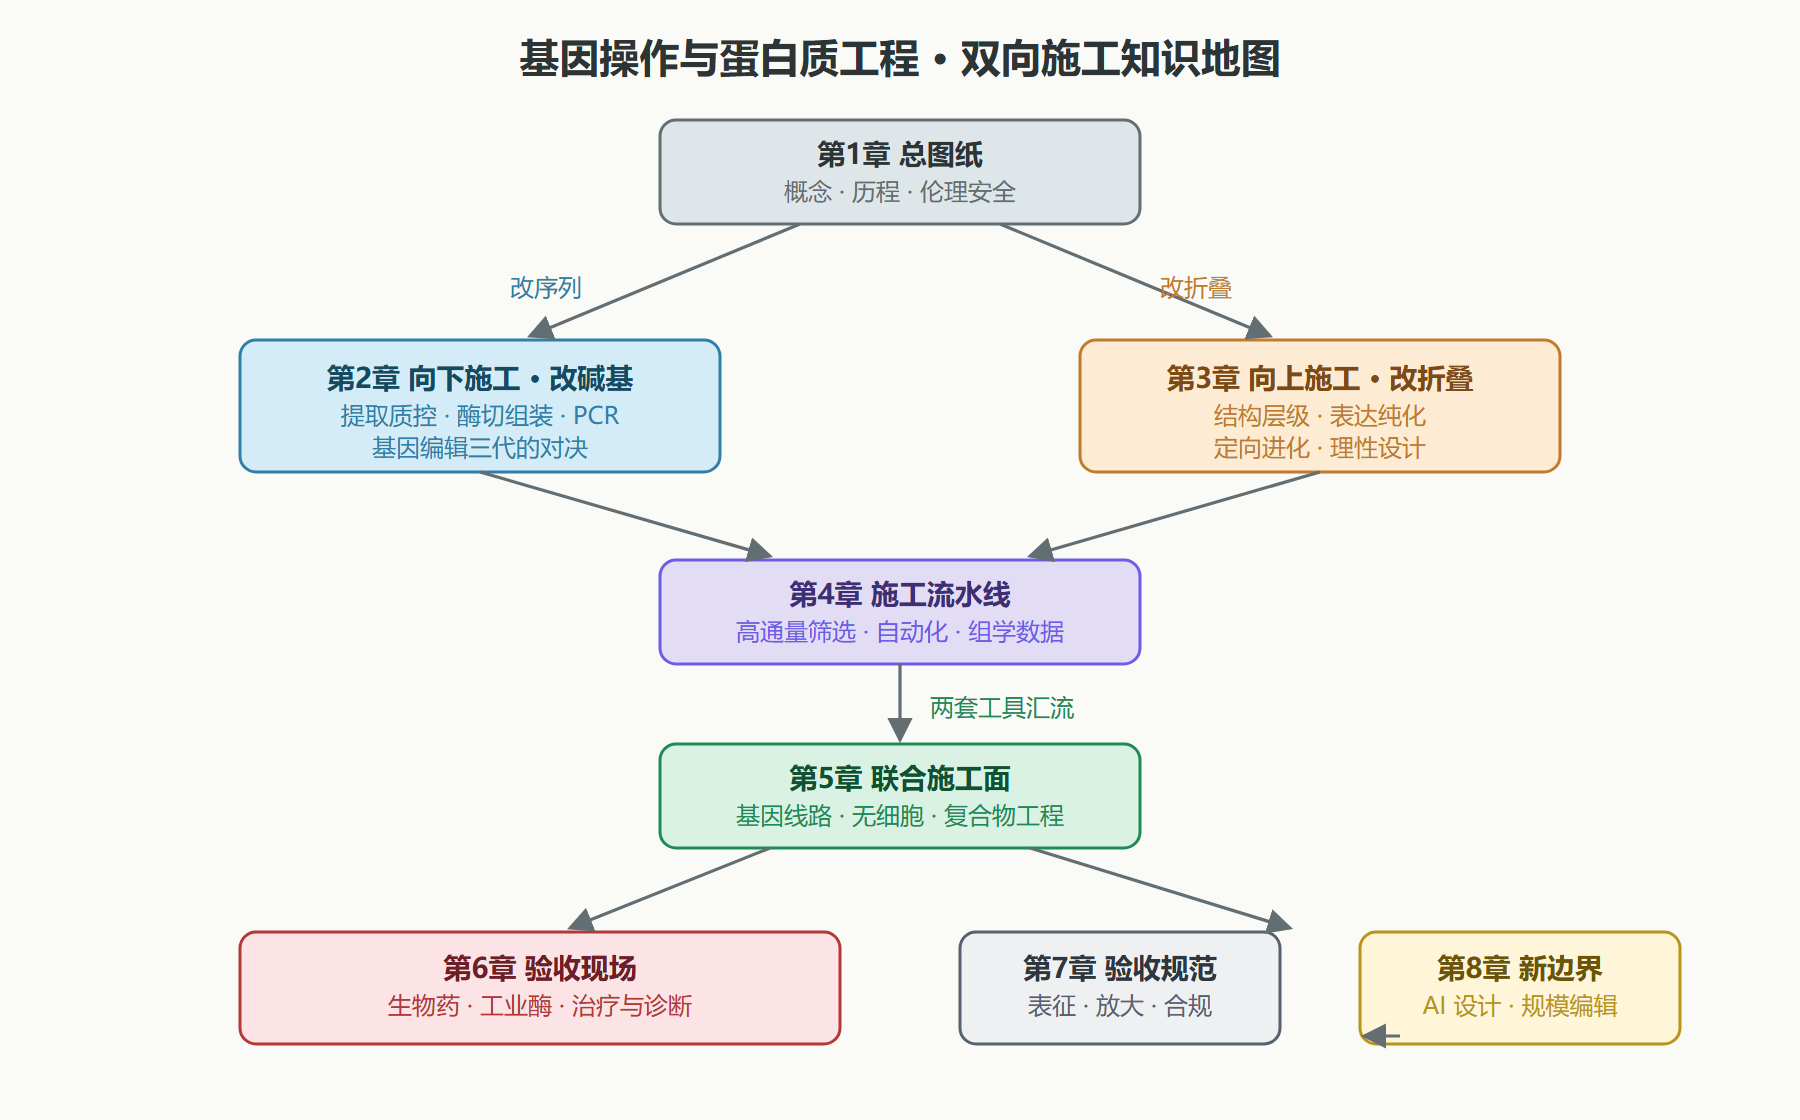
下图是全册的施工总平面。箭头表示学习依赖:总图纸先行,向下与向上两条作业面并进,流水线为两者提供通量,交叉作业面把两套工具焊接起来,最后进入应用验收与规范验收。
图:全册知识地图——双向施工路线与学习依赖
怎么读这本册子
按施工逻辑排布的章节顺序就是推荐阅读顺序。第 1 章给全景与规则,第 2、3 章是两根承重柱,建议成对阅读——读罢酶切连接就去看表达系统,你会发现载体设计的选择其实由下游蛋白的需求反向决定。第 4 章讲通量,解释为什么现代实验室更像车间。第 5 章是两根柱子之间的横梁,基因线路、无细胞体系、密码子扩展都在这里。第 6、7 章讲验收:应用现场看价值,质控规范看底线。第 8 章展望 AI 设计与更大尺度的编辑。
时间紧张的读者可以走最小路径:第 1 章 → 第 2.4 节(基因编辑)→ 第 3.4 节(定向进化)→ 第 6.3 节(基因治疗),这条路径串起了当下最热的落地场景。想在实验室动手的读者,第 2、3、7 章的操作细节与演算示例按原样可用的成分最高。
读完后你应当能做什么
- 拿到一个改造需求,判断它属于改序列、改折叠还是两者兼有,并给出技术路线。
- 读懂一张质粒图谱、一份酶切方案、一组 qPCR 数据背后的假设与陷阱。
- 为目标蛋白选择表达系统与纯化路径,并预估可溶性风险。
- 设计一轮定向进化或一轮理性设计迭代,说清库怎么建、怎么筛、怎么收敛。
- 用表征数据(电泳、质谱、动力学参数)支撑"这个构建是合格的"这一判断。
- 在伦理与合规框架内评估项目边界,知道哪些线不能碰。
一个提醒
这本册子里的演算示例——引物熔解温度、液滴装载概率、纯化收率、放大转速——都是可以拿计算器当场复核的。我们坚持"算得清才讲得清":生物系统的复杂性不豁免工程上的算术,反而更要求你在动手前把数量级先估出来。把每一节的演算亲手过一遍,比通读十遍更有用。
符号与读法约定
为省去反复查表,全册的单位与写法约定如下:浓度一律用摩尔每升的分数单位(毫摩尔、微摩尔、纳摩尔),序列长度用碱基对(bp)或千碱基(kb),蛋白分子量用千道尔顿(kDa),温度用摄氏度,活性单位用 U(每分钟转化一微摩尔底物)。交叉引用一律用章节号(如"详见第 3.4 节"),不依赖页码——电子阅读时页码是会骗人的。
读图表时也请带着一条约定:本册的对比表给出的是典型值与经验带,不是文献级精确数据。工程决策需要的是数量级与取舍方向,落地的具体参数必须在你自己的体系里实测校准——这也是每节末尾"易错点清单"反复出现"以实测为准"的原因。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...